Automatentheorie

Die vorliegenden Materialien wurden von Daniel Hoherz und André Tempel erstellt. Sollten andere Editoren die Materialien erstellt haben, werden diese explizit genannt.
Wie funktioniert ein „Automat“?
Es ist passiert. Sie waren auf einer längeren Geburtstagsparty, kommen früh morgens nach Hause und stellen erschrocken fest, dass Sie Ihren Schlüssel wohl zuhause vergessen haben!
Durch Klingeln scheint bei Ihnen zuhause niemand mehr wach zu werden. Da fällt Ihnen ein, dass Ihre Eltern kürzlich an Ihrem Garagentor ein smartes Schloss mit Keypad angebracht haben. Jede Person in Ihrer Familie hat eine eigene PIN, mit welcher man das Tor öffnen und schließen kann.
Ob Ihnen Ihre PIN noch einfällt, ist fraglich. Nach einigen erfolglosen Versuchen fragen Sie sich langsam, wie das System hinter dem Keypad eigentlich arbeitet.
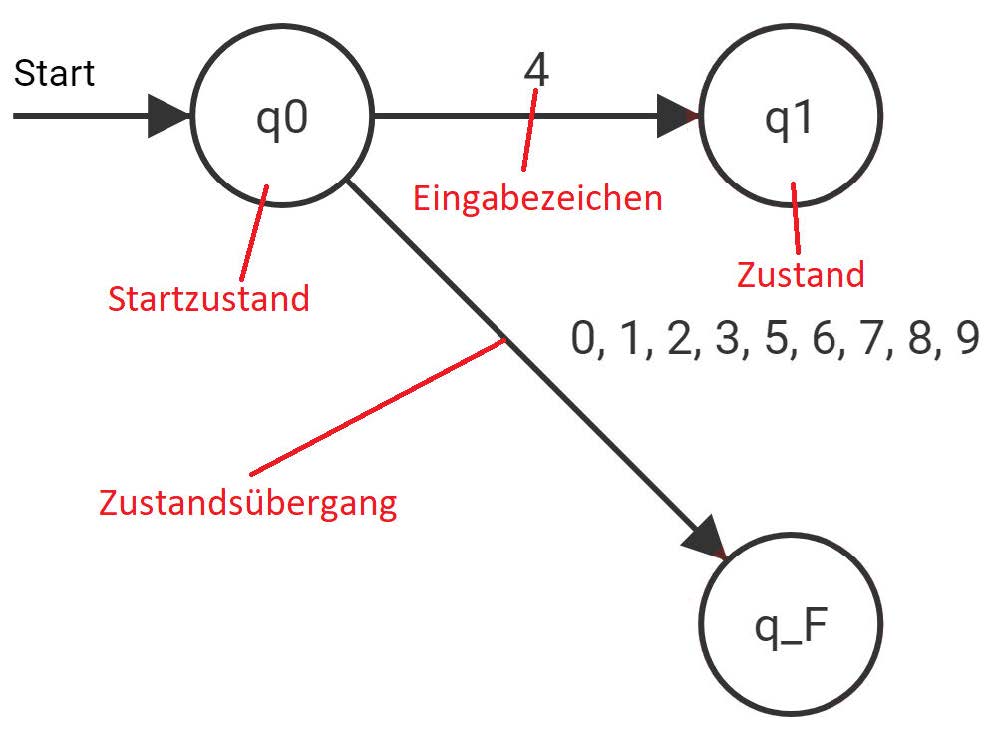
Eine PIN besteht aus vier Ziffern, welche nacheinander eingegeben werden. Zu jedem Zeitpunkt prüft das Keypad, ob die Eingabe teilweise korrekt ist.
Ist die PIN abschließend korrekt eingegeben, wird das Tor geöffnet, sollte es geschlossen sein, oder geschlossen, sollte es vorher geöffnet gewesen sein. Der Computer im Keypad bzw. Schloss verarbeitet die erste eingegebene Ziffer.
Angenommen, Ihre PIN hat als erste Ziffer eine 4.
Überlegen Sie gemeinsam, welchen Unterschied die Eingabe der Ziffer 4 im Vergleich zur Eingabe einer anderen Ziffer für den Computer darstellt.
Überlegen Sie, was sich der Computer nach der ersten Taste merken muss: Kann nach einer falschen ersten Ziffer (z. B. 1 oder 8) überhaupt noch eine gültige PIN entstehen?
Bei Eingabe der 4 hat der Benutzer den ersten Schritt zur richtigen PIN geschafft. Bei jeder anderen Ziffer ist die Chance auf eine korrekte PIN sofort verspielt.
Der Computer muss sich irgendwie merken, dass die erste Ziffer der Eingabe zur korrekten PIN führen könnte. Wenn nicht die Ziffer 4 eingegeben wird, muss sich der Computer merken, dass man auf keinen Fall mehr eine korrekte PIN eingeben kann.
Das „Merken“ wird in sogenannten Zuständen dargestellt und der Verarbeitungsprozess in einem Zustandsgraph:

Angenommen, Ihre PIN ist 4321.
Vervollständigen Sie den Zustandsgraphen für die vollständige vierstellige PIN 4321, indem Sie alle weiteren Eingabemöglichkeiten umsetzen und entsprechende Zustände und Zustandsübergänge ergänzen.
Fügen Sie für jede weitere korrekte Ziffer der PIN (3, dann 2, dann 1) einen neuen Zustand hinzu (\(q_2\), \(q_3\), \(q_4\)).
Überlegen Sie, wohin der Automat wechseln muss, wenn an Zustand \(q_1\), \(q_2\) oder \(q_3\) eine falsche Ziffer eingegeben wird.
a) Tauschen Sie sich über Ihren Zustandsgraphen aus und einigen Sie sich auf eine gemeinsame Lösung.
b) Ergänzen Sie die folgende Zustandsübergangstabelle anhand Ihres Zustandsgraphen. Zustandsübergänge in einen Fehlerzustand können Sie mit dem Zeichen – eintragen.
| Zustand | Eingabezeichen und Folgezustand | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | |
| \(q_0\) | – | – | – | – | \(q_1\) | – | – | – | – | – |
| \(q_1\) | ||||||||||
| \(q_2\) | ||||||||||
| \(q_3\) | ||||||||||
| \(q_4\) | ||||||||||
| \(q_F\) | ||||||||||
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Gesamtmusterlösung.
Musterlösung zu den Aufgaben 1 bis 3
Der Computer muss sich merken, dass die erste Ziffer der Eingabe zur korrekten PIN führen könnte. Wenn nicht die Ziffer 4 eingegeben wird, muss sich der Computer merken, dass man auf keinen Fall mehr eine korrekte PIN eingeben kann.
Das „Merken“ wird in sogenannten Zuständen dargestellt und der Verarbeitungsprozess in einem Zustandsgraph:
- Startzustand \(q_0\) → Eingabe
4→ Folgezustand \(q_1\) - Startzustand \(q_0\) → Eingabe
0, 1, 2, 3, 5, 6, 7, 8, 9→ Fehlerzustand \(q_F\)
Ablauf der korrekten Ziffernfolge:
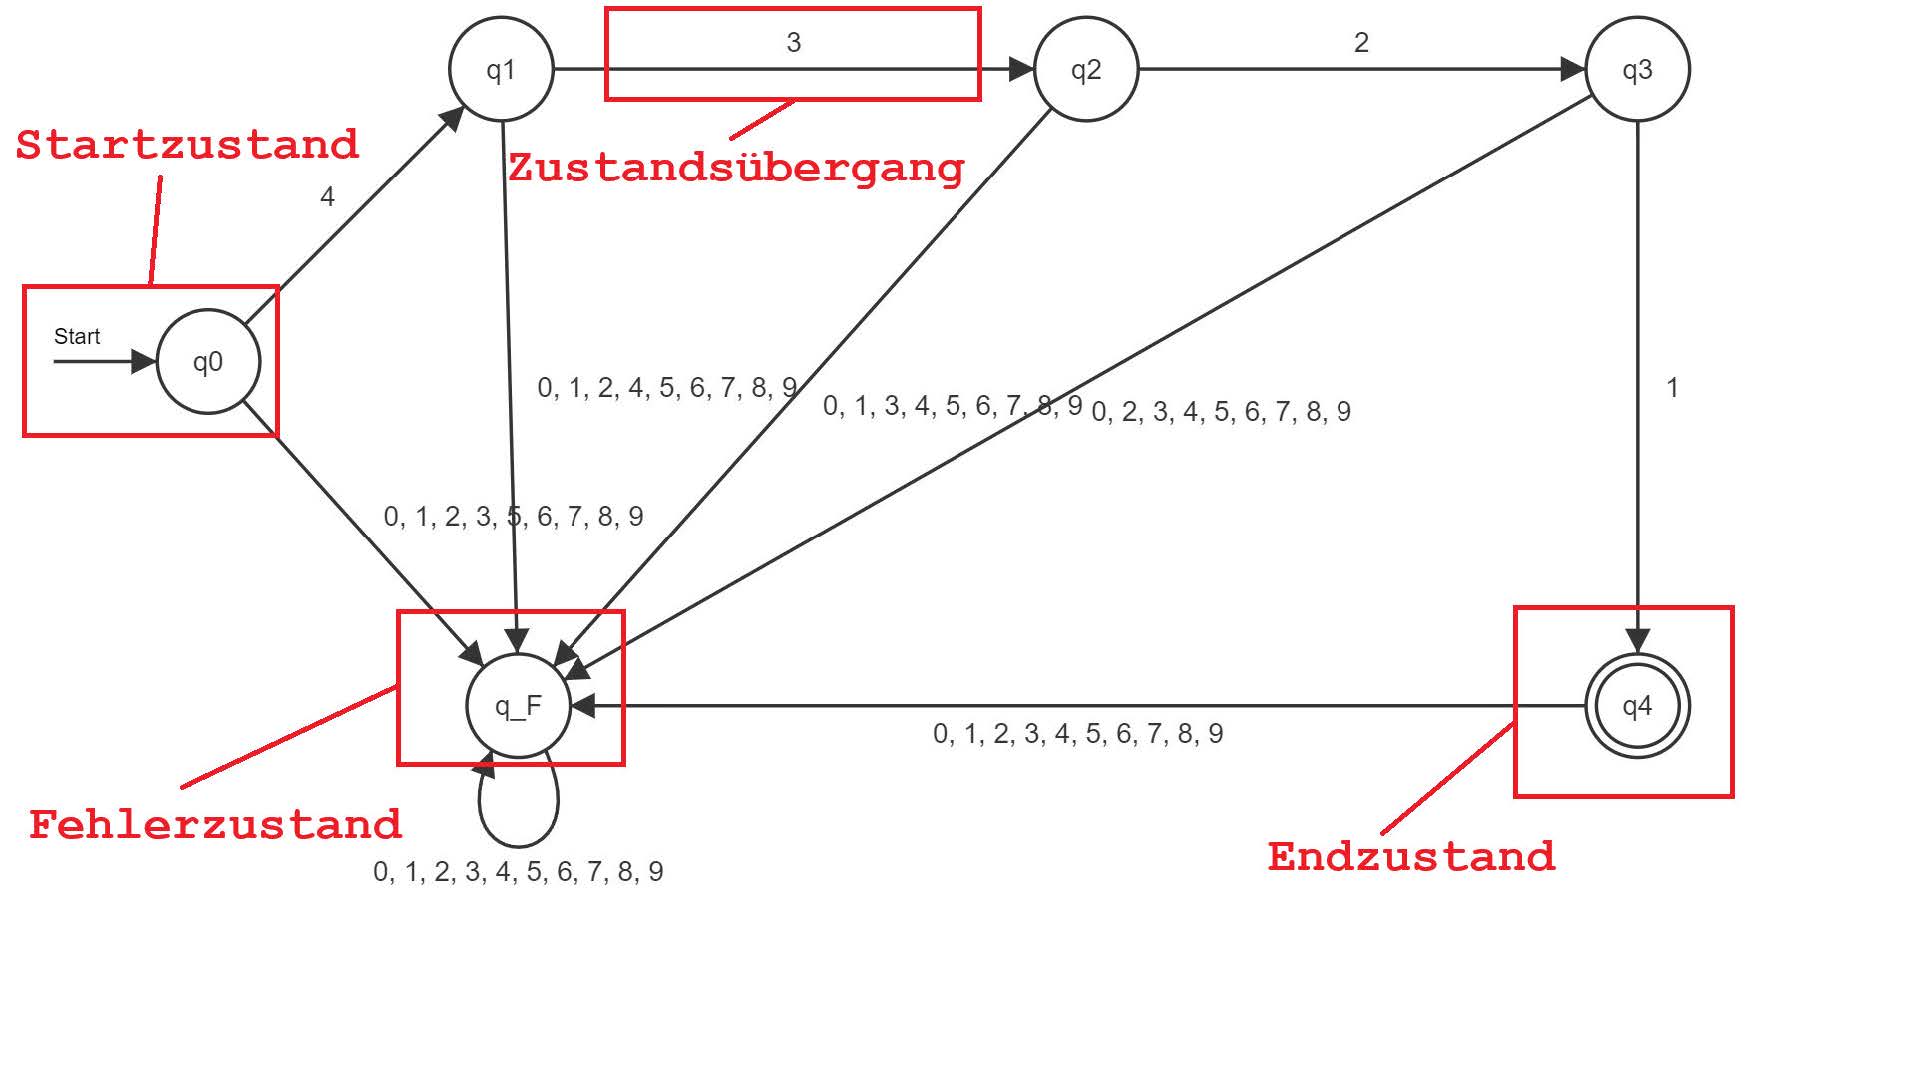
- \(q_0 \xrightarrow{\text{4}} q_1 \xrightarrow{\text{3}} q_2 \xrightarrow{\text{2}} q_3 \xrightarrow{\text{1}} q_4\) (Erfolgs- / Endzustand)
- Jede abweichende Ziffer auf diesem Pfad führt direkt in den Fehlerzustand \(q_F\).
- Einmal im Fehlerzustand \(q_F\) gelandet, führt jede weitere Tasteneingabe wieder nach \(q_F\) (Fehler bleibt bestehen).
| Zustand | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| \(q_0\) | – | – | – | – | \(q_1\) | – | – | – | – | – |
| \(q_1\) | – | – | – | \(q_2\) | – | – | – | – | – | – |
| \(q_2\) | – | – | \(q_3\) | – | – | – | – | – | – | – |
| \(q_3\) | – | \(q_4\) | – | – | – | – | – | – | – | – |
| \(q_4\) | – | – | – | – | – | – | – | – | – | – |
| \(q_F\) | – | – | – | – | – | – | – | – | – | – |
Hinweis: Das Zeichen „–“ steht stellvertretend für den Übergang in den Fehlerzustand \(q_F\).
Deterministische endliche Automaten
Auf fachlicher Ebene bezeichnet man das gesamte Szenario mit dem Keypad als deterministischen endlichen Automaten, kurz DEA.
Ein DEA ist ein sogenanntes 5-Tupel (also besteht er aus fünf Komponenten). Das 5-Tupel eines DEA besteht aus \((Q, \Sigma, \delta, s, F)\), wobei die einzelnen Komponenten wie folgt definiert sind:
| Definition | Keypad | |
|---|---|---|
| \(Q\) | \(Q\) ist eine nicht leere, endliche Menge von Zuständen, in denen sich der DEA befinden kann. | Bsp. beim Keypad: \(Q = \{q_0, q_1, q_2, q_3, q_4, q_F\}\) |
| \(\Sigma\) | \(\Sigma\) ist ein nicht leeres, endliches Eingabealphabet, also alles, was der Automat als Eingabezeichen erhalten kann. | Bsp. Keypad: \(\Sigma = \{0, \dots, 9\}\) |
| \(\delta\) | \(\delta\) ist die Übergangsfunktion, die jeder Kombination aus aktuellem Zustand und einem Eingabezeichen einen Folgezustand zuordnet. Diese Funktion stellt man mathematisch durch \(\delta: Q \times \Sigma \rightarrow Q\) dar. Die Übergangsfunktion kann in Form einer Tabelle angegeben werden. | Das bedeutet, dass einem Paar, z. B. \((q_0, 4)\) bei unserem Keypad ein Folgezustand, hier \(q_1\), zugeordnet wird: \((q_0, 4) \rightarrow q_1\). |
| \(s\) | \(s \in Q\) ist der Startzustand, in dem sich der DEA zu Beginn befindet. Achtung: Es ist immer nur ein Startzustand möglich. | Bsp. Keypad: \(s = q_0\). |
| \(F\) | \(F \subseteq Q\) ist die Menge der akzeptierenden Zustände, kurz Endzustände. Achtung, es darf auch mehrere Endzustände geben. Ein Wort wird akzeptiert, wenn sich der DEA nach dem Lesen des ganzen Wortes in einem Endzustand befindet. | Bsp. Keypad: \(F = \{q_4\}\). |
Der Zustandsgraph zum Zahlenschloss DEA sieht wie folgt aus:
Aufgaben
Arbeiten Sie die folgenden Aufgabenstellungen Schritt für Schritt durch. Nutzen Sie bei Bedarf die Fortschrittsanzeige, um Ihren Bearbeitungsstand festzuhalten.
Der Kontext und die grundlegende Idee der Aufgabe wurde von Lukas Köhl (Osnabrück, 2023) entworfen.
Im Osnabrücker Zoo hat die Direktorin ein modernes Schloss am Rüsselsspringergehege angebracht. Dieser Schritt wurde notwendig, da auch nicht berechtigte Mitarbeitende ständig die Rüsselsspringer streicheln wollten. Das Schloss wird über ein Keypad bedient.
Zunächst bekommen drei Mitarbeitende Zugang zum Gehege. Die drei Personen haben als PINs 1059, 3064 und 0159 erhalten. Das Schloss wartet, bis vier Ziffern eingegeben wurden und prüft anschließend, ob die Eingabe akzeptiert wird.
Entwerfen Sie einen DEA in Form eines Zustandsgraphen, welcher als Akzeptor der erlaubten Eingaben arbeitet. Geben Sie für Ihren DEA auch die formale Darstellung als 5-Tupel an.
Jeder Zustand steht für die bisher richtig eingegebenen Ziffern, z. B. „1 gelesen“, „10 gelesen“, „105 gelesen“. Zeichnen Sie zuerst den Pfad für 1059 und ergänzen Sie dann 3064 und 0159.
Nach „10“ und nach „01“ fehlt in beiden Fällen noch „59“. Diese beiden Pfade können deshalb ab der dritten Ziffer zusammenlaufen.
Q: alle Zustände einschließlich Fehlerzustand, Σ = {0, …, 9}, δ als Tabelle („–“ für Übergänge in den Fehlerzustand), s und F.
Damit auch bei anderen Tiergehegen der Zugang digital geregelt werden kann, sollen nun überall die neuen Schlösser mit Keypad angebracht werden. Die berechtigten Mitarbeitenden der Tierpflege können sich nun ihre PIN selbst aussuchen. Aus Sicherheitsgründen wird die Zusammensetzung einer erlaubten PIN verschärft.
Wählen Sie eine der folgenden drei Schwierigkeitsstufen aus:
| Standardvariante | Schwierige Variante | Schwere Variante |
|---|---|---|
Eine PIN muss aus mindestens drei und höchstens vier Ziffern bestehen und darf nicht die Ziffernfolge 123 beinhalten. | Eine PIN muss aus mindestens drei und höchstens fünf Ziffern bestehen und darf nicht die Ziffernfolge 123 beinhalten. | Eine PIN muss aus mindestens vier und höchstens sechs Ziffern bestehen und darf nicht die Ziffernfolge 1234 beinhalten. |
Arbeitsauftrag: Geben Sie je zwei strukturell verschiedene akzeptierte und nicht akzeptierte Eingaben an. Entwerfen Sie einen DEA in Form eines Zustandsgraphen, welcher als Akzeptor der erlaubten Eingaben arbeitet.
Zwei Dinge: wie viele Ziffern schon eingegeben wurden und wie weit die verbotene Folge schon begonnen hat.
Nach einer 1 ist die Folge 123 „eine Stelle weit“ begonnen, nach 12 zwei Stellen. Folgt dann eine 3, ist die PIN verboten. Folgt eine andere Ziffer, beginnt die Suche von vorn – es sei denn, die neue Ziffer ist selbst eine 1.
Endzustände sind alle Zustände mit erlaubter Länge, in denen die verbotene Folge nicht vorkam.
Wählen Sie eine der folgenden drei Schwierigkeitsstufen aus:
| Standardvariante | Schwierige Variante | Schwere Variante |
|---|---|---|
| Eine PIN muss aus mind. 3 und max. 4 Ziffern bestehen. Außerdem darf eine PIN nicht vier gleiche Ziffern beinhalten. Nur die Ziffern 1, 2, 3 oder 4 dürfen eingegeben werden. | Eine PIN muss aus mind. 3 und max. 5 Ziffern bestehen. Außerdem darf eine PIN nicht drei gleiche Ziffern hintereinander beinhalten (z. B. 11211 ist erlaubt, 21115 nicht). | Eine PIN muss aus mind. 4 und max. 6 Ziffern bestehen. Außerdem darf eine PIN nicht vier aufeinanderfolgende Ziffern in auf- oder absteigender Reihenfolge beinhalten. |
Arbeitsauftrag: Geben Sie je zwei strukturell verschiedene akzeptierte und nicht akzeptierte Eingaben an. Entwerfen Sie einen DEA in Form eines Zustandsgraphen, welcher als Akzeptor der erlaubten Eingaben arbeitet.
Die Anzahl der Ziffern und die zuletzt eingegebene Ziffer; je nach Variante auch, wie oft sie gerade hintereinander kam oder ob die letzten Ziffern auf- bzw. absteigend aufeinanderfolgen.
Der Graph wird schnell groß. Arbeiten Sie mit Kantenbeschriftungen wie „gleiche Ziffer“ und „andere Ziffer“ und zeichnen Sie gleichartige Teile nur einmal ausführlich.
Die Keypads werden verbessert. An einem Keypad können nun Ziffern, Klein- und Großbuchstaben sowie Sonderzeichen eingegeben werden.
Wählen Sie eine der folgenden drei Schwierigkeitsstufen aus:
| Standardvariante | Schwierige Variante | Schwere Variante |
|---|---|---|
| Ein erlaubtes Passwort muss mindestens aus vier Zeichen und mindestens zwei der vier Zeichenarten bestehen. | Ein erlaubtes Passwort muss mindestens aus vier Zeichen und mindestens drei der vier Zeichenarten bestehen. | Bearbeiten Sie zuerst die schwierigere Variante. Erläutern Sie, wie sich der DEA ändert, wenn ein sicheres Passwort aus mindestens acht Zeichen und allen Arten von Zeichen zusammengesetzt sein muss. |
Arbeitsauftrag: Geben Sie je zwei strukturell verschiedene akzeptierte und nicht akzeptierte Eingaben an. Entwerfen Sie einen DEA in Form eines Zustandsgraphen, welcher als Akzeptor der erlaubten Eingaben arbeitet.
Beschriften Sie Kanten mit der Zeichenart statt mit einzelnen Zeichen: Z (Ziffer), k (Kleinbuchstabe), G (Großbuchstabe), S (Sonderzeichen).
Welche Zeichenarten schon vorkamen und wie viele Zeichen schon eingegeben wurden. Ab der Mindestlänge ist die genaue Zahl egal.
Ein Zustand ist ein Paar (Länge, Menge der vorgekommenen Zeichenarten). Überlegen Sie, welche Paare überhaupt erreichbar sind.
Endliche Automaten können genutzt werden, um grammatikalische Strukturen oder bestimmte Wörter einer Sprache zu erkennen.
Entwerfen Sie den Zustandsgraphen eines DEA, der die Artikel der, die, das, den, dessen, deren und dem erkennt.
Alle Artikel beginnen mit d. Danach verzweigt der Graph: e (der, den, dem, dessen, deren), i (die) und a (das).
Wörter, die vollständig gelesen sind, können in einen gemeinsamen Endzustand führen. Achtung: „der“ ist ein Wort und zugleich der Anfang von „deren“.
Den Fehlerzustand dürfen Sie weglassen, wenn Sie dazuschreiben, dass alle fehlenden Übergänge dorthin führen.
Entscheiden Sie, welche der folgenden Mengen mögliche Eingabealphabete für endliche Automaten sind:
- \(\Sigma = \{1, 3, 5, 7, \dots\}\)
- \(\Sigma = \{\}\)
- \(\Sigma = \{A, B, 2, 4, +, -\}\)
- \(\Sigma = \{\pi, \sqrt{2}, 1\}\)
Ein Eingabealphabet muss endlich und nicht leer sein. Prüfen Sie jede Menge auf diese beiden Eigenschaften.
Welche Bedeutung ein Zeichen hat, spielt keine Rolle. Auch π oder √2 können einfach Zeichen sein.
Geben Sie ein geeignetes Eingabealphabet zu den folgenden Wörtern an. (Einzelne Wörter werden durch ein Komma getrennt):
- a, b, c
- AabBabB
- bbbb
- (a-b)*3
- 100011011
- IV, I, III, XII
- 8124
Sammeln Sie alle Zeichen, die in den Wörtern einer Zeile vorkommen. Jedes Zeichen kommt nur einmal in die Menge.
a und A sind verschiedene Zeichen. Auch Klammern, Rechenzeichen und das Komma innerhalb eines Wortes zählen mit; das Komma zwischen den Wörtern trennt nur.
Wir betrachten den folgenden Zustandsgraphen eines DEA:
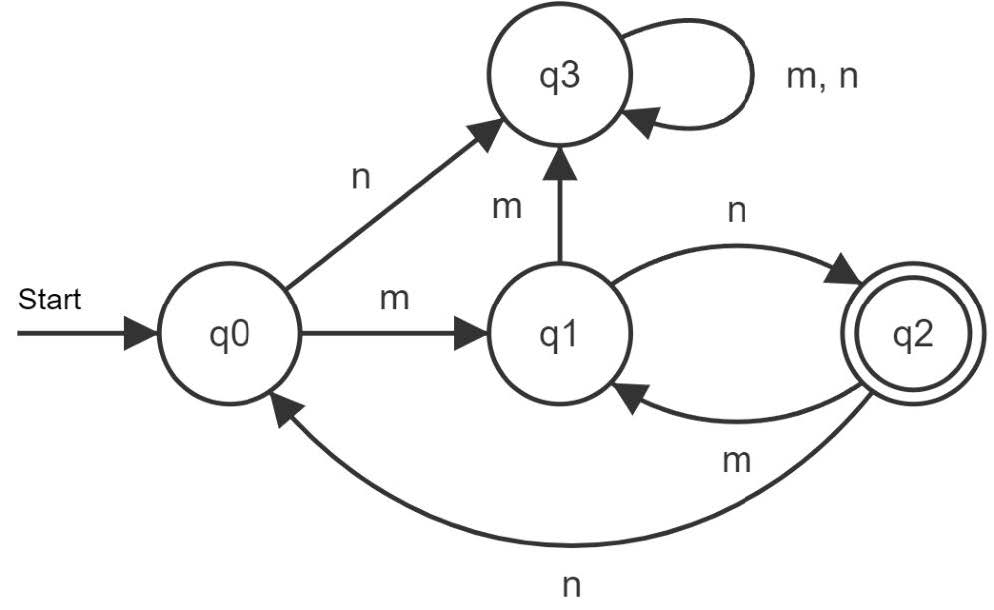
Geben Sie je zwei Wörter an, welche vom DEA akzeptiert bzw. nicht akzeptiert werden.
Folgen Sie vom Startzustand aus den Pfeilen, bis Sie in einem Endzustand sind. Die Kantenbeschriftungen ergeben ein akzeptiertes Wort.
Ein Wort wird nicht akzeptiert, wenn es in einem Zustand endet, der kein Endzustand ist, oder in den Fehlerzustand führt.
Beschreiben Sie möglichst präzise die Sprache, welche vom DEA akzeptiert wird.
Womit beginnt jedes akzeptierte Wort, womit endet es?
Welche Schleifen gibt es zwischen Endzustand und anderen Zuständen? Notieren Sie die Zeichenfolgen, die man auf diesen Rundwegen liest.
Geben Sie die formale Definition des DEA als 5-Tupel \((Q, \Sigma, \delta, s, F)\) an.
Gehen Sie das 5-Tupel der Reihe nach durch: Q, Σ, δ, s, F. Für δ legen Sie eine Tabelle mit einer Zeile je Zustand und einer Spalte je Zeichen an.
Jede Zelle der Tabelle muss gefüllt sein. Fehlt im Graphen ein Übergang, führt er in den Fehlerzustand.
Ein einfacher BluRay-Player hat die Funktionen „Ruhe“, „Film läuft“ und „Schneller Vorlauf“ sowie die Tasten „Play“, „Forward“ und „Stop“. Zu Beginn ist der Player in Ruhe. Der Player soll als Akzeptor modelliert werden: Akzeptiert werden genau die Tastenfolgen, nach denen der Film läuft.
Entwerfen Sie ein Modell des Players als DEA in Form eines Zustandsgraphen. Geben Sie je zwei akzeptierte und nicht akzeptierte Tastenfolgen an.
Die drei Funktionen sind die Zustände, die drei Tasten die Eingabezeichen.
Legen Sie für jeden Zustand und jede Taste fest, was passiert. Bewirkt eine Taste nichts, zeichnen Sie eine Schleife.
Akzeptiert werden die Tastenfolgen, nach denen der Film läuft. Welcher Zustand ist also Endzustand?
Gegeben ist der folgende DEA:
\(\Sigma = \{a, b\}\)
\(s = q_0\)
\(F = \{q_0\}\)
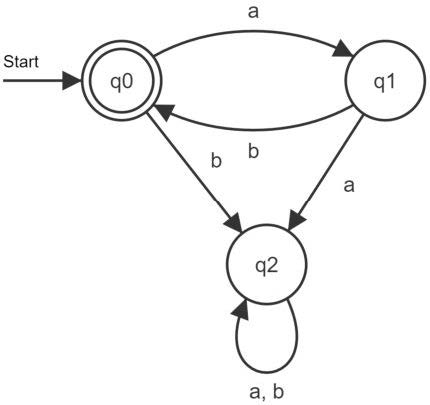
Ermitteln Sie die vom DEA akzeptierte Sprache und erläutern Sie die Bedeutung der einzelnen Zustände.
Probieren Sie die kürzesten Wörter aus: ε, a, b, ab, ba, aa … Welche werden akzeptiert?
Formulieren Sie für jeden Zustand, was bis dahin gelesen wurde, z. B. „ein a wurde gelesen, es fehlt noch …“. Gibt es einen Zustand, aus dem man nie mehr herauskommt?
Die Sprache \(L_{\text{ung}}\) mit dem Alphabet \(\{0, 1\}\) besteht aus Wörtern, die nur aus den Ziffern 0 und 1 bestehen. Die Anzahl der Ziffer 1 in jedem Wort muss aber stets ungerade sein. Zum Beispiel sind 01101 und 11100011 Wörter von \(L_{\text{ung}}\), aber 0101 und 1000001 nicht.
Entwerfen Sie den Zustandsgraphen eines DEA, der die Sprache \(L_{\text{ung}}\) erkennt. Überprüfen Sie Ihren DEA mit einigen Eingaben.
Nicht die genaue Anzahl der Einsen, sondern nur, ob sie bisher gerade oder ungerade ist.
Was ändert eine 1 an dieser Information, was ändert eine 0?
Erstellen Sie für die folgenden Sprachen je einen Zustandsgraphen eines deterministischen endlichen Automaten, welcher die jeweilige Sprache erkennt:
\(L = \{w \mid w \text{ beinhaltet das Teilwort } 010\}\)
Die Zustände merken sich, wie viel von 010 schon gelesen wurde: nichts, „0“, „01“, „010“.
Wird die Folge unterbrochen, beginnt sie nicht immer ganz von vorn: Nach „01“ und einer weiteren 1 ist nichts von 010 begonnen, nach „0“ und einer weiteren 0 aber schon wieder „0“.
Ist 010 einmal gelesen, wird das Wort auf jeden Fall akzeptiert. Der Endzustand bekommt also eine Schleife für 0 und 1.
\(L = \{w \mid w \text{ beinhaltet höchstens dreimal } 1\}\)
Die Zustände zählen die Einsen: 0, 1, 2, 3 und „mehr als 3“. Welche davon sind Endzustände?
Eine 0 ändert die Anzahl der Einsen nicht.
\(L = \{w \mid w \text{ beinhaltet eine gerade Anzahl von } 1\}\)
Vergleichen Sie mit Aufgabe 7. Was ändert sich, wenn die Anzahl gerade statt ungerade sein soll?
Gegeben sind die Zustandsgraphen von zwei DEA:
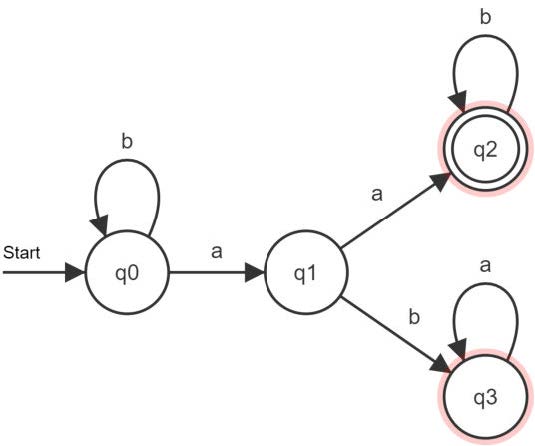
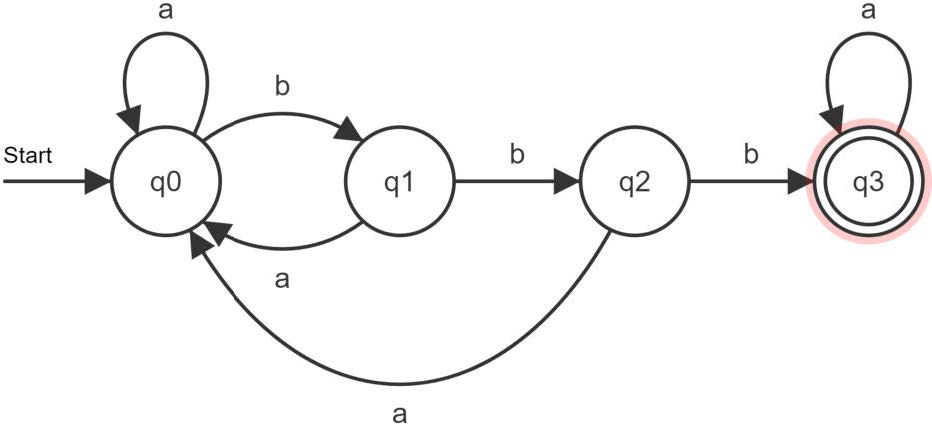
Erstellen Sie die formalen Definitionen der DEA als 5-Tupel \((Q, \Sigma, \delta, s, F)\).
Gehen Sie für jeden DEA das 5-Tupel der Reihe nach durch: Q, Σ, δ (als Tabelle), s, F.
Fehlt im Graphen ein Übergang, tragen Sie „–“ für den Fehlerzustand ein und vermerken das unter der Tabelle.
Geben Sie zu beiden DEA jeweils zwei Wörter an, die akzeptiert und zwei, die nicht akzeptiert werden.
Suchen Sie einen Weg vom Start- zu einem Endzustand und lesen Sie die Kantenbeschriftungen ab.
Ändern Sie ein akzeptiertes Wort an einer Stelle und prüfen Sie, wo der DEA dann endet.
Geben Sie die jeweils akzeptierte Sprache entweder beschreibend oder in einer geschlossenen Form mit \(L = \{\dots\}\) an.
Untersuchen Sie, welche Zeichenfolgen zum Endzustand führen und welche Schleifen es unterwegs gibt.
Gibt es einen Zustand, von dem aus kein Endzustand mehr erreichbar ist? Er wirkt wie ein Fehlerzustand.
Eine Beschreibung in Worten ist erlaubt. Für die Mengenschreibweise helfen Potenzen wie \(b^n\) für „n-mal b“.
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Musterlösung zu den Aufgaben 1 bis 9
In den Graphen ist der Fehlerzustand nicht eingezeichnet: Jeder fehlende Übergang führt in den Fehlerzustand. Andere richtige Lösungen, z. B. mit mehr Zuständen, sind möglich. Prüfen Sie Ihren eigenen Automaten mit den angegebenen Beispielwörtern.
Zu Aufgabe 1
a) Minimaler DEA (9 Zustände):
PINs 1059, 3064 und 0159
\(Q = \{q_0, \dots, q_8, q_F\}\), \(\Sigma = \{0, \dots, 9\}\), \(s = q_0\), \(F = \{q_8\}\). δ: Die Übergänge im Graphen; alle übrigen Paare (Zustand, Ziffer) führen nach \(q_F\), ebenso alle Übergänge aus \(q_F\).
b) Standard (3–4 Ziffern, ohne 123):
- akzeptiert: 4711, 120;
- nicht akzeptiert: 12 (zu kurz), 0123 (enthält 123), 77777 (zu lang).
b) Standard: 9 Zustände
b) Schwierig (3–5 Ziffern, ohne 123):
- akzeptiert: 12124, 999;
- nicht akzeptiert: 41235, 123456.
b) Schwierig: 12 Zustände
b) Schwer (4–6 Ziffern, ohne 1234):
- akzeptiert: 12312, 12354;
- nicht akzeptiert: 901234 (enthält 1234), 123 (zu kurz).
b) Schwer: 16 Zustände
c) Standard (Ziffern 1–4, 3–4 Ziffern, nicht vier gleiche):
- akzeptiert: 112, 4441;
- nicht akzeptiert: 3333, 125 (5 nicht erlaubt), 12.
c) Standard: 16 Zustände; Zustände merken sich Länge, letzte Ziffer und Wiederholung
c) Schwierig (3–5 Ziffern, keine drei gleichen Ziffern hintereinander): Der minimale DEA hat 63 Zustände, weil er sich zusätzlich die letzte Ziffer merken muss. Im Schema steht ein Zustand „Länge | x“ (letzte Ziffer einmal) bzw. „Länge | xx“ (letzte Ziffer zweimal) für zehn echte Zustände, je einen pro letzter Ziffer.
- akzeptiert: 11211, 90909;
- nicht akzeptiert: 51112, 12, 121212.
c) Schwierig als Schema: „gleiche“ = gleiche Ziffer wie zuvor, „andere“ = andere Ziffer
c) Schwer (4–6 Ziffern, keine vier aufeinanderfolgenden Ziffern auf- oder absteigend): Der minimale DEA hat 110 Zustände. Das Schema merkt sich die Länge und den laufenden Trend: · (kein Trend), ↑2/↑3 (zwei bzw. drei Ziffern aufsteigend um je 1), ↓2/↓3 (absteigend). Die Kante „+1“ bedeutet: Die neue Ziffer ist um 1 größer als die vorige.
- akzeptiert: 1243, 135790, 8790;
- nicht akzeptiert: 51234, 98760, 123.
c) Schwer als Schema mit 25 Zuständen
d) Eingabezeichen sind hier die Zeichenarten: z (Ziffer), k (Kleinbuchstabe), g (Großbuchstabe), s (Sonderzeichen).
Standard (mindestens 4 Zeichen, mindestens 2 Zeichenarten):
- akzeptiert: abc1, Haus;
- nicht akzeptiert: abcd, a1.
d) Standard: 16 Zustände
Schwierig (mindestens 4 Zeichen, mindestens 3 Zeichenarten):
- akzeptiert: Ab1c, x!9Y;
- nicht akzeptiert: abc1, A1!.
d) Schwierig: 23 Zustände
Schwer: Für mindestens 8 Zeichen und alle vier Zeichenarten muss sich der DEA die Länge (0 bis 8, danach egal) und die Menge der bereits vorgekommenen Zeichenarten merken. Ein Zustand ist also ein Paar (Länge, Menge). Der minimale DEA hat 76 Zustände, ohne Fehlerzustand, denn jede Eingabe kann noch zu einem gültigen Passwort ergänzt werden. Erwartet wird diese Begründung, kein vollständiger Graph.
Zu Aufgabe 2
Artikel-DEA (10 Zustände); Endzustände nach der, die, das, den, dem, dessen, deren
\(\Sigma = \{a, d, e, i, m, n, r, s\}\). \(q_5\) ist der gemeinsame Endzustand für das, die, den, dem, dessen und deren, \(q_6\) der Endzustand für „der“ und zugleich Durchgang zu „deren“. Fehlende Übergänge führen in den Fehlerzustand.
Zu Aufgabe 3
a)
- (1) ist kein Alphabet, denn die Menge ist unendlich.
- (2) ist kein Alphabet, denn die Menge ist leer.
- (3) und (4) sind Alphabete: endlich und nicht leer. π und √2 sind hier einfach Zeichen.
b) Mögliche kleinste Alphabete; größere sind ebenfalls geeignet:
- (1) \(\{a, b, c\}\);
- (2) \(\{a, b, A, B\}\);
- (3) \(\{b\}\);
- (4) \(\{a, b, -, *, (, ), 3\}\) bzw. allgemeiner \(\{a, b, +, -, *, /, (, ), 0, \dots, 9\}\);
- (5) \(\{0, 1\}\);
- (6) \(\{I, V, X\}\), allgemeiner mit L, C, D, M;
- (7) \(\{0, \dots, 9\}\).
Zu Aufgabe 4
a)
- akzeptiert: mn, mnmn, mnnmn;
- nicht akzeptiert: n, mm, mnn, nmnmnnm.
b) Jedes Wort beginnt mit mn. Danach folgen beliebig viele Blöcke „mn“ oder „nmn“. Also beginnt jedes Wort mit m und endet mit n, nie stehen zwei m hintereinander, und es stehen nie mehr als zwei n hintereinander. Kurz: \(L = \{\,mn\,w \mid w \text{ besteht aus beliebig vielen Blöcken } mn \text{ oder } nmn\,\}\).
c) \(Q = \{q_0, q_1, q_2, q_3\}\), \(\Sigma = \{m, n\}\), \(s = q_0\), \(F = \{q_2\}\).
| δ | m | n |
|---|---|---|
| \(q_0\) | \(q_1\) | \(q_3\) |
| \(q_1\) | \(q_3\) | \(q_2\) |
| \(q_2\) | \(q_1\) | \(q_0\) |
| \(q_3\) | \(q_3\) | \(q_3\) |
\(q_3\) ist der Fehlerzustand.
Zu Aufgabe 5
BluRay-Player als Akzeptor; jede Taste ist in jedem Zustand definiert, Endzustand ist „Film läuft“
Ein vollständiges Modell legt für jede Taste in jedem Zustand fest, was passiert. Forward im Zustand „Ruhe“ bewirkt hier nichts (Schleife).
\(Q\) = {Ruhe, Film läuft, Schneller Vorlauf}, \(\Sigma\) = {Play, Forward, Stop}, \(s\) = Ruhe, \(F\) = {Film läuft}.
Akzeptiert werden z. B. Play und Play Forward Play, nicht akzeptiert z. B. Play Stop und Play Forward. Auch die leere Tastenfolge wird nicht akzeptiert, denn der Player steht dann in Ruhe.
Zu Aufgabe 6
Akzeptiert werden das leere Wort und alle Wörter, die aus beliebig vielen Blöcken „ab“ bestehen: \(L = \{(ab)^n \mid n \in \mathbb{N}_0\}\).
- \(q_0\): Bisher wurden nur vollständige Blöcke ab gelesen, oder das Wort ist leer (Endzustand).
- \(q_1\): Ein a wurde gelesen, es wird auf b gewartet.
- \(q_2\): Fehlerzustand, das Wort kann nicht mehr korrekt werden.
Beispiele: akzeptiert ε, ab, abab; nicht akzeptiert a, ba, aab.
Zu Aufgabe 7
L_ung: q1 = bisher ungerade viele Einsen
Test: 01101 und 11100011 enden in q1 (akzeptiert), 0101 und 1000001 in q0 (nicht akzeptiert).
\(q_0\): bisher gerade viele Einsen (auch keine), \(q_1\): bisher ungerade viele Einsen. Eine 1 wechselt den Zustand, eine 0 nicht.
Zu Aufgabe 8
a) Teilwort 010
b) höchstens dreimal 1
c) gerade Anzahl von 1
Zu Aufgabe 9
a) Beide DEA: \(Q = \{q_0, q_1, q_2, q_3\}\), \(\Sigma = \{a, b\}\), \(s = q_0\). Links ist \(F = \{q_2\}\), rechts \(F = \{q_3\}\). In den Tabellen bedeutet „–“ einen Übergang in den Fehlerzustand.
| δ (DEA 1) | a | b | δ (DEA 2) | a | b |
|---|---|---|---|---|---|
| \(q_0\) | \(q_1\) | \(q_0\) | \(q_0\) | \(q_0\) | \(q_1\) |
| \(q_1\) | \(q_2\) | \(q_3\) | \(q_1\) | \(q_0\) | \(q_2\) |
| \(q_2\) | – | \(q_2\) | \(q_2\) | \(q_0\) | \(q_3\) |
| \(q_3\) | \(q_3\) | – | \(q_3\) | \(q_3\) | – |
b)
- DEA 1: akzeptiert baa, aab; nicht akzeptiert ab, bababa.
- DEA 2: akzeptiert ababbba, bbb; nicht akzeptiert a, bbaba.
c)
- DEA 1: \(L = \{b^n\,aa\,b^m \mid n, m \in \mathbb{N}_0\}\), also beliebig viele b, dann genau zwei a, dann beliebig viele b.
- DEA 2: Wörter, in denen „bbb“ vorkommt und nach dem ersten Vorkommen nur noch a folgen: \(L = \{u\,bbb\,a^n \mid n \in \mathbb{N}_0,\ u \text{ enthält kein } bbb \text{ und endet nicht auf } b\}\). Dabei darf u auch leer sein.
Von \(q_3\) aus ist bei DEA 1 kein Endzustand mehr erreichbar. Dieser Zustand wirkt also wie ein Fehlerzustand.
Anschauliche Formulierung für DEA 2: Die b stehen in Gruppen. Alle Gruppen außer der letzten sind höchstens zwei b lang, die letzte ist genau drei b lang, und danach folgen nur noch a.
Implementierung eines DEA in Java
gAeA Aufgabe 5 nur eA
Nun konstruieren wir eine algorithmische Umsetzung eines DEA in Java. Konkret betrachten wir den folgenden DEA, der Wörter über dem Eingabealphabet \(\Sigma = \{m, n\}\) verarbeitet:
Einstieg: Ein DEA als Datenstruktur
gA Vergleich mit den linearen ADT (Stack, Queue, DynArray): Unter den bisher betrachteten ADT gibt es keinen direkten Vergleich. Es gibt aber einige Gemeinsamkeiten mit den linearen ADT:
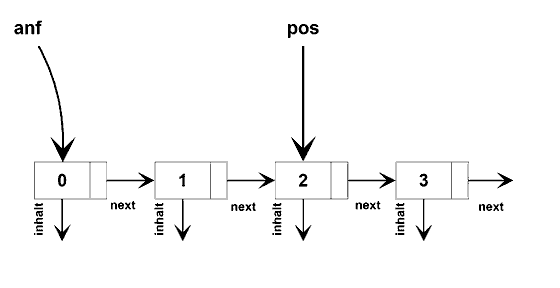
- Gemeinsamkeiten: Zustände beim DEA entsprechen den Elementen der linearen ADT. Zustandsübergänge zu weiteren Zuständen entsprechen den Verweisen auf Nachfolgeelemente.
- Unterschiede: Es gibt mehr als einen Nachfolger → die neue Datenstruktur ist nicht-linear. Die Verweise beim Zustandsgraphen haben eine zusätzliche Information, das Eingabezeichen für den Zustandsübergang.
eA Vergleich mit dem Binärbaum: Als Vergleich kommt nur ein Baum in Frage, hier ein Binärbaum, bei dem die Richtungen der Verweise eingezeichnet sind.
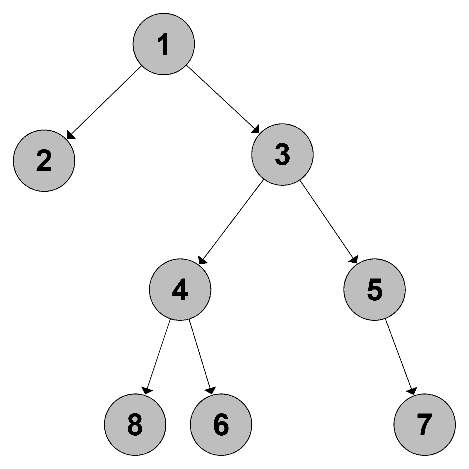
- Gemeinsamkeiten: Zustände beim DEA entsprechen den Knoten beim BinTree, Zustandsübergänge den Verweisen auf Nachfolgeknoten. Es kann mehr als einen Nachfolger geben → die Datenstruktur ist auch nicht-linear.
- Unterschied: Die Verweise beim Zustandsgraphen haben eine zusätzliche Information, das Eingabezeichen für den Zustandsübergang.
Modellierung mit den Klassen State und Transition
Die Zustände (Knoten) bilden eine eigene Klasse State. Die Übergänge werden in einer eigenen Klasse Transition modelliert. Der DEA als solcher wird in einem Programm DEATest zusammengefügt. Das Klassendiagramm ist unten abgebildet.
Ein Objekt der Klasse State soll zunächst die folgenden Operationen ausführen können:
- Ändern können, ob es ein Endzustand ist.
- Ein Objekt der Klasse
Transitionan sich anfügen können, wobei die Transition und der Name der anzufügenden Transition als String übergeben werden. - Mit einem übergebenen Zeichen einen Folgezustand ermitteln und diesen zurückgeben können.
- Antworten können, ob es ein Endzustand ist.
Aufgaben zur Implementierung eines DEA
Aufgaben mit dem Zusatz „optional“ zählen nicht für die Fortschrittsanzeige. Bei Aufgabe 5 genügt eine der beiden Varianten.
Die Klasse State wird die Klasse Transition beinhalten. Kopieren Sie die unvollständige Implementierung der Klasse State_unfertig und sichten Sie diese. Vervollständigen Sie die Operationen im Quellcode und benennen Sie die Klasse anschließend in State um.
public class State_unfertig {
Transition t1;
Transition t2;
boolean end = false;
public void changeEnd() {
// changeEnd soll den aktuellen Wert von end umschalten.
}
public void setTransition(String s, Transition t) {
// setTransition soll, wenn der übergebene Name t1 ist, die Transition t
// t1 zuweisen, ansonsten t2.
// Schwieriger: Beachten Sie, dass auch "falsche" Eingaben gemacht werden könnten.
}
public State nextState(char c) {
// In Abhängigkeit des übergebenen Eingabezeichens soll der Folgezustand
// zurückgegeben werden.
// Schwieriger: Beachten Sie, dass auch "falsche" Eingaben gemacht werden könnten.
}
public boolean getEnd() {
// Es soll zurückgegeben werden, ob der State ein Endzustand ist.
}
}
class Transition {
State folge;
char eingabe;
public Transition(State s, char c) {
this.folge = s;
this.eingabe = c;
}
}Ein boolescher Wert lässt sich mit einer Verzweigung (oder kürzer mit
!) umschalten.Strings vergleicht man in Java mit
s.equals("t1"), nicht mit ==.Vergleichen Sie das übergebene Zeichen mit
t1.eingabe. Stimmt es überein, wird t1.folge zurückgegeben, sonst t2.folge.Nun soll in einem weiteren Programm der m-n-DEA angelegt und getestet werden. Kopieren Sie die unvollständige Implementierung DEATest_unfertig und sichten Sie diese. Vervollständigen Sie den Quellcode entsprechend den Arbeitsschritten 1–8 im Programm und ändern Sie anschließend den Namen des Programms in DEATest.
// 1. Deklarieren und initialisieren Sie die notwendigen Zustände für den
// m-n-DEA (Bsp.: State q0 = new State();).
// 2. Setzen Sie den Endzustand entsprechend.
// 3. Deklarieren und initialisieren Sie einen State aktuell und weisen Sie
// diesem den Startzustand Ihres DEA zu.
// 4. Deklarieren und initialisieren Sie alle acht Transitionen (es würden auch
// weniger reichen!) entsprechend dem m-n-DEA
// (Bsp.: Transition u1 = new Transition(q1,'m');).
// 5. Weisen Sie nun den Zuständen die entsprechenden Transitionen zu.
// 6. Lesen Sie eine User-Eingabe für das Eingabewort ein und speichern Sie es ab.
// 7. Lesen Sie nacheinander die einzelnen Zeichen des Eingabewortes aus und
// bilden Sie den jeweiligen Folgezustand.
// 8. Überprüfen Sie, ob nach Abarbeiten des Eingabewortes der letzte Zustand
// ein Endzustand ist. Geben Sie aus, ob die Eingabe akzeptiert wurde.Der Zustand q3 ist ein Fehlerzustand (
trap). Auch er benötigt zwei Transitionen, die wieder auf ihn selbst zeigen.for (int i = 0; i < s.length(); i++) { aktuell = aktuell.nextState(s.charAt(i)); }Ein Automat akzeptiert genau diejenigen Wörter, die aus den Zeichen a und b bestehen, in denen jedes Zeichen mindestens zweimal hintereinander steht. Die Sprache dieses Automaten wird mit \(L_1\) bezeichnet.
Entscheiden Sie, ob die Wörter aabb, aabbaaabb, abbb, a, bbbaaabb, bbabbb und bbbaab zu \(L_1\) gehören.
Zerlegen Sie jedes Wort in Blöcke gleicher Zeichen, z. B. aabbaaabb = aa | bb | aaa | bb. Jeder Block muss mindestens zwei Zeichen lang sein.
Entwickeln Sie den Zustandsgraphen des Automaten und geben Sie seine formale Definition an.
Welches Zeichen gerade gelesen wird und ob es schon mindestens zweimal hintereinander kam.
Ein Wechsel von a nach b ist nur erlaubt, wenn der a-Block schon lang genug ist. Sonst führt der Übergang in den Fehlerzustand.
Erstellen Sie im Programm DEATest die benötigten Zustände und Übergänge.
Gehen Sie wie in Aufgabe 1 b) vor: Für jeden Zustand ein State-Objekt, für jeden Übergang ein Transition-Objekt.
Auch der Fehlerzustand braucht ein State-Objekt mit zwei Transitionen, die auf ihn selbst zeigen.
Das Eingabealphabet des Automaten wird um das Zeichen c erweitert. Weiterhin werden nur Wörter akzeptiert, in denen jedes Zeichen mindestens zweimal aufeinanderfolgt. Entwickeln Sie einen entsprechenden Zustandsgraphen.
Für c kommen dieselben zwei Zustände hinzu wie für a und b. Von jedem „mindestens zweimal“-Zustand führt eine Kante mit c zum neuen „einmal c“-Zustand.
Implementieren Sie den Automaten aus d) mit Hilfe der Klasse State und dem Programm DEATest. Erstellen Sie hierfür eine dritte Transition in der Klasse State und passen Sie deren Operationen entsprechend an.
Ergänzen Sie ein Attribut t3 und erweitern Sie setTransition und nextState um eine weitere Verzweigung.
Eine einfachere Variante, einen DEA algorithmisch umzusetzen, ist die Mehrfachverzweigung Switch-Case, die bereits bei den Aufgaben zum ADT Stack genutzt wurde.
Implementieren Sie den Automaten aus Aufgabe 2 b) (Alphabet {a, b}) mit Hilfe von Switch-Case. Wer 2 d) bearbeitet hat, setzt stattdessen den erweiterten Automaten über {a, b, c} um. Wenn Sie Hilfe benötigen, können Sie sich am freigegebenen Programm DEAsc orientieren und sich zusätzlich im Internet über Switch-Case informieren.
Speichern Sie den aktuellen Zustand in einer Variablen
int zustand = 0;. Für jedes gelesene Zeichen wird mit switch(zustand) der Folgezustand bestimmt.if (s.charAt(i) == 'a') { switch (zustand) { case 0: zustand = 1; break; case 1: zustand = 2; break; … } } – vergessen Sie das break; nicht.Vergleichen Sie die beiden bisherigen Implementierungen eines DEA hinsichtlich ihrer Vor- und Nachteile.
Vergleichen Sie z. B. Umfang des Codes, Übersichtlichkeit, Aufwand bei einem zusätzlichen Zeichen und Nähe zum objektorientierten Modell.
Der DEA des Schlosssystems am Rüsselsspringergehege (Aufgabe 1 a) zu DEA, PINs 1059, 3064 und 0159) soll implementiert werden.
Verändern Sie die fertige Klasse State entsprechend.
Wie viele Eingabezeichen hat das Zahlenschloss? So viele Transitionen braucht jeder Zustand.
Legen Sie im Programm DEATest die benötigten Zustände und Übergänge an und verknüpfen Sie diese miteinander. Passen Sie die Ausgabe nach der Überprüfung sinnvoll an den Sachkontext an.
Nutzen Sie Ihren Zustandsgraphen aus Aufgabe 1 a) zu DEA. Alle falschen Ziffern führen in den Fehlerzustand.
Die beiden bisherigen Varianten unterscheiden sich vor allem in ihrer Komplexität. Die Variante mit Switch-Case ist deutlich einfacher umzusetzen, die Klassen der ersten Variante passen dagegen eher zum objektorientierten Programmierparadigma – wirken aber recht unhandlich.
Bei beiden Varianten ist nachteilig, dass die Größe des Eingabealphabets und die Menge der Zustände nicht dynamisch erweiterbar sind. Ändert sich die Anzahl der Eingabezeichen, müsste man immer wieder den Java-Code verändern. Außerdem ist der DEA selbst nicht als Klasse modelliert. Dies ändert sich, wenn man mit dynamischen Reihungen (DynArray) arbeitet: Sie machen es möglich, mit beliebigen (aber endlich großen) Alphabeten und damit auch Zustandsübergängen zu arbeiten.
Wählen Sie eine der beiden Varianten aus. Wenn Sie eine Variante als erledigt abhaken, gilt Aufgabe 5 als erledigt.
a) Kopieren Sie die freigegebenen Klassen DEADyn, State und das Programm DEADynTest.
b) Führen Sie das Programm DEADynTest mit einigen Eingabewörtern aus.
c) Beschreiben Sie, was die Operation getFolge der Klasse State sowie der Konstruktor und die Operationen setTransition, transition und simulate der Klasse DEADyn bei ihrem Aufruf ausführen.
d) Implementieren Sie den DEA aus Aufgabe 2 d) und den DEA des Schlosssystems (Aufgabe 1 a) zu DEA) mit der neuen Variante.
a) Die Klasse State hat die Attribute folge (Menge der Folgezustände) und eingabe (zugehörige Eingabezeichen) sowie das Attribut end, das angibt, ob es sich um einen Endzustand handelt. Außer dem Standardkonstruktor gibt es keinen weiteren, da die Transitionen in der Klasse DEADyn gesetzt werden. Kopieren Sie die Klasse State_unfertig, vervollständigen Sie sie und benennen Sie sie in State um.
b) Die Attribute states und alphabet speichern die Zustände des DEA und die Eingabezeichen. Der aktuelle Zustand wird unter akt gespeichert, spos ist eine Hilfsvariable zum Durchlaufen der dynamischen Reihungen. Beim Aufruf des Konstruktors werden zunächst n Zustände initialisiert und an states angehängt. Anschließend werden die Zeichen des Eingabealphabets aus dem String s an alphabet angehängt. Das int-Array t enthält die Endzustände, z. B. {1, 5, 13}. Kopieren Sie die Klasse DEADyn_unfertig.
c) Implementieren Sie die Attribute und den Konstruktor der Klasse DEADyn_unfertig und benennen Sie die Klasse in DEADyn um.
d) Die Operation setTransition(a, c, b) soll beim Zustand am Index a von states als Folgezustand b bei der Eingabe c speichern. Die Operation getAktuell soll den Zustand zurückgeben, in dem sich der DEA gerade befindet. Implementieren Sie beide Operationen.
e) Die Operation transition(char z) soll den Automaten in den Folgezustand versetzen, den er bei Eingabe von z einnehmen muss. Implementieren Sie diese Operation.
f) Die Operation simulate(String word) soll das Eingabewort überprüfen und true zurückgeben, wenn es akzeptiert wird, ansonsten false. Implementieren Sie diese Operation.
g) Implementieren Sie den DEA aus Aufgabe 2 d) und den DEA des Schlosssystems mit der neuen Variante.
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Musterlösung zu den Aufgaben 1 bis 5
Zu Aufgabe 1 a) – Klasse State:
public class State {
Transition t1;
Transition t2;
boolean end = false;
public void changeEnd() {
if (this.end == true) { this.end = false; }
else { this.end = true; }
}
public void setTransition(String s, Transition t) {
if (s.equals("t1")) { this.t1 = t; }
else { this.t2 = t; }
}
public State nextState(char c) {
if (t1.eingabe == c) { return t1.folge; }
else { return t2.folge; }
}
public boolean getEnd() {
return this.end;
}
}Hinweis: nextState liefert für jedes Zeichen, das nicht t1.eingabe ist, den Folgezustand von t2. Ein Zeichen außerhalb von \(\Sigma\) (z. B. x) wird also wie n behandelt. Wer die schwierigere Variante umsetzt, prüft auch t2.eingabe und gibt sonst z. B. null zurück oder wechselt in den Fehlerzustand.
Zu Aufgabe 1 b) – Programm DEATest:
State q0 = new State();
State q1 = new State();
State q2 = new State();
State trap = new State();
q2.changeEnd();
State aktuell = new State();
aktuell = q0;
Transition u1 = new Transition(q1, 'm');
Transition u2 = new Transition(trap, 'n');
Transition u3 = new Transition(trap, 'm');
Transition u4 = new Transition(q2, 'n');
Transition u5 = new Transition(q1, 'm');
Transition u6 = new Transition(q0, 'n');
Transition u7 = new Transition(trap, 'm');
Transition u8 = new Transition(trap, 'n');
q0.setTransition("t1", u1); q0.setTransition("t2", u2);
q1.setTransition("t1", u3); q1.setTransition("t2", u4);
q2.setTransition("t1", u5); q2.setTransition("t2", u6);
trap.setTransition("t1", u7); trap.setTransition("t2", u8);
String s = Input.readString("Geben Sie das Eingabewort ein: ");
for (int i = 0; i < s.length(); i++) {
aktuell = aktuell.nextState(s.charAt(i));
}
if (aktuell.getEnd() == true) { println("Eingabe akzeptiert!"); }
else { println("Eingabe nicht akzeptiert!"); }Zu Aufgabe 2 a):
| aabb | aabbaaabb | abbb | a | bbbaaabb | bbabbb | bbbaab |
|---|---|---|---|---|---|---|
| ja | ja | nein | nein | ja | nein | nein |
Zu Aufgabe 2 b): \(Q = \{q_0, q_1, q_2, q_3, q_4, q_F\}\), \(\Sigma = \{a, b\}\), \(s = q_0\), \(F = \{q_2, q_4\}\). Dabei ist \(q_F\) der Fehlerzustand.
| \(\delta\) | a | b |
|---|---|---|
| \(q_0\) | \(q_1\) | \(q_3\) |
| \(q_1\) | \(q_2\) | \(q_F\) |
| \(q_2\) | \(q_2\) | \(q_3\) |
| \(q_3\) | \(q_F\) | \(q_4\) |
| \(q_4\) | \(q_1\) | \(q_4\) |
| \(q_F\) | \(q_F\) | \(q_F\) |
Zustandsgraph zu Aufgabe 2 b): In \(q_1\) bzw. \(q_3\) wurde ein einzelnes a bzw. b gelesen, in \(q_2\) bzw. \(q_4\) mindestens zwei. Der Fehlerzustand \(q_F\) ist nicht eingezeichnet: Jeder fehlende Übergang führt dorthin.
Zu Aufgabe 2 c): Wie in Aufgabe 1 b), nun mit fünf Zuständen und dem Fehlerzustand trap. Auch trap braucht für beide Zeichen eine Transition (auf sich selbst):
State q0 = new State();
State q1 = new State();
State q2 = new State();
State q3 = new State();
State q4 = new State();
State trap = new State();
q2.changeEnd();
q4.changeEnd();
State aktuell = q0;
Transition u01 = new Transition(q1, 'a'); Transition u02 = new Transition(q3, 'b');
Transition u11 = new Transition(q2, 'a'); Transition u12 = new Transition(trap, 'b');
Transition u21 = new Transition(q2, 'a'); Transition u22 = new Transition(q3, 'b');
Transition u31 = new Transition(trap, 'a'); Transition u32 = new Transition(q4, 'b');
Transition u41 = new Transition(q1, 'a'); Transition u42 = new Transition(q4, 'b');
Transition ut1 = new Transition(trap, 'a'); Transition ut2 = new Transition(trap, 'b');
q0.setTransition("t1", u01); q0.setTransition("t2", u02);
q1.setTransition("t1", u11); q1.setTransition("t2", u12);
q2.setTransition("t1", u21); q2.setTransition("t2", u22);
q3.setTransition("t1", u31); q3.setTransition("t2", u32);
q4.setTransition("t1", u41); q4.setTransition("t2", u42);
trap.setTransition("t1", ut1); trap.setTransition("t2", ut2);Zu Aufgabe 2 d):
Zustandsgraph zu Aufgabe 2 d): \(q_5\) und \(q_6\) übernehmen für c dieselbe Rolle wie \(q_1\)/\(q_2\) für a und \(q_3\)/\(q_4\) für b. Der Fehlerzustand ist nicht eingezeichnet: Jeder fehlende Übergang führt dorthin.
Zu Aufgabe 2 e): Die Klasse State erhält ein drittes Attribut Transition t3;. Die Operationen werden geschachtelt erweitert:
public void setTransition(String s, Transition t) {
if (s.equals("t1")) { this.t1 = t; }
else {
if (s.equals("t2")) { this.t2 = t; }
else { this.t3 = t; }
}
}
public State nextState(char c) {
if (t1.eingabe == c) { return t1.folge; }
else {
if (t2.eingabe == c) { return t2.folge; }
else { return t3.folge; }
}
}Im Programm gibt es die Zustände q0 bis q6 mit den Endzuständen q2, q4 und q6 sowie den Fehlerzustand trap. Jeder Zustand bekommt drei Transitionen, z. B. u01 = new Transition(q1,'a'); u02 = new Transition(q3,'b'); u03 = new Transition(q5,'c'); Die Folgezustände:
| Zustand | a | b | c |
|---|---|---|---|
| q0 | q1 | q3 | q5 |
| q1 | q2 | trap | trap |
| q2 | q2 | q3 | q5 |
| q3 | trap | q4 | trap |
| q4 | q1 | q4 | q5 |
| q5 | trap | trap | q6 |
| q6 | q1 | q3 | q6 |
| trap | trap | trap | trap |
Zu Aufgabe 3 a) – Switch-Case für das Alphabet {a, b}:
int zustand = 0; // 5 = Fehlerzustand
String s = Input.readString("Geben Sie das Eingabewort ein: ");
for (int i = 0; i < s.length(); i++) {
char z = s.charAt(i);
if (z == 'a') {
switch (zustand) {
case 0: zustand = 1; break;
case 1: zustand = 2; break;
case 2: zustand = 2; break;
case 3: zustand = 5; break;
case 4: zustand = 1; break;
default: zustand = 5;
}
} else if (z == 'b') {
switch (zustand) {
case 0: zustand = 3; break;
case 1: zustand = 5; break;
case 2: zustand = 3; break;
case 3: zustand = 4; break;
case 4: zustand = 4; break;
default: zustand = 5;
}
} else {
zustand = 5; // unzulässiges Zeichen
}
}
if (zustand == 2 || zustand == 4) { println("Eingabe akzeptiert!"); }
else { println("Eingabe nicht akzeptiert!"); }Für das Alphabet {a, b, c} kommen die Zustände 5 und 6 (ein einzelnes c bzw. mindestens zwei c) und ein dritter Block für 'c' hinzu. Der Fehlerzustand bekommt dann die Nummer 7; akzeptiert wird bei zustand == 2 || zustand == 4 || zustand == 6.
Zu Aufgabe 3 b): Die Umsetzung mit Switch-Case ist deutlich einfacher. Die Umsetzung mit den Klassen State und Transition hat hier keine wirklichen Vorteile. Beide Varianten sind allerdings unflexibel bei sich verändernden Größen von Eingabealphabet und Zustandsmenge. Für kleine Automaten ist die Variante mit Switch-Case schneller aufgeschrieben und leichter zu überblicken. Eine bestimmte Umsetzung ist für das Abitur nicht vorgegeben.
Zu Aufgabe 4: Die Klasse State benötigt zehn Transitionen t1 bis t10 (eine je Ziffer). setTransition und nextState werden wie in Aufgabe 2 e) durch weitere geschachtelte Verzweigungen erweitert. Im Programm werden die Zustände q0 bis q8 und trap angelegt, q8 ist Endzustand. Übergänge der korrekten Ziffern: q0: 1→q1, 3→q2, 0→q3; q1: 0→q4; q2: 0→q5; q3: 1→q4; q4: 5→q6; q5: 6→q7; q6: 9→q8; q7: 4→q8. Alle übrigen Ziffern führen in trap, der alle Ziffern auf sich selbst abbildet. Beispiel für q0:
Transition u01 = new Transition(q1, '1');
Transition u02 = new Transition(q2, '3');
Transition u03 = new Transition(q3, '0');
Transition u04 = new Transition(trap, '2');
// ... u05 bis u010 für die Ziffern 4 bis 9 ebenfalls nach trap
q0.setTransition("t1", u01);
// ... bis q0.setTransition("t10", u010);Zu Aufgabe 5 – Klassen State und DEADyn:
public class State {
DynArray folge = new DynArray();
DynArray eingabe = new DynArray();
boolean end = false;
public void setEnd() { this.end = true; }
public boolean getEnd() { return end; }
public State getFolge(char c) {
int f = 0;
while (((char) eingabe.getItem(f)) != c) { f++; }
return ((State) folge.getItem(f));
}
}
public class DEADyn {
DynArray states = new DynArray();
DynArray alphabet = new DynArray();
int akt;
int spos;
public DEADyn(int n, String s, int[] t) {
for (int i = 0; i < n; i++) { states.append(new State()); }
akt = 0;
spos = 0;
for (int j = 0; j < s.length(); j++) { alphabet.append(s.charAt(j)); }
for (int l = 0; l < t.length; l++) { ((State) states.getItem(t[l])).setEnd(); }
}
public void setTransition(int a, char c, int b) {
((State) states.getItem(a)).folge.append(states.getItem(b));
((State) states.getItem(a)).eingabe.append(c);
}
public void transition(char z) {
spos = 0;
State tmp = ((State) states.getItem(akt)).getFolge(z);
while (!states.getItem(spos).equals(tmp)) { spos++; }
akt = spos;
}
public State getAktuell() { return ((State) states.getItem(akt)); }
public boolean simulate(String word) {
boolean check = false;
for (int i = 0; i < word.length(); i++) {
for (int j = 0; j < alphabet.getLength(); j++) {
if (word.charAt(i) == ((char) alphabet.getItem(j))) { check = true; }
}
if (!check) { return false; }
check = false;
}
for (int p = 0; p < word.length(); p++) { this.transition(word.charAt(p)); }
boolean ret = this.getAktuell().getEnd();
akt = 0;
return ret;
}
}Beispiel für die Nutzung (Paritätsprüfer für eine ungerade Anzahl Einsen):
int[] endz = { 1 };
DEADyn LUngerade = new DEADyn(2, "01", endz);
LUngerade.setTransition(0, '0', 0);
LUngerade.setTransition(0, '1', 1);
LUngerade.setTransition(1, '0', 1);
LUngerade.setTransition(1, '1', 0);
println(LUngerade.simulate("10100111101"));Hinweis: getFolge sucht in eingabe so lange, bis das Zeichen gefunden ist. Deshalb braucht jeder Zustand für jedes Zeichen des Alphabets eine Transition: Der DEA muss vollständig sein, und der Fehlerzustand muss ausdrücklich als eigener Zustand angelegt werden (mit Schleifen für alle Zeichen). Fehlt eine Transition, bricht das Programm mit einem Indexfehler ab.
Fazit: Vergleicht man alle drei Varianten, ist die dritte mit dynamischen Reihungen in jedem Fall die flexibelste. Mit der Klasse DEADyn kann für jede Situation ein konkreter DEA als Objekt instanziiert werden; die Größe von Eingabealphabet und Zustandsmenge ist dynamisch umgesetzt. Für kleine DEA mit wenigen Eingabezeichen ist die Switch-Case-Variante ebenso in Ordnung.
Mealy-Automaten
Die Zoodirektorin des Osnabrücker Zoos hat die Idee, einen Futterautomaten für die Rüsselsspringer anzuschaffen. Mit diesem können Besuchende des Zoos kleine Snacks für die Tiere kaufen. Der Automat hat einen Münzschlitz, in den nur 10 oder 20 Cent Münzen eingeworfen werden können.
Über eine Reset-Taste kann der Kaufvorgang abgebrochen werden und der Automat gibt das eingezahlte Geld wieder zurück. Als Snacks stehen Blaubeeren (10 Cent) und Himbeeren (20 Cent) zur Verfügung, welche man über eine entsprechende Taste auswählen kann. Mehr als insgesamt 20 Cent kann man nicht einwerfen. Zu viel gezahltes Geld wird direkt wieder ausgegeben.
Die grundlegende Funktionsweise des Futterautomaten ist im unten abgebildeten Zustandsgraphen dargestellt. Ein \(\epsilon\) als Ausgabe bedeutet, dass nichts ausgegeben wird. Der Zustand kann sich dabei trotzdem ändern.
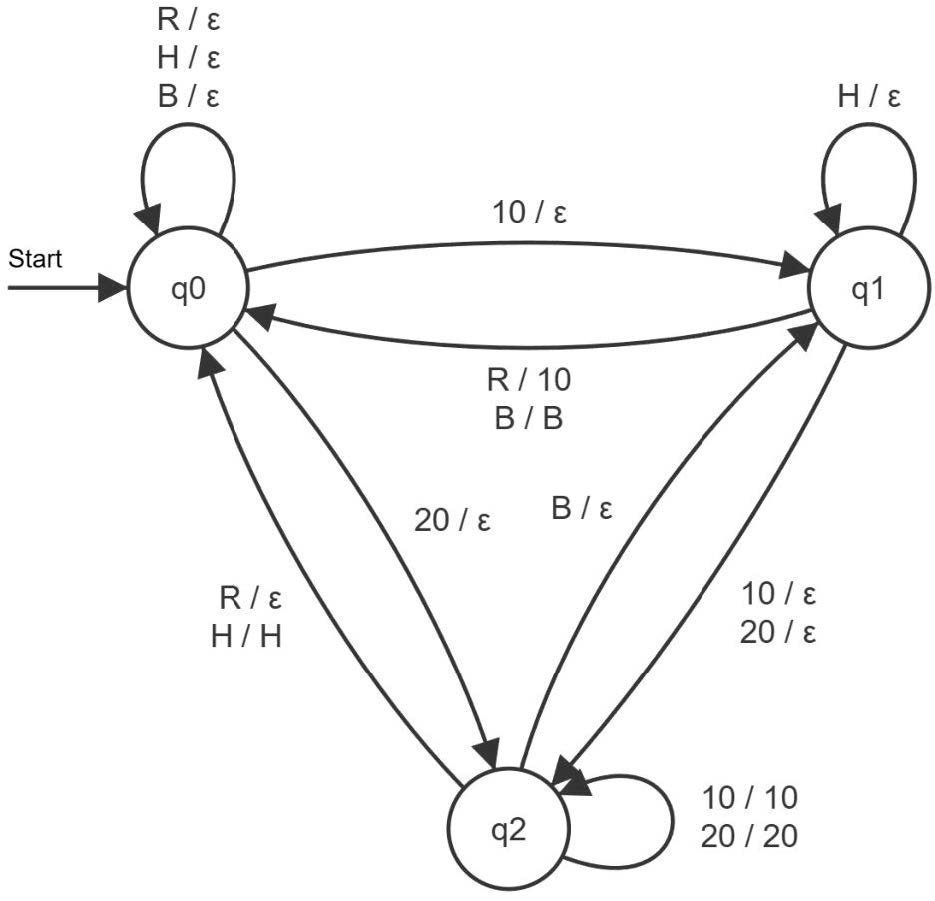
Analysieren Sie die Funktionsweise des neuen Automatentyps anhand des Zustandsgraphen.
Achtung: Es gibt ein paar Fehler im Zustandsgraphen. Korrigieren Sie diese.
Vergleichen Sie den Automaten mit einem DEA hinsichtlich Gemeinsamkeiten und Unterschieden. Versuchen Sie, die formale Definition des Futterautomaten in Anlehnung an die eines DEA zu erstellen.
Sicherung: Bearbeiten Sie zuerst die Aufgabenteile a) und b). Danach finden Sie hier die Beschreibung des neuen Automatentyps, seine formale Definition und den korrigierten Automaten als Tabelle.
Neu ist hier, dass der Automat in Abhängigkeit seines aktuellen Zustands und der jeweiligen Eingabe einmal in einen Folgezustand überführt wird, aber auch eine entsprechende Ausgabe erzeugen soll.
In der Modellierung dieser Situation benötigen wir diesmal einen Mealy-Automaten mit einem 6-Tupel mit der Bezeichnung \((Q, \Sigma, \Omega, \delta, \lambda, s)\), wobei die einzelnen Komponenten wie folgt definiert sind:
| Definition | Futterautomat | |||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| \(Q\) | \(Q\) ist eine nicht leere, endliche Menge von Zuständen. | \(Q = \{q_0, q_1, q_2\}\) | ||||||||||||||||||||||||
| \(\Sigma\) | \(\Sigma\) ist ein nicht leeres, endliches Eingabealphabet. | \(\Sigma = \{10, 20, B, H, R\}\) | ||||||||||||||||||||||||
| \(\Omega\) | \(\Omega\) ist ein nicht leeres, endliches Ausgabealphabet. | \(\Omega = \{10, 20, B, H\}\) | ||||||||||||||||||||||||
| \(\delta\) | \(\delta\) ist die Übergangsfunktion, die jeder Kombination aus aktuellem Zustand und einem Eingabezeichen einen Folgezustand zuordnet. |
| ||||||||||||||||||||||||
| \(\lambda\) | \(\lambda\) ist die Ausgabefunktion, die jeder Kombination aus aktuellem Zustand und einem Eingabezeichen ein Ausgabezeichen oder ein Ausgabewort zuordnet. Ein \(\epsilon\) bedeutet, dass nichts ausgegeben wird; \(\epsilon\) selbst gehört nicht zu \(\Omega\). |
| ||||||||||||||||||||||||
| \(s\) | \(s \in Q\) ist der Startzustand, in dem sich der Mealy-Automat zu Beginn befindet. | \(s = q_0\) |
Man beachte, dass es bei einem Mealy-Automaten keine Endzustände und auch keine Fehlerzustände gibt. Der Automat soll keine Eingaben überprüfen, sondern nur auf bestimmte Eingaben entsprechend reagieren und darf auch niemals in einem „Fehlerzustand“ „festhängen“.
Hinweis zur Übergangs- und Ausgabefunktion: Es ist auch möglich, diese in einer einzigen Tabelle anzugeben.
| \(\delta / \lambda\) | 10 | 20 | B | H | R |
|---|---|---|---|---|---|
| \(q_0\) | \(q_1, \epsilon\) | \(q_2, \epsilon\) | \(q_0, \epsilon\) | \(q_0, \epsilon\) | \(q_0, \epsilon\) |
| \(q_1\) | \(q_2, \epsilon\) | \(q_2, 10\) | \(q_0, B\) | \(q_1, \epsilon\) | \(q_0, 10\) |
| \(q_2\) | \(q_2, 10\) | \(q_2, 20\) | \(q_1, B\) | \(q_0, H\) | \(q_0, 20\) |
Aufgaben zu Mealy-Automaten
Arbeiten Sie die folgenden Aufgabenstellungen zu Mealy-Automaten durch. Nutzen Sie bei Bedarf die integrierten Hilfestellungen.
Da der Futterautomat für die Rüsselsspringer bei den Gästen des Zoos sehr gut angekommen ist, soll er erweitert werden. Nun kann man 10, 20 und 50 Cent einwerfen. Die Futteroptionen sind nun um Melonenstücke (M) für 50 Cent erweitert worden. Nach wie vor wird zu viel eingeworfenes Geld automatisch zurückgegeben und der Automat akzeptiert maximal 50 Cent Guthaben. Die Returntaste gibt es ebenfalls wieder.
Entwerfen Sie einen Mealy-Automaten in Form eines Zustandsgraphen, der die neuen Anforderungen umsetzt.
Legen Sie für jedes mögliche Guthaben einen Zustand an: \(q_0\) (0 Cent), \(q_1\) (10 Cent), \(q_2\) (20 Cent), \(q_3\) (30 Cent), \(q_4\) (40 Cent), \(q_5\) (50 Cent).
Wenn in Zustand \(q_4\) (40 Cent) noch 20 Cent eingeworfen werden, wechselt der Automat in \(q_5\) und gibt sofort 10 Cent Wechselgeld zurück (Beschriftung der Kante:
20 / 10).Geben Sie die formale Definition Ihres Mealy-Automaten als 6-Tupel \((Q, \Sigma, \Omega, \delta, \lambda, s)\) an.
Gehen Sie das 6-Tupel der Reihe nach durch: Q, Σ, Ω, δ, λ, s. δ und λ lassen sich gemeinsam in einer Tabelle mit Einträgen „Folgezustand, Ausgabe“ angeben.
Ω enthält alle Ausgaben, die vorkommen. „Keine Ausgabe“ wird als ε notiert, gehört aber nicht zu Ω.
Der Ticketautomat im Osnabrücker Zoo verursacht regelmäßig Beschwerden von Kundinnen und Kunden. Irgendwie scheint seine Funktionalität nicht in Ordnung zu sein. Der Mealy-Automat, der die Ticketvergabe steuert, ist unten abgebildet:
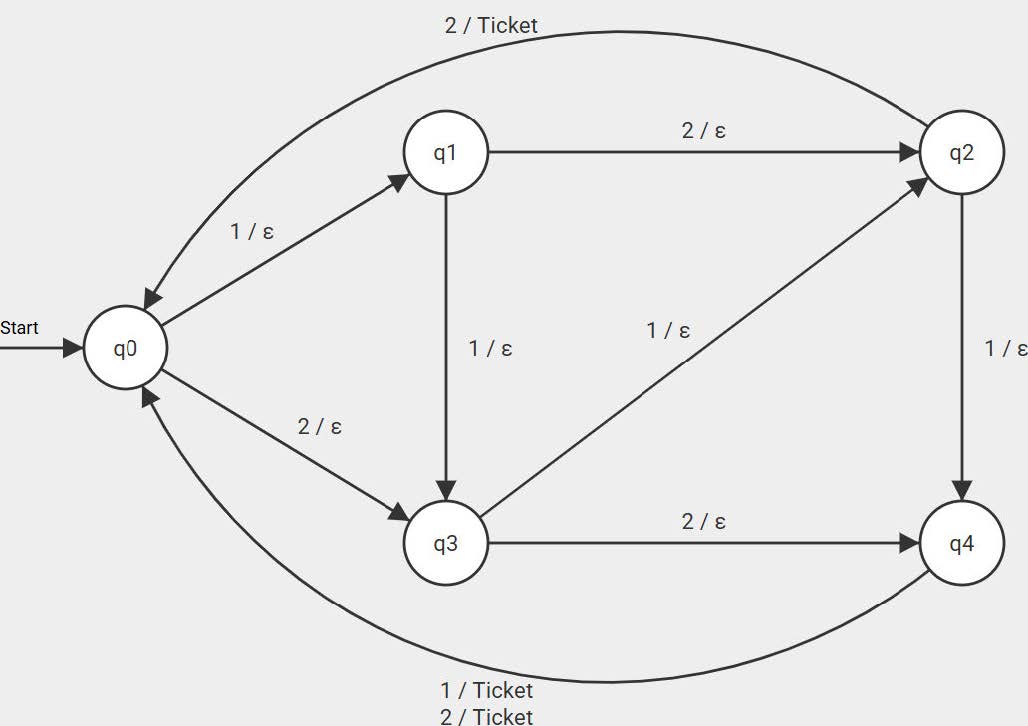
Analysieren und erläutern Sie die Funktionsweise dieses Mealy-Automaten. Decken Sie dabei logische Fehler oder unerwünschtes Verhalten im Ablauf auf.
Überlegen Sie für jeden Zustand, welches Guthaben er darstellt. Passen die Namen der Zustände dazu?
Spielen Sie einige Einwürfe durch, z. B. 2 €, 2 €, 2 €. Was kostet das Ticket dann, und gibt es Wechselgeld?
Was passiert, wenn jemand den Kauf abbrechen möchte?
Erläutern Sie, weshalb ein Mealy-Automat generell keine Fehler- und Endzustände besitzt.
Ein DEA entscheidet, ob ein Wort akzeptiert wird. Was ist dagegen die Aufgabe eines Mealy-Automaten?
Entwickeln Sie Vorschläge zur Verbesserung und verändern Sie den Zustandsgraphen entsprechend. Integrieren Sie auch die Möglichkeit, mit einem 5 €-Schein zu zahlen.
Legen Sie zuerst fest, was das Ticket kostet und welche Eingaben es gibt (Münzen, Schein, Rückgabe). Dann erhält jeder Zustand für jede Eingabe eine Kante.
Eine Ausgabe wie „Ticket, 1 €“ darf ein einziges Ausgabezeichen sein.
Gegeben ist ein Mealy-Automat mit \(Q=\{q_0, q_1, q_2\}\), \(\Sigma=\{0,1\}\), \(\Omega=\{0,1\}\) und Startzustand \(s=q_0\). Die Zustandsübergangs- (\(\delta\)) und Ausgabefunktionen (\(\lambda\)) sind in den folgenden Tabellen dargestellt:
| \(\delta\) | 0 | 1 |
|---|---|---|
| \(q_0\) | \(q_0\) | \(q_1\) |
| \(q_1\) | \(q_2\) | \(q_1\) |
| \(q_2\) | \(q_2\) | \(q_0\) |
| \(\lambda\) | 0 | 1 |
|---|---|---|
| \(q_0\) | 0 | 1 |
| \(q_1\) | 1 | 0 |
| \(q_2\) | 0 | 1 |
Zeichnen Sie den zugehörigen Zustandsgraphen auf ein Blatt Papier oder in Ihr Digitalheft.
Zeichnen Sie die drei Zustände. Lesen Sie dann in den Tabellen Zeile für Zeile ab: Aus δ den Folgezustand, aus λ die Ausgabe. Jede Kante wird „Eingabe / Ausgabe“ beschriftet.
Überprüfen Sie, welche Ausgaben durch die folgenden Eingabefolgen nacheinander erzeugt werden:
11111010111010
Notieren Sie für jedes Zeichen: aktueller Zustand, Eingabe, Ausgabe, Folgezustand. Beginnen Sie jede Folge in \(q_0\).
Ein neuer Blumenautomat bietet zwei Sorten Blumen \(B_1\) und \(B_2\) an. Beide Sträuße kosten jeweils 3 €. Eine Kundin bzw. ein Kunde kann nur 1 € oder 2 € Münzen einwerfen. Der Automat besitzt zwei Tasten \(T_1\) und \(T_2\) für die beiden Straußvarianten sowie eine Taste \(R\) für die Rückgabe des eingeworfenen Geldes. Zu viel eingeworfenes Geld (man kann maximal 3 Euro Guthaben haben) wird sofort wieder zurückgegeben.
Entwickeln Sie den Zustandsgraphen eines Mealy-Automaten, der die gesamte Logik des Blumenautomaten korrekt umsetzt.
Die Zustände stehen für das Guthaben: 0 €, 1 €, 2 €, 3 €.
Was passiert, wenn eine Taste gedrückt wird, obwohl das Guthaben nicht reicht? Und was gibt R in jedem Zustand aus?
Bei 2 € Guthaben und einer 2-€-Münze werden 3 € erreicht. Der überzählige Euro wird sofort ausgegeben.
Geben Sie die formale Definition des Mealy-Automaten an.
Gehen Sie das 6-Tupel durch: Q, Σ, Ω, δ, λ, s. Eine gemeinsame Tabelle für δ und λ ist am übersichtlichsten.
Entwickeln Sie einen endlichen Automaten mit Ausgabe zur Simulation des dargestellten Kaffeeautomaten. Der Automat akzeptiert nur 0,50 €- und 1,00 €-Münzen. Ein kleiner Kaffee kostet 1 € und ein großer Kaffee 2 €. Man kann nicht mehr als 2 € Guthaben besitzen.
Wählen Sie eine der beiden Varianten zur Bearbeitung aus:
| Standardvariante | Schwierige Variante |
|---|---|
| Es gibt keine Geldrückgabe. | Es gibt eine Geldrückgabe mit einer zusätzlichen Taste. Zu viel eingeworfenes Geld kommt automatisch wieder heraus. |
Entwerfen Sie den Zustandsgraphen für die gewählte Variante.
Die Zustände stehen für das Guthaben in 50-Cent-Schritten: 0 €, 0,50 €, 1 €, 1,50 €, 2 €.
Eingaben sind die beiden Münzen und die Tasten für kleinen und großen Kaffee (in der schwierigen Variante auch die Rückgabetaste). Jeder Zustand braucht für jede Eingabe eine Kante.
In einer Smartphone-App kann man einen Hintergrund (A oder B) und einen Signalton (1 oder 2) auswählen und anschließend herunterladen. Interpretieren Sie die Funktionsweise des Auswahlbildschirms als Mealy-Automat, wobei die Eingabe durch Antippen der Schaltflächen HA, HB (Hintergrund A/B), T1, T2 (Ton 1/2) und OK zu verstehen ist. Die Schaltflächen können mehrfach angetippt werden. Durch Antippen ändert sich die aktuelle Auswahl. Wird keine Schaltfläche angetippt, ist die Situation wie in der Abbildung. Durch Antippen von „OK“ startet der Download des ausgewählten Hintergrunds und Signaltons.
Entwerfen Sie einen Mealy-Automaten, der die Funktionsweise dieser Menüauswahl und den anschließenden Download-Start korrekt umsetzt.
Ein Zustand ist eine Kombination aus gewähltem Hintergrund und gewähltem Ton. Wie viele Kombinationen gibt es?
Antippen von HA, HB, T1 oder T2 ändert höchstens die Auswahl und gibt nichts aus (ε). Nur OK erzeugt eine Ausgabe.
Ein Förderband zum Längentest von Baumstämmen enthält die drei Lichtschranken A, B und C. Baumstämme haben die richtige Länge, wenn sie länger oder genau so lang wie die Messstrecke \(\overline{AB}\), aber kürzer als die Messstrecke \(\overline{AC}\) sind. Zwei aufeinander folgende Stämme werden so auf das Förderband gelegt, dass ihr Abstand größer als \(\overline{AC}\) ist. Bei Einschalten des Bandes sei kein Stamm auf dem Förderband. Kein Stamm ist kürzer als \(\overline{BC}\). Die Lichtschranken liefern die Signale 0 und 1. Das Tripel 011 bedeutet, dass ein Stamm den Messpunkt A vollständig durchfahren hat, sich aber noch im Bereich der Messpunkte B und C befindet. Diese Tripel werden in regelmäßiger Folge an einen Automaten weitergeleitet.
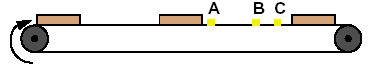
Interpretieren Sie folgende Tripelfolgen bezüglich der Stammlängen, in denen nur die Übergänge, jedoch nicht sich wiederholende Tripel aufgeführt sind:
i) \(000 \rightarrow 100 \rightarrow 110 \rightarrow 111 \rightarrow 011 \rightarrow 001 \rightarrow 000\)
ii) \(000 \rightarrow 100 \rightarrow 010 \rightarrow 011 \rightarrow 001 \rightarrow 000\)
Jedes Tripel gibt an, welche Lichtschranken gerade unterbrochen sind (A, B, C; 1 = unterbrochen).
Bedeckt der Stamm irgendwann A und C gleichzeitig, ist er mindestens so lang wie \(\overline{AC}\). Verlässt er A, bevor er B erreicht, ist er kürzer als \(\overline{AB}\).
Geben Sie begründet eine Tripelfolge an, die in der Realität aufgrund der physikalischen Anordnung nicht auftreten kann.
B liegt zwischen A und C. Welche Kombination kann ein einzelner Stamm deshalb nie erzeugen?
In Abhängigkeit von der eingegangenen Tripelfolge gibt der Automat folgende Ausgaben:
+Stamm ist zu lang-Stamm ist zu kurz0Stamm hat die richtige LängenStamm nicht im Bereich der Lichtschranken oder Länge noch nicht feststellbar
1. Begründen Sie, warum das Tripel 101 nicht im Eingabealphabet enthalten ist.
2. Interpretieren Sie die Zustände \(q_1\) bis \(q_4\) und \(q_6\) des Automaten.
Überlegen Sie, was das Signal
101 bedeuten würde: Lichtschranke A ist unterbrochen, Lichtschranke B frei, Lichtschranke C unterbrochen. Warum ist das bei einem einzelnen zusammenhängenden Baumstamm unmöglich?Betrachten Sie, welche Lichtschranke ein Stamm bereits erreicht hat, während er sich durch die Messstrecke bewegt (z. B. \(q_1\): Stamm hat A unterbrochen; \(q_2\): Stamm unterbricht A und B gleichzeitig; etc.).
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Musterlösung zu den Aufgaben 1 bis 7
Die Zustände geben jeweils das Guthaben an. \(\varepsilon\) bedeutet „keine Ausgabe“. Mehrere Beschriftungen an einer Kante sind mehrere Übergänge.
Zu Aufgabe 1 a): \(q_0\) bis \(q_5\) stehen für 0 bis 50 Cent Guthaben.
Zu Aufgabe 1 b): \(Q = \{q_0, q_1, q_2, q_3, q_4, q_5\}\), \(\Sigma = \{10, 20, 50, B, H, M, R\}\), \(\Omega = \{10, 20, 30, 40, 50, B, H, M\}\), \(s = q_0\). Übergangs- und Ausgabefunktion:
| \(\delta / \lambda\) | 10 | 20 | 50 | B | H | M | R |
|---|---|---|---|---|---|---|---|
| \(q_0\) | \(q_1\), \(\varepsilon\) | \(q_2\), \(\varepsilon\) | \(q_5\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) |
| \(q_1\) | \(q_2\), \(\varepsilon\) | \(q_3\), \(\varepsilon\) | \(q_5\), 10 | \(q_0\), B | \(q_1\), \(\varepsilon\) | \(q_1\), \(\varepsilon\) | \(q_0\), 10 |
| \(q_2\) | \(q_3\), \(\varepsilon\) | \(q_4\), \(\varepsilon\) | \(q_5\), 20 | \(q_1\), B | \(q_0\), H | \(q_2\), \(\varepsilon\) | \(q_0\), 20 |
| \(q_3\) | \(q_4\), \(\varepsilon\) | \(q_5\), \(\varepsilon\) | \(q_5\), 30 | \(q_2\), B | \(q_1\), H | \(q_3\), \(\varepsilon\) | \(q_0\), 30 |
| \(q_4\) | \(q_5\), \(\varepsilon\) | \(q_5\), 10 | \(q_5\), 40 | \(q_3\), B | \(q_2\), H | \(q_4\), \(\varepsilon\) | \(q_0\), 40 |
| \(q_5\) | \(q_5\), 10 | \(q_5\), 20 | \(q_5\), 50 | \(q_4\), B | \(q_3\), H | \(q_0\), M | \(q_0\), 50 |
Zu Aufgabe 2 a): Die Zustände stehen für die Guthaben \(q_0\) = 0 €, \(q_1\) = 1 €, \(q_3\) = 2 €, \(q_2\) = 3 € und \(q_4\) = 4 €. Ab 5 € wird automatisch ein Ticket ausgegeben. Probleme: Bei 4 € und einer 2-€-Münze gibt es ein Ticket, aber kein Wechselgeld; das Ticket kostet dann 6 €. Es gibt keine Rückgabe und keinen Abbruch. Die Benennung der Zustände ist irreführend.
Zu Aufgabe 2 b): Ein Mealy-Automat prüft keine Eingaben, sondern reagiert auf jede Eingabe mit einer Ausgabe und arbeitet dauerhaft weiter. Es wird nichts akzeptiert, also gibt es keine Endzustände. Er darf nie hängen bleiben, also gibt es keine Fehlerzustände.
Zu Aufgabe 2 c): Das Ticket kostet 5 €, Wechselgeld wird ausgegeben, R gibt das Guthaben zurück, ein 5-€-Schein ist möglich. Die Zustände sind hier nach dem Guthaben benannt (\(q_2\) = 2 €, \(q_3\) = 3 €). Eine Ausgabe wie „Ticket, 1 €“ ist ein einziges Ausgabezeichen.
Zu Aufgabe 3 a):
Zu Aufgabe 3 b):
| Eingabe | Ablauf | Ausgabe |
|---|---|---|
| 11111 | q0 –1/1→ q1 –1/0→ q1 –1/0→ q1 –1/0→ q1 –1/0→ q1 | 10000 |
| 01011 | q0 –0/0→ q0 –1/1→ q1 –0/1→ q2 –1/1→ q0 –1/1→ q1 | 01111 |
| 1010 | q0 –1/1→ q1 –0/1→ q2 –1/1→ q0 –0/0→ q0 | 1110 |
Zu Aufgabe 4 a): \(q_0\) bis \(q_3\) stehen für 0 bis 3 € Guthaben. Eine Taste bei zu wenig Guthaben bewirkt nichts.
Zu Aufgabe 4 b): \(Q = \{q_0, q_1, q_2, q_3\}\), \(\Sigma = \{1, 2, T1, T2, R\}\), \(\Omega = \{1, 2, 3, B1, B2\}\), \(s = q_0\).
| \(\delta / \lambda\) | 1 | 2 | T1 | T2 | R |
|---|---|---|---|---|---|
| \(q_0\) | \(q_1\), \(\varepsilon\) | \(q_2\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) | \(q_0\), \(\varepsilon\) |
| \(q_1\) | \(q_2\), \(\varepsilon\) | \(q_3\), \(\varepsilon\) | \(q_1\), \(\varepsilon\) | \(q_1\), \(\varepsilon\) | \(q_0\), 1 |
| \(q_2\) | \(q_3\), \(\varepsilon\) | \(q_3\), 1 | \(q_2\), \(\varepsilon\) | \(q_2\), \(\varepsilon\) | \(q_0\), 2 |
| \(q_3\) | \(q_3\), 1 | \(q_3\), 2 | \(q_0\), B1 | \(q_0\), B2 | \(q_0\), 3 |
Zu Aufgabe 5: \(q_0\) bis \(q_4\) stehen für 0 €, 0,50 €, 1 €, 1,50 € und 2 € Guthaben. Kk ist der kleine, Kg der große Kaffee. Standardvariante (zu viel eingeworfenes Geld wird einbehalten):
Schwierige Variante (Rückgabetaste R, zu viel Geld kommt zurück):
Zu Aufgabe 6: Der Zustand merkt sich die aktuelle Auswahl (HA/HB = Hintergrund A/B, T1/T2 = Ton 1/2). Ohne Antippen ist „Hintergrund A, Ton 1“ ausgewählt. Ein Antippen ändert die Auswahl ohne Ausgabe (\(\varepsilon\)). OK startet den Download (Ausgabe z. B. „HA T1“) und setzt die Auswahl zurück. Bleibt die Auswahl nach OK stehen, wird jede OK-Kante zur Schleife.
Zu Aufgabe 7 a):
- i) Der Stamm unterbricht A und B (110) und dann alle drei Lichtschranken (111). Er ist mindestens so lang wie \(\overline{AC}\), also zu lang.
- ii) Auf 100 folgt 010: Der Stamm hat A verlassen, bevor er B erreicht hat. Er ist kürzer als \(\overline{AB}\), also zu kurz.
Zu Aufgabe 7 b): Zum Beispiel 000 → 100 → 101 → … ist unmöglich. Bei 101 wären A und C unterbrochen, B aber nicht. Ein Stamm, der A und C bedeckt, bedeckt auch das dazwischen liegende B. Zwei Stämme gleichzeitig gibt es nicht, weil ihr Abstand größer als \(\overline{AC}\) ist.
Zu Aufgabe 7 c) 1.: 101 kann aus demselben Grund nie auftreten und gehört deshalb nicht ins Eingabealphabet.
Zu Aufgabe 7 c) 2.:
- \(q_1\): Der Stamm unterbricht A, hat B noch nicht erreicht. Die Länge ist noch nicht feststellbar (n).
- \(q_2\): Der Stamm unterbricht A und B. Er ist mindestens so lang wie \(\overline{AB}\), aber noch nicht eingeordnet (n).
- \(q_3\): Ein zu kurzer Stamm fährt durch B und C (−).
- \(q_4\): Der Stamm bedeckte A und B, hat A aber verlassen, bevor er C erreicht hat. Er hat die richtige Länge (0).
- \(q_6\): Der Stamm hat A verlassen, bevor er B erreicht hat, und befindet sich zwischen A und B. Er ist zu kurz (−).
Außerdem: \(q_0\) heißt „kein Stamm im Messbereich“, \(q_5\) „Stamm ist zu lang“ (+).
Grenzen endlicher Automaten
Wählen Sie eine der beiden Varianten über die Reiter aus und bearbeiten Sie die dazugehörigen Teilaufgaben:
Aufgrund des hohen Futterbedarfs der sehr vielen neu geborenen Rüsselsspringerbabies soll der Futterautomat so geändert werden, dass die Menge des eingeworfenen Geldes nicht begrenzt ist. Dazu reduziert man die möglichen Münzen auf 10 Cent. Zu kaufen gibt es nur noch preisreduzierte Himbeeren für 10 Cent. Eine Resettaste gibt es nicht mehr.
Aus Testzwecken soll das maximale Guthaben zunächst auf 20 Cent begrenzt sein. Der Automat soll zu viel eingeworfenes Geld einfach wieder auswerfen.
Arbeitsauftrag: Entwerfen Sie einen Mealy-Automaten (MA) in Form eines Zustandsgraphen, welcher den Anforderungen genügt.
Die Zustände stehen für das Guthaben: 0, 10 und 20 Cent. Eingaben sind 10 und H.
Was gibt der Automat aus, wenn bei 20 Cent Guthaben noch eine Münze eingeworfen wird?
Nun wird das maximale Guthaben auf 40 Cent begrenzt.
Arbeitsauftrag: Entwerfen Sie einen Mealy-Automaten (MA) in Form eines Zustandsgraphen, welcher den Anforderungen genügt.
Arbeitsauftrag: Untersuchen Sie, wie sich der Zustandsgraph verändern muss, wenn der Automat für beliebig aber endlich lange Eingabewörter freigegeben wird.
Vergleichen Sie die Graphen aus a) und b). Was kommt für jede weitere 10 Cent Guthaben hinzu?
Im Osnabrücker Zoo hat die Direktorin ein modernes Schloss angebracht, welches über ein Pad bedient werden kann. Mögliche Eingaben sind die Ziffern 0 und 1. Das Schloss öffnet sich, wenn eine gleiche Anzahl von Nullen und Einsen eingegeben werden.

Um den notwendigen DEA zu entwerfen, ist die Länge der Eingaben zunächst auf 2 begrenzt.
Arbeitsauftrag: Geben Sie zwei akzeptierte und zwei strukturell verschiedene nicht akzeptierte Eingaben an.
Arbeitsauftrag: Entwerfen Sie einen DEA zu Aufgabenteil a) in Form eines Zustandsgraphen, welcher als Akzeptor der erlaubten Eingaben arbeitet.
Der DEA muss sich merken, was bisher gelesen wurde: nichts, „0“, „1“ oder zwei Zeichen. Bei welchen zwei Zeichen ist die Anzahl gleich?
Arbeitsauftrag: Untersuchen Sie, wie sich der Zustandsgraph aus b) verändern muss, wenn die Eingabelänge auf 4 erhöht wird.
Arbeitsauftrag: Untersuchen Sie, wie sich der Zustandsgraph verändern muss, wenn beliebig aber endlich lange Eingabewörter möglich sind.
Es genügt, die Differenz „Anzahl Nullen minus Anzahl Einsen“ zu kennen. Wie viele verschiedene Werte kann diese Differenz bei beliebiger Länge annehmen?
Am Beispiel des Futterautomaten erkennt man, dass manche Situationen nicht mit endlichen Automaten zu realisieren sind.
Für jede Erhöhung des maximalen Guthabens um 10 Cent wäre ein weiterer Zustand notwendig:
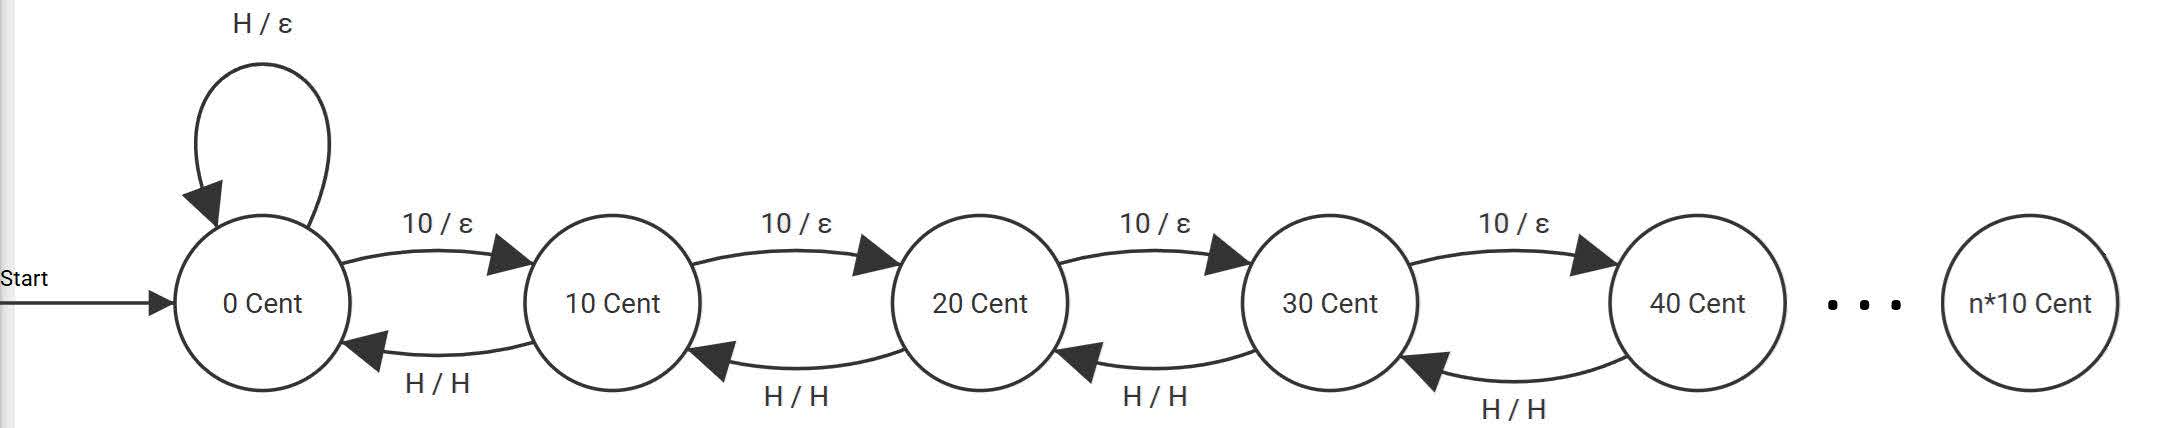
Somit bräuchte der Automat unendlich viele Zustände, um jedes mögliche Guthaben korrekt verarbeiten zu können. Sowohl ein DEA als auch ein Mealy-Automat können dies nicht leisten, da sie in ihrer Funktionsweise und durch die nur endlich mögliche Zustandsmenge hierfür nicht hinreichend funktional sind.
Aufgabe: Vom DEA zum Kellerautomaten
eA
Kellerautomaten gehören zum erhöhten Anforderungsniveau. Im grundlegenden Anforderungsniveau endet der Abschnitt mit der Zusammenfassung oben: Endliche Automaten können sich nur endlich viel merken.
Die Situation entspricht der Standardvariante der Einstiegsaufgabe: Wir benötigen einen Automaten, der ein beliebiges, aber endliches Guthaben korrekt verarbeiten kann.
Zunächst betrachten wir mögliche Eingaben in den Automaten auf theoretischer Ebene. Ein Eingabewort soll korrekt sein, wenn die folgenden Bedingungen erfüllt sind:
- Das Guthaben soll am Ende verbraucht sein.
- Die Himbeertaste darf nur gedrückt werden, wenn noch Guthaben vorhanden ist.
Unser Automat soll jetzt prüfen, ob ein Eingabewort aus den Eingabezeichen 10 und H korrekt ist. Er wird also ein Akzeptor sein und eine Erweiterung eines DEA. Das Eingabealphabet ist \(\Sigma = \{10, H\}\) und wir ignorieren nun die Ausgaben.
Arbeitsauftrag: Geben Sie ein akzeptiertes und zwei strukturell verschiedene nicht akzeptierte Eingabewörter an.
Ein Wort ist korrekt, wenn an keiner Stelle mehr H als 10 gelesen wurden und am Ende gleich viele H wie 10 stehen.
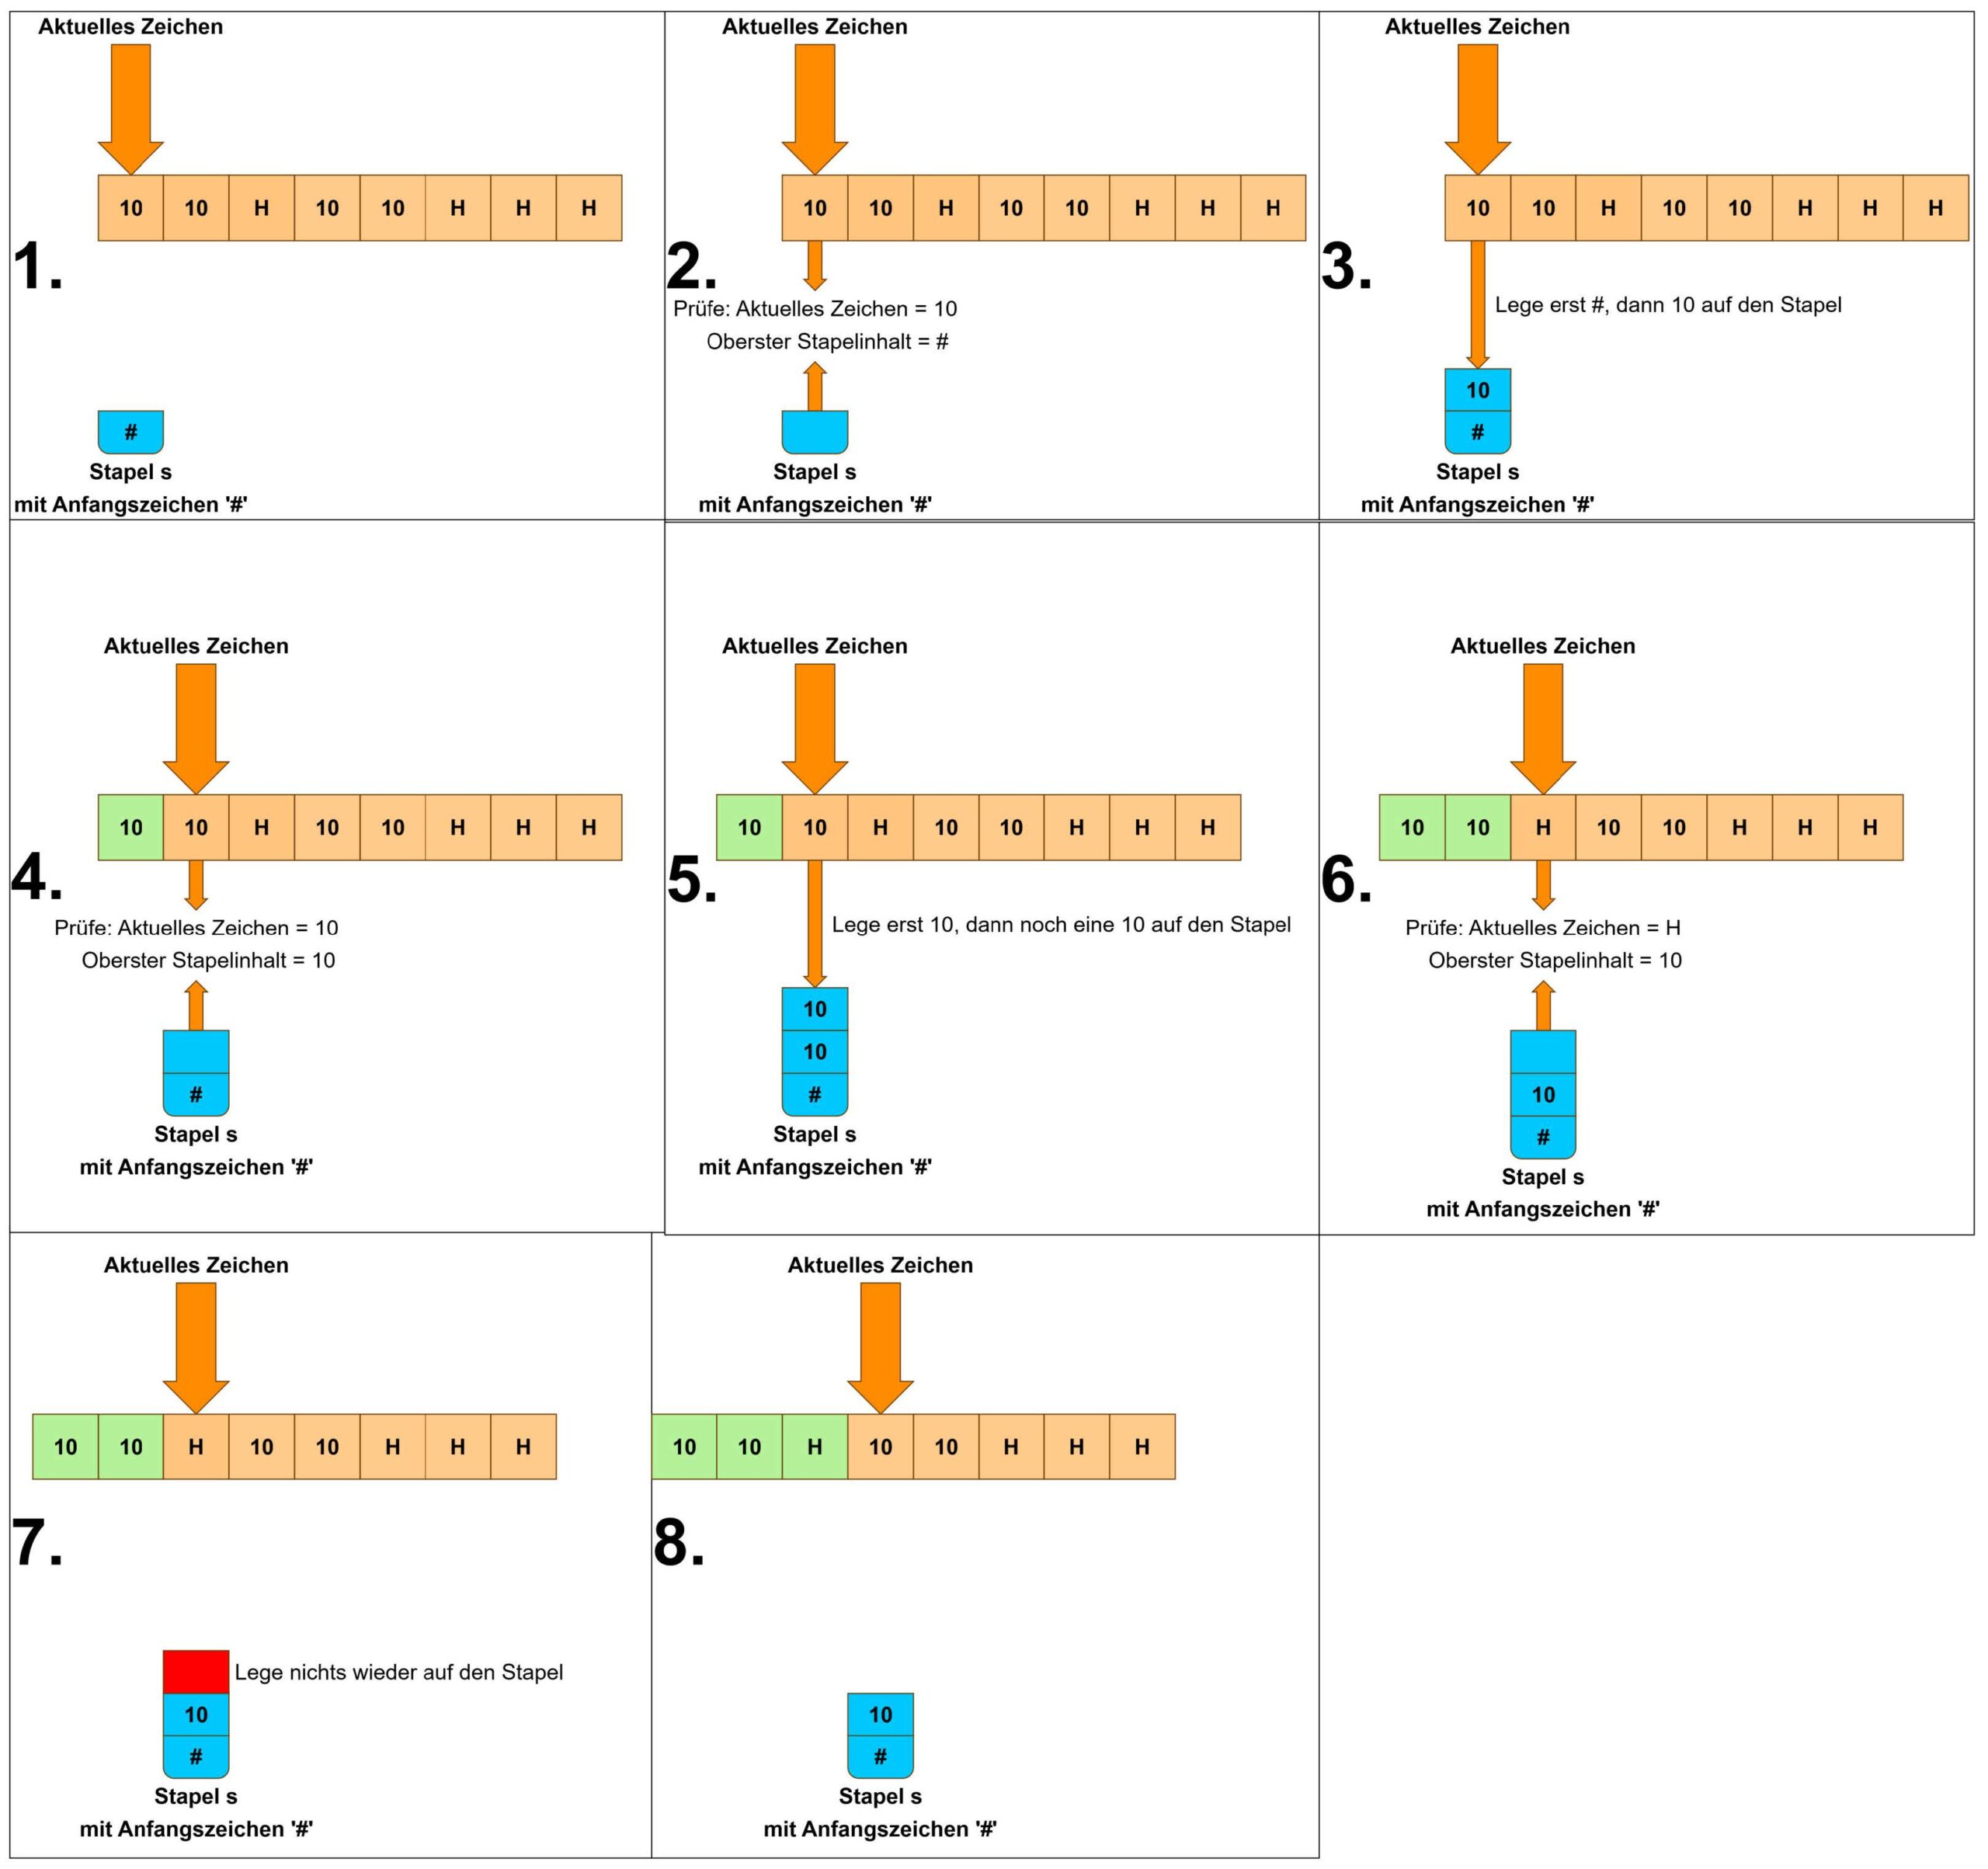
Angenommen, das Eingabewort lautet: "10 10 H 10 10 H H H".
Arbeitsauftrag: Begründen Sie, dass es sich dabei um ein korrektes Eingabewort handelt, dieses also akzeptiert werden muss.
Schreiben Sie nach jedem Zeichen das Guthaben auf. Wird es irgendwann negativ? Ist es am Ende 0?
Die Idee ist nun, dem neuen Automaten ein Objekt des ADT Stapel zur Verfügung zu stellen, mit dem er arbeiten kann. Unser neuer Automat arbeitet das Eingabewort zeichenweise ab.
Der Automat erhält zunächst das Eingabewort und beginnt, angefangen beim ersten Zeichen, die Eingabe abzuarbeiten.

Arbeitsauftrag:
- Analysieren Sie die Funktionsweise des Automaten.
- Entwerfen Sie Regeln für den Automaten, was er tun soll, wenn eine
10oder einHals aktuelles Eingabezeichen gelesen wird, in Abhängigkeit des im obersten Stapelelement gespeicherten Zeichens. - Wenden Sie Ihre Regeln auf eine andere korrekte und eine nicht korrekte Eingabe an.
Erinnern Sie sich an die Methoden eines Stapels:
push() legt ein Element oben ab, pop() entfernt das oberste Element und top() schaut das oberste Element an.– Wenn eine
10 gelesen wird: Lege eine Münze/Markierung auf den Stapel.– Wenn ein
H gelesen wird: Prüfe, ob oben noch eine 10 liegt (und nicht nur das #), und entferne sie vom Stapel.🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Musterlösung zur Einstiegsaufgabe und zur Aufgabe „Vom DEA zum Kellerautomaten“
Einstiegsaufgabe, Standardvariante a): Die Zustände geben das Guthaben an, \(\varepsilon\) bedeutet „keine Ausgabe“. Ist das Guthaben schon 20 Cent, wird eine weitere Münze sofort wieder ausgegeben.
Standardvariante b):
Standardvariante c): Bei einem Höchstbetrag von n · 10 Cent braucht der Automat n + 1 Zustände. Jede Erhöhung um 10 Cent erfordert einen weiteren Zustand. Ohne Höchstbetrag wären unendlich viele Zustände nötig, ein endlicher Automat kann das nicht leisten.
Schwierige Variante a): Akzeptiert werden 01 und 10. Nicht akzeptiert werden z. B. 00 (ungleich viele Nullen und Einsen) und 0 (zu kurz).
Schwierige Variante b):
Schwierige Variante c): Jeder Zustand merkt sich die bisherige Länge und die Differenz „Anzahl Nullen minus Anzahl Einsen“. Endzustände sind die Zustände mit Differenz 0.
| Zustand | \(q_0\) | \(q_1\) | \(q_2\) | \(q_3\) | \(q_4\) | \(q_5\) | \(q_6\) | \(q_7\) | \(q_8\) |
|---|---|---|---|---|---|---|---|---|---|
| Länge | 0 | 1 | 1 | 2 | 2 | 2 | 3 | 3 | 4 |
| Nullen minus Einsen | 0 | +1 | −1 | +2 | 0 | −2 | +1 | −1 | 0 |
Schwierige Variante d): Der Automat muss sich die Differenz zwischen der Anzahl der Nullen und der Einsen merken. Bei beliebig langen Eingaben kann diese Differenz beliebig groß werden. Für jede mögliche Differenz bräuchte er einen eigenen Zustand, insgesamt also unendlich viele. Ein DEA kann das nicht leisten.
Vom DEA zum Kellerautomaten, a): Akzeptiert wird z. B. 10 10 H H 10 H. Nicht akzeptiert werden 10 10 H (am Ende bleibt Guthaben übrig) und 10 H H (H ohne Guthaben).
b): Nach jedem Zeichen beträgt das Guthaben 10, 20, 10, 20, 30, 20, 10, 0 Cent. Bei jedem H ist also noch Guthaben vorhanden, und am Ende ist es genau verbraucht. Das Wort ist korrekt.
c) 1.: Der Automat vergleicht in jedem Schritt das aktuelle Eingabezeichen mit dem obersten Stapelelement. Das oberste Element wird entfernt und je nach Fall wieder abgelegt. Jede 10 auf dem Stapel steht für 10 Cent Guthaben, das # markiert den Boden des Stapels.
c) 2.:
| Eingabe | oben auf dem Stapel | Aktion |
|---|---|---|
| 10 | # | entfernen, dann # und 10 ablegen |
| 10 | 10 | entfernen, dann zwei 10 ablegen |
| H | 10 | entfernen, nichts ablegen |
| H | # | Abbruch: nicht akzeptiert (kein Guthaben) |
| Ende der Eingabe | # | akzeptiert |
| Ende der Eingabe | 10 | nicht akzeptiert (Restguthaben) |
c) 3.: Stapelinhalt nach jedem Zeichen, oben rechts:
| Eingabewort | Stapel nach jedem Zeichen | Ergebnis |
|---|---|---|
| 10 H 10 10 H H | #10, #, #10, #1010, #10, # | Ende, # oben: akzeptiert |
| 10 H H | #10, #, beim zweiten H liegt # oben | Abbruch: nicht akzeptiert |
Nichtdeterministische Kellerautomaten (NKA)
eA
Wir erweitern nun unsere bekannten Automaten um eine neue Klasse. Der zuletzt betrachtete Automat aus der Aufgabe „Vom DEA zum Kellerautomaten“ kann auch als Zustandsgraph dargestellt werden:
Generell gilt:
- Jede Kante ist so beschriftet:
(oberstes Kellerzeichen, Eingabezeichen) : abzulegende Zeichen. - Das gelesene oberste Kellerzeichen wird immer mit
pop()entfernt. - Mit
push()können auch mehrere Zeichen auf den Keller gelegt werden. Das am weitesten rechts notierte Zeichen kommt zuerst auf den Keller: Bei10#wird zuerst#und anschließend10abgelegt. - Ein \(\varepsilon\) als Eingabezeichen bedeutet, dass der Automat kein Zeichen liest und nur in Abhängigkeit vom obersten Kellerzeichen entscheidet, ob er den Übergang wählt (\(\varepsilon\)-Übergang). Im Beispiel geht es von \(q_1\) nach \(q_2\), wenn im Keller nur noch das Vorbelegungszeichen # liegt, das Guthaben also aufgebraucht ist.
- Ein \(\varepsilon\) als abzulegende Zeichen bedeutet, dass nichts abgelegt wird. Das gelesene, also mit
pop()entfernte Zeichen ist dann vom Keller verschwunden. - Gibt es für die aktuelle Situation keinen passenden Übergang, bricht der Automat ab. Das Wort wird auf diesem Weg nicht akzeptiert.
- Ein Wort wird akzeptiert, wenn der Automat das ganze Wort lesen kann und sich danach in einem Endzustand befindet.
Die Regel (#,10):10# im Zustand \(q_0\) interpretiert man wie folgt: Aktueller Zustand \(q_0\), gelesenes Stapelzeichen #, aktuelles Eingabezeichen 10 → Folgezustand \(q_1\), Stapeloperation push(#) und push(10). Befindet sich der Automat also im Zustand \(q_0\), liest das Eingabezeichen 10 und liegt im Keller nur das Vorbelegungszeichen #, wechselt er in den Zustand \(q_1\), legt # zurück und legt zusätzlich die 10 auf den Stapel.
(#,a) zu verschiedenen Folgezuständen oder eine Kante mit (#,a) neben einer \(\varepsilon\)-Kante mit (#,ε). Der Automat kann dann jeden dieser Übergänge wählen. Jede mögliche Folge von Übergängen heißt Rechenweg. Ein Wort wird akzeptiert, wenn es mindestens einen Rechenweg gibt, auf dem das Wort vollständig gelesen wird und der Automat danach in einem Endzustand ist. Rechenwege, die abbrechen oder nicht in einem Endzustand enden, spielen dann keine Rolle.Der Himbeerautomat ist deterministisch: In jeder Situation passt höchstens ein Übergang. Es gibt aber Sprachen, die nur ein nichtdeterministischer Kellerautomat erkennen kann, weil er beim Lesen „raten“ muss, welcher Fall vorliegt (siehe Aufgabe 9 unten).
| Regel | Zustand | Stapel oben | Eingabe | Folgezustand | Stapeloperation |
|---|---|---|---|---|---|
| 1 | \(q_0\) | # | 10 | \(q_1\) | push(#), push(10) |
| 2 | \(q_1\) | 10 | 10 | \(q_1\) | push(10), push(10) |
| 3 | \(q_1\) | 10 | H | \(q_1\) | – (nur pop) |
| 4 | \(q_1\) | # | \(\varepsilon\) | \(q_2\) | push(#) |
| 5 | \(q_2\) | # | 10 | \(q_1\) | push(#), push(10) |
Die folgende Abbildung zeigt Schritt für Schritt, wie der Himbeerautomat eine gültige und eine ungültige Eingabe verarbeitet: Welches Zeichen gelesen wird, welche Regel greift, in welchem Zustand sich der Automat befindet und was dabei auf dem Keller passiert.
Regelnummern wie in der Tabelle oben. Schreibweise: (oberstes Kellerzeichen, Eingabezeichen) : abzulegende Zeichen. Das gelesene oberste Kellerzeichen wird dabei immer entfernt; von den abzulegenden Zeichen kommt das am weitesten rechts notierte zuerst auf den Keller.
Im Zustandsgraphen über jedem Lauf steht R1 bis R5 für Regel 1 bis 5. 1 zeigt, in welchem Schritt die Regel angewendet wird; grau gezeichnete Übergänge kommen in diesem Lauf nicht vor; rot gestrichelt ist ein Übergang, den es nicht gibt: Dort bricht der Automat ab.
Tipp: Fahren Sie mit der Maus über einen Regelpfeil oder tippen Sie ihn an: Der Schritt wird erklärt und der passende Übergang im Zustandsgraphen hervorgehoben.
(#,10):10#liest 10nimmt # weglegt 10# abRegel 1 in q0: Oben im Keller liegt #, gelesen wird 10. Das gelesene # wird aus dem Keller entfernt. Hinter dem Doppelpunkt steht 10#: Das am weitesten rechts notierte Zeichen kommt zuerst auf den Keller, also erst #, dann 10. Der Automat wechselt nach q1. Die 10 im Keller steht für 10 Cent Guthaben.
(10,10):1010liest 10nimmt 10 weglegt 1010 abRegel 2 in q1: Oben liegt 10, gelesen wird wieder 10. Die gelesene 10 wird entfernt, abgelegt wird 1010, also zwei Zehner. Im Keller liegen jetzt zwei Münzen, also 20 Cent Guthaben. Der Zustand bleibt q1.
(10,H):εliest Hnimmt 10 weglegt nichts abRegel 3 in q1: Oben liegt 10, gelesen wird H. Die gelesene 10 wird entfernt, hinter dem Doppelpunkt steht ε: Es wird nichts abgelegt. Die Himbeere ist damit bezahlt, es bleiben 10 Cent Guthaben. Der Zustand bleibt q1.
(10,H):εliest Hnimmt 10 weglegt nichts abRegel 3 in q1: Wieder liegt 10 oben und H wird gelesen. Die letzte 10 wird entfernt und nichts abgelegt, oben liegt nur noch #: Das Guthaben ist aufgebraucht. Die Eingabe ist jetzt vollständig gelesen.
(#,ε):#liest nichts (ε)nimmt # weglegt # abRegel 4 in q1: Oben liegt #. Das ist ein ε-Übergang: Es wird kein Eingabezeichen gelesen. Das gelesene # wird entfernt und wieder abgelegt, der Keller sieht also aus wie vorher. Der Automat wechselt nach q2 („Guthaben aufgebraucht“). Die Eingabe ist vollständig verarbeitet und q2 ist Endzustand: Das Wort wird akzeptiert.
(#,10):10#liest 10nimmt # weglegt 10# abRegel 1 in q0: Oben im Keller liegt #, gelesen wird 10. Das gelesene # wird aus dem Keller entfernt. Hinter dem Doppelpunkt steht 10#: Das am weitesten rechts notierte Zeichen kommt zuerst auf den Keller, also erst #, dann 10. Der Automat wechselt nach q1. Die 10 im Keller steht für 10 Cent Guthaben.
(10,H):εliest Hnimmt 10 weglegt nichts abRegel 3 in q1: Oben liegt 10, gelesen wird H. Die gelesene 10 wird entfernt und nichts abgelegt, die erste Himbeere ist bezahlt. Oben liegt nur noch #: Es gibt kein Guthaben mehr, in der Eingabe wartet aber noch ein H.
(#,ε):#liest nichts (ε)nimmt # weglegt # abRegel 4 in q1: Oben liegt #. Regel 4 ist ein ε-Übergang: Sie liest kein Eingabezeichen, sondern hängt nur vom Zustand q1 und dem # oben ab. Das H wird also nicht verarbeitet, es bleibt stehen und ist im nächsten Schritt dran. Das gelesene # wird entfernt und wieder abgelegt, der Automat wechselt nach q2.
(#,H) in q2H nicht lesbar→ AbbruchKein passender Übergang: In q2 gibt es nur Regel 5 (#,10), hier darf also nur Geld eingeworfen werden. Für # oben und das Eingabezeichen H gibt es keinen Übergang. Der Automat bricht ab: Das zweite H kann nicht mehr gelesen werden, das Wort wird also nicht vollständig gelesen und nicht akzeptiert. Ohne Regel 4 wäre es genauso: Auch in q1 gibt es keinen Übergang für (#,H).Formale Definition eines NKA
Ein solcher Automat heißt nichtdeterministischer Kellerautomat (NKA), englisch pushdown automaton. Seine formale Definition ist ein 7-Tupel \((Q, \Sigma, \Gamma, \delta, s, \#, F)\), wobei die einzelnen Komponenten wie folgt definiert sind:
| Definition | Himbeerautomat | |
|---|---|---|
| \(Q\) | \(Q\) ist eine nicht leere, endliche Menge von Zuständen, in denen sich der Kellerautomat befinden kann. | \(Q = \{q_0, q_1, q_2\}\) |
| \(\Sigma\) | \(\Sigma\) ist ein nicht leeres, endliches Eingabealphabet. Das leere Wort \(\varepsilon\) gehört nicht dazu. | \(\Sigma = \{10, H\}\) |
| \(\Gamma\) | \(\Gamma\) ist ein nicht leeres, endliches Kelleralphabet. Es enthält alle Zeichen, die im Keller liegen können. | \(\Gamma = \{\#, 10\}\) |
| \(\delta\) | \(\delta\) ist die Übergangsrelation. Sie ordnet jeder Kombination aus aktuellem Zustand, Eingabezeichen oder \(\varepsilon\) und oberstem Kellerzeichen eine (eventuell leere) Menge von Möglichkeiten zu. Jede Möglichkeit besteht aus einem Folgezustand und den abzulegenden Zeichen. Enthält eine Menge mehr als eine Möglichkeit, arbeitet der Automat nichtdeterministisch. | siehe Tabelle der Aufgabe oben, z. B. \(\delta(q_0, 10, \#) = \{(q_1, 10\#)\}\) |
| \(s\) | \(s \in Q\) ist der Startzustand, in dem sich der Kellerautomat zu Beginn befindet. | \(s = q_0\) |
| \(\#\) | \(\# \in \Gamma\) ist das Vorbelegungszeichen: Zu Beginn liegt nur \(\#\) im Keller. | \(\#\) |
| \(F\) | \(F \subseteq Q\) ist die Menge der akzeptierenden Zustände (Endzustände). Es darf auch mehrere Endzustände geben. | \(F = \{q_2\}\) |
Aufgaben zu Grenzen endlicher Automaten – NKA
eA
In der Abbildung sehen Sie den Zustandsgraphen eines NKA. Ein leeres Wort wird auch akzeptiert.
Erstellen Sie die formale Notation des NKA in Form eines 7-Tupels.
Gehen Sie das 7-Tupel der Reihe nach durch: Q, Σ, Γ, δ, s, #, F. Γ enthält alle Zeichen, die im Keller liegen können.
Legen Sie für δ eine Tabelle an: Zustand, oberstes Kellerzeichen, Eingabe, Folgezustand, abzulegende Zeichen. Jede Zeile einer Kantenbeschriftung ist eine Regel.
Untersuchen Sie die Funktionsweise des NKA für die Wörter \(w_1 = aabb\), \(w_2 = baba\) und \(w_3 = aba\).
Notieren Sie nach jedem Schritt Zustand und Kellerinhalt, z. B. \(q_1\,[\#a]\) (oben rechts).
Ist das Wort gelesen, prüfen Sie, ob noch ein ε-Übergang möglich ist und ob der Automat danach in einem Endzustand ist.
Beschreiben Sie die Sprache, welche vom NKA akzeptiert wird.
Was steht im Keller, wenn mehr a als b gelesen wurden, was im umgekehrten Fall? Wann kann der Automat in den Endzustand wechseln?
Ein gängiges Problem beim Programmieren ist, dass Ausdrücke mit mehreren Klammerpaaren hinsichtlich ihrer Korrektheit geprüft werden müssen. Dies übernimmt unter anderem ein sogenannter Parser, verkürzt gesagt ein Programm, das Code auf seine syntaktische (grammatische) Korrektheit prüft. Wir beschränken uns zunächst auf Klammerausdrücke ohne nebeneinanderliegende Klammerpaare, also z. B. {{{}}}, aber nicht {{}{}}.
Im Java-Code if (b == true) { a = a + 1; fehlt die schließende Klammer. Man kann annehmen, dass sich der Parser ab der geöffneten Klammer gemerkt hat: „Es fehlt eine geschlossene Klammer.“ Korrekte Klammerausdrücke bis zur Tiefe 2 sind {} und {{}}. Nicht korrekt sind z. B. }{ oder }{}{ und {}}}. Modelliert man die Prüfung bis zur Tiefe 2 als DEA, ergibt sich der folgende Zustandsgraph:
Entwickeln Sie den Zustandsgraphen eines DEA, der Klammerpaare aus geschweiften Klammern bis zu einer Tiefe von 3 auf ihre Korrektheit überprüft.
Die Zustände merken sich, wie viele Klammern gerade offen sind: 0, 1, 2 oder 3.
Eine schließende Klammer bei Tiefe 0 und eine vierte öffnende Klammer führen in den Fehlerzustand.
Erläutern Sie, wie sich der Zustandsgraph aus a) ändert, wenn die maximale Tiefe auf 4 erhöht wird.
Was kommt hinzu, wenn eine Klammer mehr offen sein darf?
Erläutern Sie, dass es keinen endlichen Automaten geben kann, der einen einfach geschachtelten Klammerausdruck mit beliebiger Tiefe auf seine Korrektheit prüfen kann.
Jede weitere Tiefe braucht einen weiteren Zustand. Wie viele Zustände bräuchte man für jede beliebige Tiefe – und wie viele hat ein endlicher Automat?
Entwickeln Sie einen NKA in Form eines Zustandsgraphen, der einfach geschachtelte Klammerausdrücke beliebiger Tiefe überprüfen kann.
Legen Sie für jede öffnende Klammer ein Zeichen in den Keller und entfernen Sie für jede schließende Klammer eines.
Akzeptiert wird, wenn am Ende nur noch # im Keller liegt. Dazu dient ein ε-Übergang in den Endzustand.
Diese Aufgabe wurde von Jana Tholen (Osnabrück, 2025) erstellt und verändert.
Für die Sprache \(L = \{w \mid w = a^n b c^n;\ n \in \mathbb{N}_0\}\) soll ein NKA entworfen werden, der Akzeptor der Sprache ist. \(\mathbb{N}_0\) bezeichnet die natürlichen Zahlen einschließlich der 0. Hierfür gibt es drei Vorschläge:
Beurteilen Sie die Lösungsvorschläge und korrigieren Sie gegebenenfalls Fehler, sodass die Automaten korrekt arbeiten.
Testen Sie jeden Vorschlag mit b, abc, aabcc und mit fehlerhaften Wörtern wie aabc, abcc oder ac.
Achten Sie darauf, ob am Ende geprüft wird, dass nur noch # im Keller liegt, und ob das Wort b (n = 0) akzeptiert wird.
Verändern Sie eine korrekte Lösung so, dass der Automat für \(n \in \mathbb{N}\) (also ohne die 0) korrekt funktioniert.
Der Automat muss mindestens ein a lesen, bevor b erlaubt ist. Welcher Übergang erlaubt bisher ein b ohne vorheriges a?
Nun soll ein Klammerausdruck auch mit geschachtelten Klammern auf seine Korrektheit überprüft werden. Korrekte Ausdrücke dieser Art sind z. B. {{}}{}, {{}{}} oder {}{}. Auch ein leerer Klammerausdruck wird akzeptiert.
Entwickeln Sie einen NKA als Zustandsgraph und in formaler Notation, welcher genau diese Klammerausdrücke akzeptiert.
Der Unterschied: Nach einer schließenden Klammer darf wieder eine öffnende kommen.
Öffnen und Schließen können im selben Zustand stattfinden. Ein ε-Übergang mit # oben führt in den Endzustand.
Untersuchen Sie in jedem Aufgabenteil, ob die Situation durch einen DEA realisiert werden kann. Entwerfen Sie dann einen geeigneten DEA oder gegebenenfalls NKA als Zustandsgraph und mit formaler Definition (5-Tupel bzw. 7-Tupel).
Ein Automat soll genau die folgenden Eingaben akzeptieren: Das Eingabealphabet sind die Ziffern 0, …, 9. Die Ziffer 1 kommt genau doppelt so häufig vor wie die Ziffer 0. Nachdem die erste 1 im Wort auftaucht, dürfen keine Nullen mehr kommen.
Muss sich der Automat eine unbegrenzte Anzahl merken? Dann reicht ein DEA nicht.
Legen Sie für jede 0 zwei Zeichen in den Keller und entfernen Sie für jede 1 eines. Andere Ziffern ändern den Keller nicht.
Die Eingabewörter (alle Kleinbuchstaben sind möglich) müssen mit „abc“ beginnen und auf „xyz“ enden.
Hier muss sich der Automat nur merken, wie viel von abc bzw. xyz schon gelesen wurde. Das sind endlich viele Möglichkeiten.
Ein Automat soll Akzeptor der Sprache \(L = \{w \mid w = a^n b^m c^{n+m} d;\ n, m \in \mathbb{N}\}\) sein.
Erläutern Sie, weshalb ein DEA nicht geeignet ist.
Was müsste sich ein DEA merken, um die Anzahl der c zu prüfen? Ist diese Anzahl begrenzt?
Entwerfen Sie einen NKA in Form eines Zustandsgraphen, der Akzeptor der Sprache \(L\) ist.
Legen Sie für jedes a und jedes b dasselbe Zeichen in den Keller.
Entfernen Sie für jedes c ein Zeichen. Am Ende muss d gelesen werden und nur noch # im Keller liegen.
Ein Zug aus \(n\) unterscheidbaren Wagen \(\{w_1, \dots, w_n\}\) befindet sich wie abgebildet auf Gleis \(G_1\) einer Rangieranlage. \(G_2\) und \(G_3\) sind leer. Die Gleisanlage ist mit einem Automaten verbunden, der für die angegebenen Eingaben die zugeordneten Aktionen ausführt.
| Eingabe | Aktion |
|---|---|
| 1 | Falls \(G_1\) nicht leer: rangiere den ersten Wagen von \(G_1\) nach \(G_2\); sonst Fehler |
| 2 | Falls \(G_2\) nicht leer: rangiere den ersten Wagen von \(G_2\) nach \(G_3\); sonst Fehler |
Interpretieren Sie die Eingabefolge 112122 für einen Zug mit mindestens drei Wagen und geben Sie die Reihenfolge der Wagen (von links nach rechts) auf \(G_3\) an.
Notieren Sie nach jeder Eingabe, welche Wagen auf \(G_1\), \(G_2\) und \(G_3\) stehen. \(G_2\) funktioniert wie ein Stapel.
Geben Sie die Eingabefolge an, die bei einem Zug mit 4 Wagen die beiden mittleren Wagen tauscht.
Auf \(G_2\) kehrt sich die Reihenfolge um. Welche zwei Wagen müssen gleichzeitig auf \(G_2\) stehen?
Geben Sie eine mindestens dreielementige Eingabefolge an, die in einen Fehlerzustand führt, und begründen Sie Ihre Wahl.
Ein Fehler entsteht, wenn von einem leeren Gleis rangiert werden soll. Wann ist \(G_2\) leer?
Die Sprache \(L\) sei die Menge aller Eingabefolgen, die zu keinem Fehlerzustand führen und einen Zug beliebiger Länge vollständig von \(G_1\) nach \(G_3\) rangieren. Beschreiben Sie \(L\) und definieren Sie einen geeigneten Automaten, der \(L\) akzeptiert.
Zu jedem Zeitpunkt dürfen nicht mehr Zweien als Einsen gelesen sein, und am Ende muss die Anzahl gleich sein. Woran erinnert das?
Ein Kellerautomat kann \(G_2\) direkt nachbilden: 1 legt ein Zeichen ab, 2 entfernt eines.
Aus Informatik 2, Schöningh Verlag (abgewandelt)
An einer Saftbar soll ein Mixgetränkeautomat dem Personal zu Stoßzeiten helfen. Der Automat kann nur eine begrenzte Zahl an Getränken herstellen und die folgenden Aktionen ausführen: c: Cola hinzufügen, w: Waldmeistersirup hinzufügen, m: mit dem Mixlöffel rühren, s: mit dem Shaker schütteln. Die Regeln zum Mixen sind:
- Alle Zutaten werden auf jeden Fall in den Shaker gegeben, aber nicht unbedingt geschüttelt.
- Cola darf niemals alleine mit dem Mixlöffel gerührt werden.
- Waldmeistersirup kann nicht pur angeboten werden.
- Es wird entweder geschüttelt oder gerührt.
- Das Getränk muss in einem Glas mit Strohhalm serviert werden.
- Unsinnige Aktionen, wie Rühren ohne Zutaten oder mehrfaches Rühren oder Mixen, gibt es nicht.
- Das Füllen ins Glas soll unbeachtet bleiben.
- Cola oder Waldmeistersirup dürfen jeweils maximal einmal ins Glas gefüllt werden.
Geben Sie je zwei strukturell verschiedene gültige und ungültige Eingaben für den Mixautomaten an. Entwerfen Sie einen DEA als Zustandsgraph und in formaler Definition, der den Mixautomaten darstellt.
Streichen Sie zuerst die Regeln, die mit dem Automaten nichts zu tun haben (z. B. das Glas).
Die Zustände merken sich, welche Zutaten schon im Shaker sind und ob schon gerührt oder geschüttelt wurde.
Der Betreiber der Saftbar entscheidet, die Getränke in Flaschen abzufüllen und zu verkaufen. Die Getränke werden nun in einem deutlich größeren Mixbehälter von einem großen Rührer gemixt und die Regeln wurden verändert: a steht für Abfüllen, r für Rühren, die anderen Eingaben sind wie bisher. Die Abbildung zeigt den Zustandsgraphen eines neuen DEA.
- Geben Sie ein Wort maximaler Länge an, das genau ein r enthält und akzeptiert wird. Begründen Sie, warum es kein längeres Wort geben kann.
- Analysieren Sie, ob der gegebene Automat minimal ist.
- Analysieren Sie, welche Mischverhältnisse zwischen den Zutaten zulässig sind.
Suchen Sie einen Weg vom Start zum Endzustand, der genau eine r-Kante benutzt und dabei möglichst viele andere Kanten.
Zwei Zustände dürfen nur zusammengelegt werden, wenn von beiden aus genau dieselben Restwörter akzeptiert werden.
Eine clevere Mitarbeiterin hat den Mixautomaten umprogrammiert. Zulässige Wörter sind nun nur noch Palindrome aus Cola und Waldmeistersirup, die zu Beginn und am Ende aus w's und dazwischen aus c's bestehen. In der Wortmitte muss ein x stehen. Am Ende wird nur noch umgerührt und abgefüllt.
Geben Sie je ein zulässiges und ein unzulässiges Wort an. Entwerfen Sie einen NKA in Form eines Zustandsgraphen, der die neue Sprache akzeptiert.
Legen Sie alle Zeichen vor dem x in den Keller.
Nach dem x muss jedes gelesene Zeichen mit dem obersten Kellerzeichen übereinstimmen und wird entfernt. Danach folgen noch r und a.
Gegeben ist die Sprache \(L = \{a^n b^m \mid n \geq 1 \text{ und } m = n \text{ oder } m = 2n\}\). Zu \(L\) gehören z. B. ab, abb, aabb und aabbbb, nicht aber aabbb. Der folgende Kellerautomat akzeptiert \(L\). Im Zustand \(q_0\) hat er für dieselbe Situation (oben #, kein Eingabezeichen) zwei Übergänge.
Geben Sie für die Wörter aabb, aabbbb und aabbb jeweils beide Rechenwege an (Zustand und Kellerinhalt nach jedem Schritt). Entscheiden Sie jeweils, ob das Wort akzeptiert wird.
Der Automat liest im ersten Schritt kein Zeichen. Er wechselt über einen \(\varepsilon\)-Übergang entweder nach \(q_1\) oder nach \(q_3\). Verfolgen Sie beide Möglichkeiten getrennt.
Im oberen Zweig (\(q_1\)) wird für jedes a ein A abgelegt, im unteren Zweig (\(q_3\)) zwei. Jedes b entfernt genau ein A.
Ein Rechenweg endet erfolgreich, wenn das ganze Wort gelesen ist und der Automat danach (eventuell über einen \(\varepsilon\)-Übergang) in \(q_5\) ist.
Erläutern Sie, an welcher Stelle der Automat nichtdeterministisch arbeitet und warum er sich dort noch nicht sicher richtig entscheiden kann.
Suchen Sie die Situation, in der zwei Übergänge mit demselben obersten Kellerzeichen und demselben Eingabezeichen (hier \(\varepsilon\)) passen.
Ob m = n oder m = 2n gilt, entscheidet sich erst an der Anzahl der b. Wann liest der Automat die b?
Begründen Sie mit der Akzeptanzbedingung, warum aabb akzeptiert wird, obwohl einer der beiden Rechenwege nicht in einem Endzustand endet.
Lesen Sie im Kasten „Nichtdeterminismus“ nach: Wie viele erfolgreiche Rechenwege braucht ein Wort?
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Musterlösung zu den Aufgaben 1 bis 9
Zu Aufgabe 1 a): \(Q = \{q_0, q_1, q_2\}\), \(\Sigma = \{a, b\}\), \(\Gamma = \{\#, a, b\}\), \(s = q_0\), Vorbelegungszeichen #, \(F = \{q_0\}\)
| Zustand | Stapel oben | Eingabe | Folgezustand | Stapeloperation |
|---|---|---|---|---|
| \(q_0\) | # | a | \(q_1\) | push(#), push(a) |
| \(q_1\) | a | a | \(q_1\) | push(a), push(a) |
| \(q_1\) | a | b | \(q_1\) | – (a wird entfernt) |
| \(q_1\) | # | \(\varepsilon\) | \(q_0\) | push(#) |
| \(q_0\) | # | b | \(q_2\) | push(#), push(b) |
| \(q_2\) | b | b | \(q_2\) | push(b), push(b) |
| \(q_2\) | b | a | \(q_2\) | – (b wird entfernt) |
| \(q_2\) | # | \(\varepsilon\) | \(q_0\) | push(#) |
Zu Aufgabe 1 b) (Stapelinhalt in eckigen Klammern, oben rechts):
- \(w_1 = aabb\): \(q_0\,[\#] \xrightarrow{a} q_1\,[\#a] \xrightarrow{a} q_1\,[\#aa] \xrightarrow{b} q_1\,[\#a] \xrightarrow{b} q_1\,[\#] \xrightarrow{\varepsilon} q_0\,[\#]\) → Endzustand, akzeptiert.
- \(w_2 = baba\): \(q_0 \xrightarrow{b} q_2\,[\#b] \xrightarrow{a} q_2\,[\#] \xrightarrow{\varepsilon} q_0 \xrightarrow{b} q_2\,[\#b] \xrightarrow{a} q_2\,[\#] \xrightarrow{\varepsilon} q_0\) → akzeptiert.
- \(w_3 = aba\): \(q_0 \xrightarrow{a} q_1\,[\#a] \xrightarrow{b} q_1\,[\#] \xrightarrow{\varepsilon} q_0 \xrightarrow{a} q_1\,[\#a]\) → Eingabe zu Ende, kein Endzustand, nicht akzeptiert.
Zu Aufgabe 1 c): Der Automat akzeptiert alle Wörter aus a und b mit gleich vielen a wie b.
Zu Aufgabe 2 a):
Zu Aufgabe 2 b): Man bräuchte zwei weitere Zustände, da das Öffnen und Schließen der weiteren Klammer geprüft werden muss.
Zu Aufgabe 2 c): Für jedes weitere Klammerpaar werden weitere Zustände notwendig. Um alle möglichen Tiefen prüfen zu können, müsste sich der Automat jede Tiefe merken können. Er bräuchte also unendlich viele Zustände.
Zu Aufgabe 2 d): In \(q_1\) werden nur Klammern geöffnet, in \(q_2\) nur geschlossen. Nach der ersten schließenden Klammer darf keine Klammer mehr geöffnet werden, deshalb wird z. B. {{}{}} abgelehnt.
Zu Aufgabe 3 a): Vorschlag 1 arbeitet korrekt. Die Schleifen bei \(q_0\) legen mindestens ein a am Wortanfang in den Stapel. Die Übergänge zu \(q_1\) gelten für den Fall, dass es kein a gibt oder alle a abgearbeitet wurden und das b kommt. Die Schleife bei \(q_1\) löscht mit den c nach dem b die a aus dem Stapel. Der Übergang zu \(q_2\) ist nötig, da im Keller nur noch # liegen darf, wenn das Wort nur „b“ war oder gleich viele a und c enthielt.
Vorschlag 2 arbeitet ebenfalls korrekt. Der obere Weg ist für das Wort „b“, der untere für alle Wörter mit mindestens einem a und gleich vielen c.
Vorschlag 3 hat mehrere Probleme (Nummern siehe Abbildung):
- Bei 1. muss erst # und dann a auf den Stapel gelegt werden, sonst ist # verschwunden und ein a zu viel auf dem Stapel.
- Bei 2. müsste das gelesene a wieder auf den Stapel gelegt werden. Da bei Fehler 1 genau ein a zu viel auf den Stapel gelegt wurde, korrigiert sich dieser Fehler hier wieder. Es bleibt das Problem, dass # fehlt.
- Fehler 3 bewirkt, dass ein c kein a löscht.
- Fehler 4 ist mehrschichtig: Es gibt kein # am unteren Ende des Stapels, außerdem wird # nicht wieder auf den Stapel gelegt. Der Automat würde in \(q_4\) enden.
- Bei Fehler 5 wird beim Wort „b“ das Zeichen # nicht wieder auf den Stapel gelegt. Der Automat würde in \(q_1\) enden.
Zu Aufgabe 3 b): Vorschlag 1 würde die neuen Anforderungen z. B. so erfüllen:
Zu Aufgabe 4:
Zu Aufgabe 5 a): Ein DEA ist nicht möglich, da er sich die Anzahl der Nullen merken müsste. Ein möglicher NKA:
Zu Aufgabe 5 b): Hier genügt ein DEA (nx bedeutet „alle Zeichen außer x“):
Zu Aufgabe 6 a): Ein DEA müsste sich alle möglichen Summen von a und b merken, um die Anzahl der c zu prüfen. Da n und m nicht begrenzt sind, bräuchte er unendlich viele Zustände.
Zu Aufgabe 6 b):
Zu Aufgabe 7 a): Anfangsbelegung von Gleis 1: \(w_1, w_2, \dots, w_n\). Gleis 1 und Gleis 3 sind wie in der Abbildung von links nach rechts notiert, bei Gleis 2 steht der zuletzt eingefahrene Wagen rechts.
| Taste | 1 | 1 | 2 | 1 | 2 | 2 |
|---|---|---|---|---|---|---|
| Gleis 1 | w2,…,wn | w3,…,wn | w3,…,wn | w4,…,wn | w4,…,wn | w4,…,wn |
| Gleis 2 | w1 | w1,w2 | w1 | w1,w3 | w1 | – |
| Gleis 3 | – | – | w2 | w2 | w2,w3 | w2,w3,w1 |
Auf Gleis 3 stehen am Ende von links nach rechts w2, w3, w1.
Zu Aufgabe 7 b): 12112212. Auf Gleis 3 stehen danach w1, w3, w2, w4.
Zu Aufgabe 7 c): z. B. 212, da zu Beginn \(G_2\) leer ist und die erste 2 sofort einen Fehler auslöst.
Zu Aufgabe 7 d): \(L\) besteht aus Wörtern beliebiger Länge aus den Zeichen 1 und 2 mit gleich vielen Einsen und Zweien, wobei an jeder Stelle die Anzahl der bisherigen Einsen nicht kleiner sein darf als die Anzahl der bisherigen Zweien (\(G_2\) arbeitet wie ein Stapel). Ein möglicher NKA:
Im Keller liegt für jeden Wagen auf \(G_2\) eine 1. Liegt nur noch # im Keller, ist Gleis 2 leer, und der Automat wechselt in den Endzustand. Von dort kann ein weiterer Wagen nach \(G_2\) rangiert werden.
Zu Aufgabe 8 a): Einige Vorgaben haben mit dem Automaten nichts zu tun: Regel 1 (alle Zutaten in den Shaker), Regel 5 (Glas mit Strohhalm) und Regel 7 (Füllen ins Glas). Gültig sind z. B. cws und cs, ungültig z. B. cm und ws. Ein möglicher DEA (Endzustand \(q_2\)):
Zu Aufgabe 8 b): Ein längstes Wort mit genau einem r hat die Länge 6, z. B. wwccra, wccwra, cwcwra oder ccwwra. Da höchstens zweimal c und zweimal w möglich sind, ein r enthalten und am Ende abgefüllt (a) werden muss, kann es kein längeres Wort geben; jede weitere Schleife würde ein weiteres r einfügen. Der Automat ist nicht minimierbar: Zu je zwei Zuständen gibt es ein Restwort, das nur von einem der beiden aus akzeptiert wird (z. B. \(q_3\) und \(q_6\): ca).
Zulässige Mischverhältnisse (Cola : Waldmeistersirup): 1 : 0 und 2 : 0 (reine Cola, beliebig oft oder gar nicht gerührt), 1 : 1, 2 : 1 und 2 : 2 (nach der letzten Zutat genau einmal gerührt). Nicht zulässig sind Waldmeistersirup allein und 1 : 2, denn von \(q_5\) aus gibt es keinen Übergang mit r oder a. Kurz: Es darf nie mehr Waldmeistersirup als Cola sein.
Zu Aufgabe 8 c): Zulässig ist z. B. wwcxcwwra, unzulässig z. B. wcxccwra. Ein möglicher NKA:
Zu Aufgabe 9 a) (Kellerinhalt in eckigen Klammern, oben rechts):
aabb, Weg über \(q_1\): \(q_0\,[\#] \xrightarrow{\varepsilon} q_1\,[\#] \xrightarrow{a} q_1\,[\#A] \xrightarrow{a} q_1\,[\#AA] \xrightarrow{b} q_2\,[\#A] \xrightarrow{b} q_2\,[\#] \xrightarrow{\varepsilon} q_5\,[\#]\) → ganzes Wort gelesen, Endzustand.
Weg über \(q_3\): \(q_0\,[\#] \xrightarrow{\varepsilon} q_3\,[\#] \xrightarrow{a} q_3\,[\#AA] \xrightarrow{a} q_3\,[\#AAAA] \xrightarrow{b} q_4\,[\#AAA] \xrightarrow{b} q_4\,[\#AA]\) → Wort zu Ende, \(q_4\) ist kein Endzustand.
Akzeptiert, weil der erste Weg erfolgreich ist.aabbbb, Weg über \(q_1\): nachaabbin \(q_2\,[\#]\). Für das dritte b gibt es keinen Übergang (auch nicht von \(q_5\) aus) → Abbruch.
Weg über \(q_3\): \(\dots \xrightarrow{b} q_4\,[\#AAA] \xrightarrow{b} q_4\,[\#AA] \xrightarrow{b} q_4\,[\#A] \xrightarrow{b} q_4\,[\#] \xrightarrow{\varepsilon} q_5\,[\#]\) → Endzustand. Akzeptiert.aabbb, Weg über \(q_1\): Abbruch beim dritten b wie eben. Weg über \(q_3\): Nach drei b ist der Automat in \(q_4\,[\#A]\), das Wort ist zu Ende, \(q_4\) ist kein Endzustand. Nicht akzeptiert, weil kein Rechenweg erfolgreich ist.
Zu Aufgabe 9 b): Nichtdeterministisch ist der Start in \(q_0\): Für oben # und \(\varepsilon\) gibt es zwei Übergänge, nach \(q_1\) (ein A je a, also Fall m = n) und nach \(q_3\) (zwei A je a, also Fall m = 2n). Welcher Fall vorliegt, zeigt erst die Anzahl der b. Die b kommen aber erst, nachdem alle a gelesen und im Keller gezählt sind. Der Automat muss sich also entscheiden, bevor er die nötige Information hat: Er „rät“. Man kann zeigen, dass kein deterministischer Kellerautomat diese Sprache akzeptiert.
Zu Aufgabe 9 c): Ein Wort wird akzeptiert, wenn es mindestens einen Rechenweg gibt, auf dem das ganze Wort gelesen wird und der Automat danach in einem Endzustand ist. Für aabb leistet das der Weg über \(q_1\). Dass der Weg über \(q_3\) in \(q_4\) endet, spielt keine Rolle.
Formale Sprachen
eA
Reguläre Sprachen
Der Imbissroboter aus dem Aquapark (Material Jahrgang 10) soll nun Bestellungen für verschiedene Gerichte und Komponenten aufnehmen können. Dazu muss er prüfen, ob diese korrekt eingegeben wurden.
a) Betrachten Sie die Abbildung und diskutieren Sie, welche Speisen beim Imbissroboter bestellt werden können. Der Roboter startet bei „Start“, kann nur in Pfeilrichtung (von oben nach unten durch die Kästen) und nicht rückwärts gehen. Ein lilafarbenes Kästchen mit Großbuchstaben verweist auf das gleichnamige Diagramm. Am Ende eines Diagramms ist eine Bestellung aufgenommen.
b) Entscheiden Sie, für welche der Gerichte keine, mindestens eine, maximal eine, genau eine, mindestens zwei, maximal zwei oder genau zwei weitere Komponenten bestellt werden können bzw. müssen.
c) Verändern Sie das Diagramm durch weitere Speisen/Getränke so, dass die Fälle, die in b) nicht auftauchen, im Diagramm vorkommen.
c) Eine Erweiterung für „maximal zwei“ könnte z. B. ein weiterer Burger sein:
Start → … | Burger E, E → ε | Bacon | Käse | Bacon F | Käse F, F → ε | Bacon | Käse.Fazit: Die Abbildung, auch Syntaxdiagramm genannt, zeigt die Produktionsregeln aller bestellbaren Speisen. Beim Start kann man sich entscheiden, ob man mit Pizzaschnecke, Pommes, Burger_vegan oder Salat startet. Je nach Speise ist es möglich, weitere Komponenten hinzuzufügen. Dies kann man auch mit einem Ableitungsbaum darstellen:
Zur Bildung eines Wortes startet man immer mit einem Startsymbol S, einer Art Variable, die man als Nichtterminal bezeichnet. Für unsere Speisen kann S direkt durch ein Zeichen der Sprache, ein Terminal, ersetzt werden (nur Pizzaschnecke steht allein) oder durch Pommes, Burger_vegan oder Salat zusammen mit einem weiteren Nichtterminal A, B oder C rechts davon. Anschließend muss z. B. das Nichtterminal A durch Mayonnaise oder Ketchup ersetzt werden.
Nun können wir die Grammatik der Sprache der Speisen als 4-Tupel \(G = (N, T, S, P)\) angeben. Die Grammatik beschreibt, wie die Wörter erzeugt werden; die Sprache \(L(G)\) ist die Menge aller Wörter, die so erzeugt werden können.
| Definition | Speisen | |
|---|---|---|
| \(N\) | Nicht leere, endliche Menge der Nichtterminale (Hilfssymbole) für die Erzeugung von Wörtern. | \(N = \{S, A, B, C, D\}\) |
| \(T\) | Nicht leere, endliche Menge der Terminale. Dies sind die Buchstaben oder Silben, die in Wörtern der Sprache vorkommen. \(N\) und \(T\) haben keine gemeinsamen Elemente. | \(T = \{\)Pizzaschnecke, Pommes, Burger_vegan, Salat, Mayonnaise, Ketchup, Jalapenos, Avocado, Tofu, Garnelen, Putenbrust\(\}\) |
| \(S\) | Startsymbol. Eines der Nichtterminale muss als Startsymbol definiert werden. Damit startet die Bildung aller Wörter der Sprache. | S |
| \(P\) | Produktionsregeln. Dies sind alle Erzeugungsregeln der Wörter. Das Zeichen \(\varepsilon\) steht für das leere Wort und ist kein Terminal: Die Regel B → ε bedeutet, dass B durch nichts ersetzt wird. | S → Pizzaschnecke | Pommes A | Burger_vegan B | Salat C |
a) Analysieren Sie die Produktionsregeln und erläutern Sie, wie diese zu verstehen sind.
b) Vergleichen Sie die Definition einer regulären Sprache mit anderen bekannten Informatiksystemen, die eine ähnliche Darstellung haben.
b) Es gibt deutliche Gemeinsamkeiten mit einem DEA: Die Nichtterminale entsprechen den Zuständen, die Terminale den Eingabezeichen, das Startsymbol dem Startzustand und die Produktionsregeln den Zustandsübergängen.
Unser Beispiel der Speisen ist eine reguläre Sprache. Eine Sprache heißt regulär, wenn es eine reguläre Grammatik gibt, die sie erzeugt. Eine reguläre Grammatik ist entweder rechtsregulär oder linksregulär. Üblich ist die rechtsreguläre Form, die wir im Folgenden verwenden.
| Eine Grammatik \(G = (N, T, S, P)\) heißt linksregulär bzw. rechtsregulär, wenn alle Produktionsregeln die folgende Form haben: | |
|---|---|
| linksregulär | rechtsregulär |
| Ein Nichtterminal → ein Terminal (Bsp.: A → +) oder Ein Nichtterminal → ein Nichtterminal und ein Terminal (Bsp.: S → A Mayonnaise) oder Ein Nichtterminal → ε (Bsp.: B → ε) | Ein Nichtterminal → ein Terminal (Bsp.: A → +) oder Ein Nichtterminal → ein Terminal und ein Nichtterminal (Bsp.: S → Pommes A) oder Ein Nichtterminal → ε (Bsp.: B → ε) |
| Die Wörter werden von rechts nach links aufgebaut: S → A Mayonnaise → Pommes Mayonnaise | Die Wörter werden von links nach rechts aufgebaut: S → Pommes A → Pommes Mayonnaise |
Aufgaben zu regulären Sprachen
| syntaktisch korrekt | syntaktisch nicht korrekt | |
|---|---|---|
| Schulnoten | 1-, 2+, 5-, 6+ | 1+, 6-, 3+-, -4 |
| Uhrzeit | 10:05, 23:54, 02:31 | 10::05, 23:5544, 06:89 |
| Autokennzeichen | OS-AB-1234, HH-CD-23, M-E-1 | OS AB 1234, HHCD 23, M 1-E |
| Terme | (1+2)*(5-4), 3*(15-4), 9-(2+4) | )1+2)*(5-4), 3()*(15-), 9+-2+4) |
Geben Sie für die Schulnoten, die Uhrzeit und die Autokennzeichen die formalen Definitionen der Sprachen an. Bei den Autokennzeichen gilt: 1 bis 3 Buchstaben für den Zulassungsort, dann ein -, gefolgt von 1 bis 2 Buchstaben, ein - und 1 bis 4 Ziffern.
Geben Sie jeweils eine Grammatik \(G = (N, T, S, P)\) an. Beginnen Sie mit den Terminalen: Welche Zeichen kommen vor?
Bauen Sie die Wörter von links nach rechts auf. Jedes Nichtterminal steht für „was noch fehlt“, z. B. bei der Uhrzeit „zweite Ziffer der Stunde“.
Schulnoten: 1+ und 6- gibt es nicht. Uhrzeit: Nach einer 2 als erster Ziffer sind nur 0 bis 3 möglich.
Entscheiden Sie, ob es sich bei diesen Beispielen um reguläre Sprachen handelt.
Lässt sich eine reguläre Grammatik (oder ein DEA) angeben? Problematisch sind Strukturen, bei denen man beliebig viel zählen muss, z. B. geschachtelte Klammern.
Für Terme mit Klammerpaaren der maximalen Tiefe 1 (keine geschachtelten Klammern wie (())) und nur +, - oder * ist der folgende Vorschlag gegeben:
N = {S, A, B, C, D, E, F}, T = {0-9, 1-9, +, -, *, (, )}, Startsymbol S
S → 0-9 | 0-9 A | 1-9 B | ( C
A → + S | - S | * S
B → 0-9 | 0-9 B | 0-9 S
C → 0-9 F | 0-9 D | 1-9 E
D → + C | - C | * C
E → 0-9 F | 0-9 E | 0-9 C
F → ) | ) A
Beurteilen Sie den Vorschlag und diskutieren Sie, welche Änderungen notwendig werden, wenn 1. ein weiteres Klammerpaar erlaubt ist, 2. die Division hinzukommt, 3. eine beliebige Klammertiefe erlaubt ist.
Leiten Sie einige korrekte Terme ab und versuchen Sie, auch fehlerhafte Terme abzuleiten. Werden alle Terme erzeugt, und nur diese?
Was müsste die Grammatik sich merken, wenn beliebig viele Klammern geschachtelt werden dürfen?
Erstellen Sie je ein Syntaxdiagramm für die formale Sprache
a) \(L_{Klasse}\) mit den syntaktisch korrekten Wörtern wie 5a, 8c oder 11e. Die Klassen 5–10 sind maximal vierzügig, der Jahrgang 11 ist maximal sechszügig.
b) \(L_{Uhr}\) der Uhrzeiten aus Aufgabe 1.
c) \(L_{\mathbb{N}}\), die Sprache der natürlichen Zahlen.
d) \(L_{\mathbb{Z}}\), die Sprache der ganzen Zahlen.
Ein Syntaxdiagramm liest man in Pfeilrichtung. Verzweigungen sind Alternativen, Rückwärtspfeile Wiederholungen.
Trennen Sie die Jahrgänge 5–10 (Buchstaben a–d) und 11 (Buchstaben a–f) in zwei Zweige.
Natürliche Zahlen beginnen nicht mit 0 (außer der 0 selbst). Für die ganzen Zahlen kommt ein optionales Minuszeichen vor einer Zahl ungleich 0 hinzu.
In einer Stadt gibt es die U-Bahnlinien U74 bis U79, die S-Bahnlinien S1 bis S6 und die Buslinien 701 bis 716. Erstellen Sie eine reguläre Grammatik und ein Syntaxdiagramm der Sprache \(L_{ÖPNV}\), die aus den Bezeichnungen aller Fahrzeuge besteht.
Unterscheiden Sie im Startsymbol drei Zweige: U-Bahn, S-Bahn und Bus.
Bei U74 bis U79 ist die erste Ziffer immer 7, die zweite 4 bis 9. Bei 701 bis 716 lohnt sich eine Fallunterscheidung nach der zweiten Ziffer.
Erläutern Sie, weshalb die Grammatik \(G = (\{S, N\}, \{0, 1\}, S, P)\) mit den Produktionsregeln S → 1 | 1 N und N → 0 | N 0 nicht regulär ist.
Vergleichen Sie jede Regel mit den erlaubten Formen. Steht ein Nichtterminal links oder rechts vom Terminal? Sind beide Formen gemischt?
Zeigen Sie, dass die von dieser Grammatik erzeugte Sprache trotzdem regulär ist.
Schreiben Sie einige Wörter auf, die die Grammatik erzeugt. Wie sehen sie aus?
Geben Sie eine rechtsreguläre Grammatik oder einen DEA für dieselbe Sprache an.
In der lal-Sprache \(L_{lal}\) können nur die Silben la, le und lu in einem Wort vorkommen. Diese können beliebig kombiniert werden, aber am Ende jedes Wortes muss lu stehen. Ein Wort besteht aus genau drei Silben. Erstellen Sie eine reguläre Grammatik für \(L_{lal}\).
Nehmen Sie la, le und lu als Terminale. Jedes Nichtterminal steht für die Anzahl der noch fehlenden Silben.
In der hawaiianischen Sprache gibt es nur die Vokale a, e, i, o, u und die Konsonanten h, k, l, m, n, p, w. Alle Wörter sind nach der folgenden Regel aufgebaut: 1. Einem Vokal können beliebig viele Vokale folgen. 2. Nach einem Konsonanten muss ein Vokal folgen, es darf kein weiterer Konsonant stehen. Beispiele: „kumu“ (Lehrer), „wikiwiki“ (schnell bzw. eifrig), „hula“ (Sammelbegriff für hawaiianische Tänze). Erstellen Sie eine reguläre Grammatik für die hawaiianische Sprache.
Unterscheiden Sie mit zwei Nichtterminalen, ob zuletzt ein Vokal oder ein Konsonant stand.
Ein Wort darf nur nach einem Vokal enden. Wo braucht die Grammatik deshalb eine Regel mit einem einzelnen Terminal?
Eine Kaffeemaschine wird mit einer Befehlsfolge aus k (Kaffee), m (Milch) und z (Zucker) programmiert. Ein Latte Macchiato wird z. B. mit kkmmmzz programmiert, ein Espresso mit kkkk. Die Reihenfolge ist beliebig und theoretisch unendlich lang (mkmkzmz ist also auch ein Latte Macchiato). Jede Mischung muss aber mindestens einmal Kaffee enthalten.
Geben Sie eine reguläre Grammatik an, die richtige Kaffeemaschinenprogramme erzeugt.
Notieren Sie zuerst, welche Zutat auf welche folgen darf und womit ein Programm enden darf.
Ein Nichtterminal je Situation, z. B. „zuletzt Kaffee“, „zuletzt Milch“.
Jetzt sollen mehrere Kaffees hintereinander eingegeben werden können. Anfang und Ende eines Kaffees werden durch Klammern markiert, z. B. (mkmkzmz)(kkkk). Bestandteile außerhalb von Klammerpaaren werden ebenfalls als eigener Kaffee interpretiert: kk(kmzzm)mkzzkz(kmmmm) liefert die vier Kaffees kk, kmzzm, mkzzkz und kmmmm. Geben Sie eine Grammatik für diese Programmiersprache an. Sie soll nur gültige Wörter erzeugen, nicht die Funktion des Automaten simulieren.
Nach dem Ende eines Kaffees muss die Grammatik wieder zum Anfang zurückkehren können.
Die Klammern sind nicht geschachtelt. Reicht deshalb eine reguläre Grammatik?
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Sie haben alle Aufgaben bearbeitet und abgehakt. Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Musterlösung zu den Aufgaben 1 bis 7
Zu Aufgabe 1 a):
Schulnoten: N = {S, A, B, C}, T = {1, 2, 3, 4, 5, 6, +, -}, Startsymbol S
S → 1 | 2 | 3 | 4 | 5 | 6 | 1 A | 2 B | 3 B | 4 B | 5 B | 6 C
A → -
B → + | -
C → +
Uhrzeit: N = {S, A, B, C, D, E}, T = {0, …, 9, :}, Startsymbol S
S → 0 A | 1 A | 2 B
A → 0 C | 1 C | … | 9 C
B → 0 C | 1 C | 2 C | 3 C
C → : D
D → 0 E | 1 E | … | 5 E
E → 0 | 1 | … | 9
Kennzeichen: N = {S, A, …, J}, T = {a-z, -, 0-9}, Startsymbol S
S → a-z A
A → a-z B | - D
B → a-z C | - D
C → - D
D → a-z E
E → a-z F | - G
F → - G
G → 0-9 | 0-9 H
H → 0-9 | 0-9 I
I → 0-9 | 0-9 J
J → 0-9
Zu Aufgabe 1 b): Alle Produktionsregeln haben die Form „ein Nichtterminal → ein Terminal“ oder „ein Nichtterminal → ein Terminal und ein Nichtterminal“. Die drei Grammatiken sind also rechtsregulär. Alle drei Sprachen sind außerdem endlich und schon deshalb regulär. Terme mit beliebiger Klammertiefe sind nicht regulär (s. c) 3.), Terme mit höchstens einer Klammerebene dagegen schon (s. c).
Zu Aufgabe 1 c): Die Grammatik erzeugt Terme wie (15)-0*(5)+2, 0*7, (50), (6-4*1)*95 oder (305+892+5*7)-2. Es gibt nur nicht-negative ganze Zahlen. Die Regeln S → 1-9 B und C → 1-9 E stellen sicher, dass mehrstellige Zahlen keine führende 0 haben. Wegen S → ( C und F → ) | ) A wird jede geöffnete Klammer geschlossen, und vor dem Schließen kann keine neue Klammer geöffnet werden. Mit A → +S | -S | *S und D → +C | -C | *C soll nach jeder Zahl und jeder Klammer ein Rechenzeichen folgen, bevor eine neue Zahl kommt.
Der Vorschlag enthält aber zwei Fehler, die an den Regeln B → 0-9 S und E → 0-9 C liegen: Eine zweistellige Zahl kann nicht von einem Rechenzeichen gefolgt werden, deshalb sind z. B. 10+1 und 3*(15-4) aus der Tabelle nicht ableitbar. Dafür kann eine mehrstellige Zahl direkt vor einer Klammer stehen, z. B. 10(2). Korrektur: B → 0-9 | 0-9 A | 0-9 B und E → 0-9 F | 0-9 D | 0-9 E. Ableitung von 3*(15-4): S ⇒ 3A ⇒ 3*S ⇒ 3*(C ⇒ 3*(1E ⇒ 3*(15D ⇒ 3*(15-C ⇒ 3*(15-4F ⇒ 3*(15-4).
1. Ein weiteres Klammerpaar: Es müsste weitere Nichtterminale „innerhalb“ des Weges zwischen C und F geben, im Umfang wie C bis F.
2. Division: Das Rechenzeichen / kommt in A und D hinzu. Damit nicht durch 0 geteilt wird, braucht man nach / ein eigenes Nichtterminal, das keine einzelne 0 erzeugt, z. B. A → / Z mit Z → 1-9 | 1-9 A | 1-9 B | ( C. Ausdrücke wie /(2-2) lassen sich syntaktisch nicht ausschließen.
3. Beliebige Klammertiefe: Für jede weitere Tiefe müsste ein neuer Weg wie C–F ergänzt werden. Eine Grammatik für Tiefe n kann keine Terme der Tiefe n+1 erzeugen – man bräuchte unendlich viele Nichtterminale. Es gibt also keine reguläre Grammatik für diese Terme.
Zu Aufgabe 2:
Zu Aufgabe 3: \(N = \{S, A, B, C, D\}\), \(T = \{u, s, -, 1\_6, 74\_79, 701\_716\}\) (dabei steht z. B. 74_79 für eine der Zahlen 74 bis 79), Startsymbol S
Zu Aufgabe 4: a) Die Grammatik ist nicht regulär, weil es sowohl eine rechtsreguläre (S → 1 N) als auch eine linksreguläre Regel (N → N 0) gibt. b) Die Wörter der Sprache sind die Dualzahlen 1, 10, 100, 1000, … Die Grammatik \(G = (\{S, A\}, \{0, 1\}, S, P)\) mit S → 1 | 1 A und A → 0 | 0 A erzeugt die gleiche Sprache und ist rechtsregulär.
Zu Aufgabe 5: \(G = (\{S, A, B\}, \{la, le, lu\}, S, P)\) mit S → la A | le A | lu A, A → la B | le B | lu B, B → lu
Zu Aufgabe 6: \(G = (\{S, A, B\}, \{a, e, i, o, u, h, k, l, m, n, p, w\}, S, P)\). Dabei steht V für jeden der Vokale a, e, i, o, u und K für jeden der Konsonanten h, k, l, m, n, p, w (jede Regel gilt also für jedes dieser Zeichen):S → V | V B | K A
A → V | V B
B → V | V B | K A
Zu Aufgabe 7: a) \(G = (\{S, A\}, \{k, m, z\}, S, P)\) mit S → k | k A | m S | z S und A → k | m | z | k A | m A | z A
b) \(G = (\{S, A, B, C, D\}, \{k, m, z, (, )\}, S, P)\) mitS → k | k A | m B | z B | ( C
A → k | m | z | k A | m A | z A | ( C
B → k | k A | m B | z B
C → k C | k D | m C | z C
D → ) | k D | m D | z D | ) S
Reguläre Sprachen und DEA
Wir betrachten noch einmal die Sprache \(L_{Schulnoten}\). Sie wird von der Grammatik \(G = (N, T, S, P)\) mit
N = {S, A, B, C}, T = {1, 2, 3, 4, 5, 6, +, -}, Startsymbol S
S → 1 | 2 | 3 | 4 | 5 | 6 | 1 A | 2 B | 3 B | 4 B | 5 B | 6 C
A → -
B → + | -
C → +
erzeugt.
Das Erstellen eines Wortes nach dieser Grammatik ist sehr ähnlich zum Abarbeiten einer Eingabe durch einen DEA. Das Startsymbol interpretieren wir als Startzustand, die Terminale als Eingabealphabet und die Nichtterminale als weitere Zustände. Anhand der Produktionsregeln konstruiert man die Zustandsübergänge.
Nach einer 1, 2, 3, 4, 5 oder 6 ist bereits eine korrekte Eingabe erreicht. Diesen Zeichen kann aber noch ein weiteres, nicht immer gleiches Zeichen folgen: für 1 ein anderes als für 2–5 und noch ein drittes für 6. Daher gibt es für jedes dieser Nichtterminale A, B, C einen Zustand. Da einzelne Noten bereits fertige Wörter sind, sind \(q_1\), \(q_3\) und \(q_4\) Endzustände:
Mit den Produktionsregeln A → -, B → + | - und C → + geht es weiter:
Zu jedem Zustandsübergang des DEA gibt es ein Äquivalent in den Produktionsregeln und umgekehrt. Allgemein gibt es zu jeder regulären Sprache einen DEA, der genau diese Sprache akzeptiert, und zu jedem DEA eine reguläre Grammatik, die die vom DEA akzeptierte Sprache bildet. Ist fraglich, ob eine Grammatik regulär ist, kann man also versuchen, einen DEA zu entwerfen, der die Sprache der Grammatik akzeptiert.
Äquivalent hierzu ist:
Eine Sprache ist genau dann regulär, wenn es einen DEA gibt, der Akzeptor dieser Sprache ist.
Aufgaben zu regulären Sprachen und DEA
Entwickeln Sie einen DEA in Form eines Zustandsgraphen für die lal-Sprache (siehe Aufgaben zu regulären Sprachen).
Aus jedem Nichtterminal wird ein Zustand, aus jeder Regel A → x B eine Kante von A nach B mit der Beschriftung x.
Entwickeln Sie einen DEA in Form eines Zustandsgraphen für die Sprache der Nummernschilder (siehe Aufgaben zu regulären Sprachen).
Nutzen Sie Ihre Grammatik aus Aufgabe 1 a): Nichtterminale werden Zustände, Terminale Kantenbeschriftungen. Fassen Sie Buchstaben und Ziffern zu je einer Beschriftung zusammen.
Entwickeln Sie einen DEA in Form eines Zustandsgraphen für die hawaiianische Sprache (siehe Aufgaben zu regulären Sprachen).
Ein Zustand für „zuletzt Vokal“ (Endzustand) und einer für „zuletzt Konsonant“ genügen fast.
Gegeben ist der folgende Automat zum Erkennen boolescher Ausdrücke mit dem Eingabealphabet {a, b, &, |, !}. Alle nicht eingezeichneten Pfeile führen in einen Fehlerzustand.
Beschreiben Sie, welche Sprache der DEA akzeptiert.
Lesen Sie einige akzeptierte Wörter aus dem Graphen ab. Wo darf ! stehen, wo & und |?
Setzen Sie den Automaten in eine reguläre Grammatik um.
Jeder Zustand wird ein Nichtterminal, jede Kante von A nach B mit x eine Regel A → x B. Führt eine Kante in einen Endzustand, kommt zusätzlich A → x hinzu.
Entwickeln Sie einen endlichen Automaten, der genau die römischen Zahlen von 1 bis 10 akzeptiert.
Schreiben Sie alle zehn Zahlwörter auf: I, II, III, IV, V, VI, VII, VIII, IX, X. Gleiche Anfänge teilen sich Zustände.
Setzen Sie Ihren Automaten in eine reguläre Grammatik um.
Zustände werden Nichtterminale, Kanten werden Regeln A → x B, Kanten in Endzustände zusätzlich A → x.
Erweitern Sie beide Modelle so, dass die römischen Zahlen von 1 bis 39 die Sprache bilden.
Die Zahlen bis 39 bestehen aus bis zu drei X und danach einer Zahl von 1 bis 9 oder nichts. Setzen Sie vor Ihren Automaten aus a) einen Teil für die X.
Wir betrachten die Sprache \(L = \{a^n b^n \mid n \in \mathbb{N}_0\}\), also alle Wörter, in denen auf eine Folge von a gleich viele b folgen. Das leere Wort ist erlaubt.
Versuchen Sie, eine reguläre Grammatik für diese Sprache zu entwickeln. Beginnen Sie mit dem leeren Wort (n = 0, Regel S → ε) und erweitern Sie die Grammatik schrittweise für n ≤ 1, n ≤ 2 und n ≤ 3. Beschreiben Sie, wie die Grammatik dabei wächst.
Für n ≤ 1 brauchen Sie S → ε | a A und A → b.
Notieren Sie nach jedem Schritt, wie viele Nichtterminale Sie brauchen. Was müssen sich die Nichtterminale merken?
Begründen Sie mit den Erkenntnissen aus a), dass es keinen DEA geben kann, der Akzeptor von \(L\) ist.
Eine Sprache ist genau dann regulär, wenn es einen DEA gibt, der sie akzeptiert. Wie viele Zustände bräuchte ein DEA, um sich jede Anzahl von a zu merken?
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
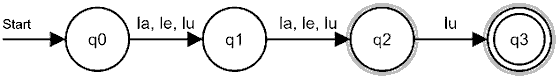
Zu Aufgabe 1 a):

Zu Aufgabe 1 b):
Zu Aufgabe 1 c) (v steht für einen Vokal, k für einen Konsonanten):
Zu Aufgabe 2 a): Der Automat akzeptiert logische Ausdrücke mit a und b: Verknüpfungen wie a&b, a|b, b&a, a&a … können beliebig oft hintereinander kommen. !a bzw. !b kann einmal allein stehen oder einen solchen Ausdruck beenden; danach ist noch genau eine weitere Verknüpfung (z. B. !a&b oder !a|!b) möglich.
b) N = {S, A, B, C, D, E, F}, T = {a, b, !, |, &}, Startsymbol S
S → a | b | a A | b A | ! C
A → & B | '|' B
B → a | b | a A | b A | ! C
C → a | b | a D | b D
D → & E | '|' E
E → a | b | ! F
F → a | b
Zu Aufgabe 3 a):
Zu Aufgabe 3 b): N = {S, A, B, C, D, E}, T = {i, v, x}
S → i | v | x | i A | v C
A → i | v | x | i B
B → i
C → i | i D
D → i | i E
E → i
Zu Aufgabe 3 c) (Grammatik für 1 bis 39): S → i | v | x | i A | v B | x C
A → i | v | x | i D
B → i | i E
C → i | v | x | i A | v B | x G
D → i
E → i | i F
F → i
G → i | v | x | i A | v B | x H
H → i | v | i A | v B
Der DEA wird entsprechend um Zustände für ein, zwei und drei vorangestellte X erweitert.
Zu Aufgabe 4 a): Für n = 0: S → ε; für n ≤ 1: S → ε | a A, A → b; für n ≤ 2: S → ε | a A, A → b | a B, B → b C, C → b; für n ≤ 3 zusätzlich B → b C | a D, D → b E, E → b F, F → b. (Eine Regel wie S → ab ist nicht regulär, weil rechts zwei Terminale stehen.) Mit jedem weiteren n kommen neue Nichtterminale hinzu, denn die Grammatik muss sich die Zahl der a merken – das entspricht dem Problem des Himbeerautomaten. Für alle n bräuchte man unendlich viele Nichtterminale, die Menge der Nichtterminale muss aber endlich sein. Der Versuch scheitert also. Dass es wirklich keine reguläre Grammatik gibt, zeigt die Begründung in b).
b) Wegen „Eine Sprache ist genau dann regulär, wenn es einen DEA gibt, der Akzeptor dieser Sprache ist“ kann es keinen entsprechenden DEA geben. Direkt begründet: Ein DEA mit k Zuständen käme nach zwei der Präfixe \(a^0, a^1, \dots, a^k\), etwa \(a^i\) und \(a^j\), in denselben Zustand und würde mit \(a^i b^i\) auch das falsche Wort \(a^j b^i\) akzeptieren.
Chomsky-Hierarchie
Ergänzung
Eine Computersprache ist analog zu natürlichen Sprachen wie Deutsch oder Englisch aufgebaut, nur muss in ihr alles eindeutig und korrekt geschrieben sein und darf keinen Interpretationsspielraum lassen. Es gibt verschiedene Sprachtypen mit steigendem Komplexitätsgrad der Grammatik. Der Sprachwissenschaftler Noam Chomsky hat 1956 eine Hierarchie aufgestellt, in der die formalen Sprachen nicht getrennt von den natürlichen Sprachen betrachtet, sondern hinsichtlich ihrer Wortbildungsregeln nach aufsteigender Komplexität geordnet werden.
Abb.: Hierarchie formaler Sprachen nach Noam Chomsky (1956)
Die bisher betrachteten Sprachen waren weitgehend regulär, also Typ-3-Sprachen. In der letzten Aufgabe haben wir festgestellt, dass selbst einfache Sprachen wie \(L = \{a^n b^n \mid n \in \mathbb{N}_0\}\) nicht regulär sind. Damit kann es keinen DEA geben, der Akzeptor dieser Sprache ist. Sie ist aber eine Typ-2-Sprache, also kontextfrei.
Kontextfreie Sprachen
Jetzt soll eine Grammatik für \(L_{a^n b^n} = \{a^n b^n \mid n \in \mathbb{N}_0\}\) entwickelt werden. Mit den Regeln einer regulären Grammatik kommt man nicht zurecht: Für n ≤ 2 hätte man vier Nichtterminale (S → ε | a A, A → b | a B, B → b C, C → b), und pro weiterem Paar „ab“ kommt für das zusätzliche a und das zusätzliche b je ein neues Nichtterminal hinzu. Könnte man direkt ein Paar „ab“ erzeugen, wäre das anders.
S → ε | ab | a A b, A → ε | a A b definiert – oder kürzer mit \(N = \{S\}\) und S → ε | a S b. Das zweite Nichtterminal ist unnötig, da S selbst rekursiv das nächste Paar „a … b“ um das bisherige Wort legen kann.Vergleicht man S → a S b mit den erlaubten Regeln einer regulären Grammatik (rechtsregulär: A → +B, linksregulär: A → B+), stellt man fest: Die Regel ist eine Mischung aus beiden. Die Grammatik ist weder links- noch rechtsregulär und damit keine reguläre Grammatik. Die Sprache ist also nicht regulär, sondern eine kontextfreie Sprache (Typ-2-Sprache).
Ein Nichtterminal → eine beliebige Kombination aus Terminal- und Nichtterminalsymbolen (Beispiel: A → + B - / C).
Aufgaben zu kontextfreien Sprachen
Da eine korrekte Klammersetzung geprüft werden muss, wird jetzt eine Sprache entwickelt, die Klammerausdrücke produziert.
Erstellen Sie eine Grammatik zur Sprache \(L = \{\{^n\}^n \mid n \in \mathbb{N}_0\}\), die geschachtelte Klammerausdrücke wie {{}} oder {{{}}} erzeugt.
Eine Regel der Form S → { S } erzeugt ein Klammerpaar außen und lässt innen Platz für weitere Klammern. Wie endet die Ableitung?
Erweitern Sie die Grammatik so, dass auch Klammerausdrücke wie {}{} oder {{}{}} möglich sind.
Ergänzen Sie eine Regel, mit der zwei korrekte Klammerausdrücke hintereinander stehen dürfen, z. B. S → S S.
Erläutern Sie mit Hilfe deterministisch endlicher Automaten, weshalb die Sprachen aus a) und b) nicht regulär sind.
Was müsste sich ein DEA beim Lesen der öffnenden Klammern merken? Ist diese Anzahl begrenzt?
Gegeben ist die Grammatik G mit \(N = \{S, A, B, C, D\}\), \(T = \{a, b, c, d\}\), Startsymbol S undS → A | a B | a C
A → B | C | c A d
B → S | B a
C → D | c
D → d | d D D
Geben Sie zwei strukturell verschiedene Wörter an, die mit dieser Grammatik gebildet werden können.
Beginnen Sie bei S und ersetzen Sie immer ein Nichtterminal, bis nur noch Terminale übrig sind. Wählen Sie für das zweite Wort einen anderen Weg (z. B. über c A d).
Erläutern Sie, weshalb die Grammatik nicht regulär ist.
Suchen Sie Regeln, die weder rechtsregulär noch linksregulär sind, z. B. mit Terminalen auf beiden Seiten eines Nichtterminals.
Die Sprache \(L_{RA}\) der einfachen Rechenausdrücke mit geschachtelten Klammern beinhaltet z. B. 1+2, 2*4, (5+7*(6+3)), (4+9)*3. Als Zahlen sind nur positive ganze Zahlen, als Rechenzeichen + und * erlaubt.
Erstellen Sie eine kontextfreie Grammatik der Sprache \(L_{RA}\).
Ein Ausdruck besteht aus Summanden, die durch + verknüpft sind, ein Summand aus Faktoren, die durch * verknüpft sind. Ein Faktor ist eine Zahl oder ein geklammerter Ausdruck.
Zahlen beginnen nicht mit 0. Ein eigenes Nichtterminal für die weiteren Ziffern hilft.
Erläutern Sie, weshalb \(L_{RA}\) nicht regulär ist.
Klammern können beliebig tief geschachtelt werden. Vergleichen Sie mit Aufgabe 1 c).
| \(L_1\) | \(L_2\) | \(L_3\) |
|---|---|---|
N={S,A,B}, T={a,b} | N={S,A}, T={a,b} | N={S,A}, T={a,b} |
Untersuchen Sie, welche Wörter die jeweilige Sprache bilden, und erläutern Sie, weshalb die Grammatiken kontextfrei sind.
Leiten Sie aus jeder Grammatik einige kurze Wörter ab und beschreiben Sie, was sie gemeinsam haben.
Prüfen Sie: Steht links in jeder Regel genau ein Nichtterminal?
Die drei Sprachen sind regulär. Entwickeln Sie geeignete reguläre Grammatiken.
Beschreiben Sie zuerst die Sprache in Worten und bauen Sie die Wörter dann von links nach rechts auf.
Erläutern Sie detailliert, wie Sprachen und ihre Grammatiken zusammenhängen.
Eine Sprache ist eine Menge von Wörtern, eine Grammatik ein Regelwerk. Kann es zu einer Sprache mehrere Grammatiken geben?
Im Abschnitt zu regulären Sprachen und DEA haben wir gesehen, dass beide Modelle zusammenhängen. Auch für kontextfreie Sprachen gibt es ein äquivalentes Automatenmodell:
Ein Palindrom ist ein Wort, das von vorne und hinten gelesen gleich ist, z. B. anna, reittier oder rentner. Erstellen Sie eine Grammatik zur Sprache der Palindrome aus Kleinbuchstaben.
Ein Palindrom hat außen gleiche Buchstaben. Regeln wie S → a S a erzeugen sie. Wie endet ein Palindrom in der Mitte (gerade und ungerade Länge)?
Entwickeln Sie eine kontextfreie Grammatik für alle Palindrome mit ungerader Wortlänge über dem Alphabet {a, b, c}, wobei c nur in der Wortmitte vorkommt.
Die Mitte ist hier immer genau ein c. Welche Regel beendet deshalb die Ableitung?
Entwerfen Sie einen Kellerautomaten, der Akzeptor dieser Palindrome ist.
Legen Sie alle Zeichen vor dem c in den Keller.
Nach dem c muss jedes Zeichen mit dem obersten Kellerzeichen übereinstimmen. Am Ende darf nur noch # im Keller liegen.
Die Abbildung zeigt den Vorschlag eines Kellerautomaten, der Akzeptor aller Palindrome über {a, b} ohne Trennzeichen in der Mitte sein soll. Analysieren Sie seine Funktionsweise und vergleichen Sie ihn mit Ihrem Automaten aus c). Hinweis: Eine Umschreibung von „nicht-deterministisch“ ist „nicht eindeutig vorbestimmt“.
Suchen Sie in \(q_0\) Situationen, in denen zwei Übergänge passen. Was „rät“ der Automat dort?
Testen Sie aba, abba, a und das leere Wort. Welche werden akzeptiert?
HTML-Dokumente bestehen aus verschiedenen Tags, die Inhalte strukturieren. Ein Tag ist immer durch < und > eingegrenzt. Die Sprache aller korrekten HTML-Dokumente nennen wir \(L_{HTML}\). Ein Beispiel:
<html>
<head><title>Beispiel für HTML</title></head>
<body>
<h1>Willkommen auf meiner Webseite!</h1>
<div>
<p>Besuche <a href="https://www.example.com"></a> für mehr Informationen.</p>
<div>
<p>Ein weiterer Absatz.</p>
<div><p>Und noch ein Absatz in einer tieferen Ebene.</p></div>
</div>
</div>
</body>
</html>Begründen Sie, weshalb \(L_{HTML}\) nicht regulär ist.
Zu jedem öffnenden Tag gehört ein schließendes, und Tags können beliebig tief geschachtelt werden. Was müsste sich ein DEA merken?
Entwickeln Sie eine kontextfreie Grammatik, die alle Wörter von \(L_{HTML}\) erzeugt. Sie können selbst entscheiden, ob Sie mehr Elemente als im Beispiel berücksichtigen.
Beginnen Sie außen: S → <html> HEAD BODY </html>. Dann zerlegen Sie HEAD und BODY weiter.
Für beliebig viele Elemente im Body hilft ein Nichtterminal ELEMS → ELEM ELEMS | ε.
Entwerfen Sie einen Kellerautomaten, der Akzeptor der Sprache \(L_{HTML}\) ist.
Legen Sie für jedes öffnende Tag ein Zeichen in den Keller. Ein schließendes Tag darf nur gelesen werden, wenn das passende Zeichen oben liegt.
Datenbank-Managementsysteme benötigen Parser, die eingegebene SQL-Abfragen auf Korrektheit prüfen. Die Menge aller gültigen Abfragen ist \(L_{SQL}\). Wir betrachten eine Datenbank zur Verwaltung eines Online-Adventurespiels:
| Held | |||
|---|---|---|---|
| HeldID | Name | KlasseID | Level |
| 1 | Eldrin | 1 | 10 |
| 2 | Thalia | 2 | 15 |
| 3 | Kaelthas | 3 | 20 |
| 4 | Sylvara | 1 | 12 |
| 5 | Borin | 2 | 14 |
| Klasse | ||
|---|---|---|
| KlasseID | Klassenname | Beschreibung |
| 1 | Krieger | Starker Nahkämpfer |
| 2 | Zwerg | Robuster Kämpfer mit Hammer |
| 3 | Magier | Meister der magischen Künste |
| Item | |||
|---|---|---|---|
| ItemID | Name | Typ | Wert |
| 1 | Langschwert | Waffe | 150 |
| 2 | Schild | Rüstung | 100 |
| 3 | Heiltrank | Trank | 50 |
| 4 | Zauberstab | Waffe | 200 |
| 5 | Zwergenhelm | Rüstung | 120 |
| Inventar | ||
|---|---|---|
| HeldID | ItemID | Menge |
| 1 | 1 | 1 |
| 1 | 3 | 5 |
| 2 | 2 | 1 |
| 2 | 4 | 1 |
| 3 | 4 | 1 |
| 3 | 3 | 2 |
| 4 | 1 | 1 |
| 5 | 2 | 1 |
| 5 | 5 | 1 |
Die folgenden vier SQL-Abfragen sind fehlerhaft. Analysieren Sie, was sie ausgeben sollen, erläutern Sie ihre Funktionsweise und korrigieren Sie die Fehler.
-- SQL-Abfrage 1
SELECT h.Name AS HeldName, k.Klassenname AS Klasse
FROM Helden h
WHERE h.KlasseID = k.KlasseID;
-- SQL-Abfrage 2
SELECT h.Name AS HeldName, i.Name AS ItemName, iv.Menge
FROM Inventar iv
JOIN Helden h ON iv.HeldID = h.HeldID
JOIN Items i ON ItemID = ItemID
WHERE h.Name = 'Kaelthas';
-- SQL-Abfrage 3
SELECT SUM AS GesamtanzahlItems
FROM Inventar iv;
-- SQL-Abfrage 4
SELECT k.Klassenname AS Klasse, i.Typ SUM(iv.Menge) AS GesamtanzahlItems
FROM Inventar iv, Helden h, Klassen k, Items i
WHERE iv.HeldID = h.HeldID AND h.KlasseID = k.KlasseID AND iv.ItemID = i.ItemID
GROUP BY k.Klassenname
ORDER BY k.Klassenname, i.Typ;Prüfen Sie jede Abfrage der Reihe nach: Werden alle Tabellenaliase (z. B. k) im FROM-Teil eingeführt? Stimmen die Schlüsselwörter und ihre Reihenfolge?
Untersuchen Sie, unter welchen Voraussetzungen \(L_{SQL}\) regulär ist, und begründen Sie, dass dies unter normalen Umständen nicht der Fall ist.
Welche Teile von SQL können beliebig tief geschachtelt werden (Klammern, Unterabfragen)? Was passiert, wenn man die Tiefe begrenzt?
Entwickeln Sie eine kontextfreie Grammatik, die alle Wörter von \(L_{SQL}\) erzeugt und mindestens Auswahl (SELECT), Tabellen (FROM), Bedingungen (WHERE oder JOIN) und Gruppierung (GROUP BY) abdeckt. Die Grammatik soll nur syntaktisch korrekte Abfragen erzeugen; die semantische Korrektheit wird ignoriert (vgl. „Ich klettere auf einen Berg.“ und „Ich klettere auf einen Weltraum.“ – beide Sätze sind syntaktisch korrekt, aber nur einer ist semantisch richtig).
Beginnen Sie mit S → SELECT SELECT_LIST FROM TABLE_EXPR WHERE_OPT GROUP_OPT und zerlegen Sie dann jedes Nichtterminal.
Optionale Teile wie WHERE erhalten eine Regel mit ε, z. B. WHERE_OPT → WHERE CONDITION | ε.
Vergleichen Sie die folgenden Beispiele:
- (1) „Ich sah den Mann mit dem Fernglas.“
- (2) „Der Berg klettert auf den Wanderer.“
- (3)
SELECT Name FROM Schueler WHERE Klasse = '12b' - (4)
SELECT Name WHERE Klasse = '12b' FROM Schueler
Untersuchen Sie die Beispiele (1) bis (4) jeweils auf syntaktische Korrektheit und Eindeutigkeit der Bedeutung.
Syntax betrifft den Aufbau (Welche Wörter stehen in welcher Reihenfolge?), Semantik die Bedeutung. Prüfen Sie beides getrennt.
Wer hat das Fernglas: die Person, die sieht, oder der Mann? Gibt es mehr als eine Lesart?
Vergleichen Sie die Reihenfolge der Schlüsselwörter mit Beispiel (3). Was macht ein Datenbanksystem mit dieser Eingabe?
Vergleichen Sie formale und natürliche Sprachen hinsichtlich Alphabet bzw. Wortschatz, Grammatik, Eindeutigkeit und Umgang mit Fehlern.
Legen Sie eine Tabelle mit den Spalten „formale Sprache“ und „natürliche Sprache“ an und tragen Sie zu jedem Gesichtspunkt ein Beispiel ein.
Ein Mensch versteht auch einen Satz mit einem Grammatikfehler. Wie reagiert ein Compiler auf eine fehlende Klammer?
Beurteilen Sie die Aussage: „Ein Computer könnte Deutsch genauso sicher verarbeiten wie Java, man müsste nur genug Grammatikregeln aufschreiben.“
Würde eine vollständige Grammatik das Problem aus Beispiel (1) lösen? Welche Information fehlt dem Computer dort?
Natürliche Sprachen verändern sich ständig und werden nicht nach festen Regeln „erfunden“. Was bedeutet das für eine Grammatik des Deutschen?
🎉 Ausgezeichnet – Alle Aufgaben abgeschlossen!
Vergleichen Sie Ihre Ergebnisse nun mit der Musterlösung.
Zu Aufgabe 1: a) \(N = \{S, A\}\), \(T = \{\{, \}\}\): S → ε | { A, A → } | S } b) S → ε | { A | S S, A → } | S } (S → S S setzt korrekte Klammerausdrücke nebeneinander; gleichwertig und kürzer ist S → ε | { S } S.) c) In Aufgabe 2 zu Kellerautomaten wurde festgestellt, dass es keinen DEA geben kann, der Akzeptor dieser Sprachen ist. Da eine Sprache genau dann regulär ist, wenn es einen DEA als Akzeptor gibt, können die Sprachen nicht regulär sein.
Zu Aufgabe 2: a) z. B. cadddad und aadddaa. b) Zum Beispiel ist die Regel A → c A d weder links- noch rechtsregulär, die Grammatik ist also nicht regulär.
Zu Aufgabe 3: a) \(N = \{S, B, C, D, E\}\), \(T = \{0, …, 9, *, +, (, )\}\):S → S + B | S * B | B
B → B * C | C
C → ( S ) | D
D → 1E | 2E | … | 9E
E → ε | 0E | 1E | … | 9E
b) Wie in Aufgabe 1 c): Die Wörter \((^n 1 )^n\) gehören für alle n zu \(L_{RA}\). Ein DEA mit k Zuständen käme nach zwei verschiedenen Präfixen \((^i\) und \((^j\) in denselben Zustand und würde mit \((^i 1 )^i\) auch das falsche Wort \((^j 1 )^i\) akzeptieren. Es gibt also keinen DEA, und \(L_{RA}\) ist nicht regulär. (Dass die Grammatik aus a) nicht regulär ist, reicht als Begründung nicht.)
Zu Aufgabe 4 a): \(L_1 = \{a^n b^m \mid n, m \in \mathbb{N}\}\): eine positive Anzahl a gefolgt von einer positiven Anzahl b; wegen der Regel A → B ist die Grammatik kontextfrei, aber nicht rechtsregulär. \(L_2 = \{(ab)^n \mid n \in \mathbb{N}\}\): alle Regeln enthalten zwei Terminale. \(L_3 = \{u\,ab\,v\,ab\,w \mid u, v, w\) beliebige Kombinationen aus a und b\(\}\): Wörter, in denen mindestens zweimal „ab“ vorkommt, wegen S → A ab A ab A kontextfrei.
b) \(L_1\): S → a S | a A, A → b A | b; \(L_2\): S → a A, A → b | b S; \(L_3\): S → a S | b S | a A, A → a A | b B, B → a B | b B | a C, C → a C | b D, D → ε | a D | b D
c) Eine Sprache ist eine Menge von Wörtern über einem Alphabet. Eine Grammatik ist ein formales Regelwerk, das beschreibt, wie Wörter durch wiederholte Anwendung der Produktionen vom Startsymbol aus abgeleitet werden. Jede Grammatik G definiert eine Sprache L(G). Umgekehrt kann man für viele Sprachen eine Grammatik angeben, die genau diese Sprache erzeugt. Eine reguläre Sprache muss nicht zwingend durch eine reguläre Grammatik erzeugt werden, es gibt aber immer eine reguläre Grammatik, die sie erzeugt.
Zu Aufgabe 5: a) S → a S a | b S b | … | z S z | A, A → a | … | z | ε b) \(N = \{S\}\), \(T = \{a, b, c\}\): S → c | a S a | b S b (auch das Wort c gehört dazu) c) Ein möglicher Kellerautomat:
d) Der Automat ähnelt dem aus c), es fehlt aber das Mittelzeichen. In \(q_0\) hat er für jedes Paar aus oberstem Stapelzeichen (A oder B) und Eingabe (a oder b) zwei Möglichkeiten: Er bleibt in \(q_0\) und legt das Zeichen zusätzlich auf den Stapel, oder er wechselt nach \(q_1\) und behandelt das Zeichen als Wortmitte. Das ist Nichtdeterminismus: Der Automat „rät“ die Mitte, so wie der Automat aus Aufgabe 9 zu Kellerautomaten rät, ob m = n oder m = 2n gilt. Akzeptiert wird, wenn es einen Weg gibt, nach Abarbeiten der Eingabe in \(q_2\) zu enden. Deshalb heißen diese Automaten nichtdeterministische Kellerautomaten.
Testet man den Vorschlag, fällt auf: Er akzeptiert nur Palindrome ungerader Länge ab 3 (z. B. aba), denn der Wechsel nach \(q_1\) verbraucht immer ein Zeichen. abba, a oder das leere Wort werden abgelehnt. Für alle Palindrome über {a, b} ergänzt man von \(q_0\) nach \(q_1\) die ε-Übergänge (A,ε):A und (B,ε):B für gerade Wortlänge sowie (#,a):#, (#,b):# und (#,ε):# für die Wörter a, b und ε:
Zu Aufgabe 6: a) Reguläre Sprachen können keine verschachtelten Strukturen mit korrektem Paarabgleich von öffnenden und schließenden Tags erfassen. Bei beliebig vielen verschachtelten Elementen muss jedes <div> mit einem passenden </div> abgeglichen werden. Endliche Automaten können diesen Stapel-Mechanismus nicht abbilden, da sie keinen unbeschränkten Speicher haben.
b) N = {S, HEAD, BODY, LINK, ELEMS, ELEM, TEXT}, T = {<html>, </html>, <head>, </head>, <title>, </title>, <body>, </body>, <h1>, </h1>, <p>, </p>, <div>, </div>, <a href=", ">, </a>, link, inhalt} (link: korrekte Internet- oder IP-Adresse, inhalt: beliebige Zeichenkette, Bild o. Ä.)S → <html> HEAD BODY </html>
HEAD → <head> <title> TEXT </title> </head>
BODY → <body> ELEMS </body>
ELEMS → ε | ELEM ELEMS
ELEM → <h1> TEXT </h1> | <p> ELEMS </p> | <div> ELEMS </div> | <a href="LINK"> ELEMS </a> | TEXT
TEXT → inhalt
LINK → link
Weil div hier ein gewöhnliches Element ist, können auf ein div-Element weitere Elemente folgen.
c) Ein Kellerautomat legt jedes öffnende Tag auf den Stapel und entfernt es beim passenden schließenden Tag wieder; Inhalte werden überlesen. Akzeptiert wird, wenn nach </html> nur noch # auf dem Stapel liegt (Übergang mit (#,ε):# in einen Endzustand).
Zu Aufgabe 7 a):
- Abfrage 1 soll Heldennamen mit Klassennamen ausgeben. Die Tabelle Klasse fehlt unter FROM:
FROM Held h, Klasse k WHERE h.KlasseID = k.KlasseID; - Abfrage 2 soll für Kaelthas die Items samt Mengen anzeigen. Die JOIN-Bedingung ist unspezifisch:
JOIN Item i ON iv.ItemID = i.ItemID - Abfrage 3 soll die Gesamtzahl der Items berechnen, summiert aber über nichts:
SELECT SUM(iv.Menge) AS GesamtanzahlItems FROM Inventar iv; - Abfrage 4 soll für jede Kombination aus Klasse und Itemtyp die Summe der Items berechnen. Es fehlt ein Komma nach
i.Typ, und dai.Typnicht in einer Aggregatfunktion steht, muss es auch bei GROUP BY auftauchen:GROUP BY k.Klassenname, i.Typ - In allen Abfragen stimmen außerdem die Tabellennamen nicht: Die Tabellen heißen Held, Klasse, Item und Inventar (nicht Helden, Klassen, Items).
Zu Aufgabe 7 b): SQL besitzt rekursive Strukturen, z. B. verschachtelte Unterabfragen oder geklammerte Bedingungen. Reguläre Sprachen können solche beliebig tief verschachtelten Strukturen nicht korrekt abbilden; \(L_{SQL}\) ist also im Allgemeinen nicht regulär. Bloße Wiederholung, etwa beliebig viele Spalten oder JOINs hintereinander, wäre dagegen regulär. Schränkt man SQL stark ein (z. B. begrenzte Tiefe der Unterabfragen oder nur einfache, nicht verschachtelte SELECT-Anweisungen), ließen sich die erlaubten Abfragen durch einen endlichen Automaten beschreiben und die Sprache wäre regulär.
Zu Aufgabe 7 c) (kontextfreie Grammatik für einen Teilbereich von SQL, Nichtterminale in Großbuchstaben):
S → SELECT SELECT_LIST FROM TABLE_EXPR WHERE_OPT GROUP_OPT
SELECT_LIST → * | SEL_ITEM SEL_ITEMS
SEL_ITEMS → , SEL_ITEM SEL_ITEMS | ε
SEL_ITEM → COLUMN | COLUMN AS IDENT
TABLE_EXPR → TABLE_FACTOR JOIN_CLAUSE_LIST
TABLE_FACTOR → IDENT | IDENT AS IDENT
JOIN_CLAUSE_LIST → JOIN_CLAUSE JOIN_CLAUSE_LIST | ε
JOIN_CLAUSE → JOIN TABLE_FACTOR ON CONDITION
WHERE_OPT → WHERE CONDITION | ε
GROUP_OPT → GROUP BY COLUMN GROUP_LIST | ε
GROUP_LIST → , COLUMN GROUP_LIST | ε
CONDITION → CONDITION AND CONDITION | CONDITION OR CONDITION | ( CONDITION ) | COMP
COMP → COLUMN COMP_OP VALUE
COMP_OP → = | <> | < | <= | > | >=
COLUMN → IDENT | IDENT . IDENT
VALUE → LITERAL | NUMBER | IDENT
IDENT → identifier
LITERAL → literal
NUMBER → numberZu Aufgabe 8 a): (1) ist syntaktisch korrekt, aber mehrdeutig: Das Fernglas kann zum Sehen benutzt worden sein oder zum Mann gehören. (2) ist syntaktisch korrekt, aber semantisch unsinnig. (3) ist eine korrekte SQL-Abfrage mit genau einer Bedeutung. (4) ist syntaktisch falsch, weil FROM vor WHERE stehen muss; das Datenbanksystem bricht mit einer Fehlermeldung ab, statt die Absicht zu erraten.
Zu Aufgabe 8 b):
| Gesichtspunkt | formale Sprache | natürliche Sprache |
|---|---|---|
| Alphabet / Wortschatz | endliches, genau festgelegtes Alphabet | Wortschatz offen, neue Wörter entstehen ständig |
| Grammatik | vollständig durch Produktionsregeln festgelegt; ein Wort gehört dazu oder nicht | Regeln beschreiben den Gebrauch nachträglich, mit vielen Ausnahmen und Übergängen |
| Eindeutigkeit | jedes korrekte Wort hat genau eine Bedeutung (z. B. in Programmiersprachen) | Mehrdeutigkeit ist häufig; der Zusammenhang entscheidet |
| Umgang mit Fehlern | ein Syntaxfehler führt zur Ablehnung (Compiler, Datenbanksystem) | Menschen verstehen auch fehlerhafte Sätze |
Zu Aufgabe 8 c): Die Aussage trifft nicht zu. Selbst eine sehr umfangreiche Grammatik legt nur den Aufbau der Sätze fest. Mehrdeutigkeiten wie in (1) löst sie nicht, dafür braucht man Wissen über den Zusammenhang und die Welt. Außerdem verändert sich das Deutsche ständig, und viele korrekt verwendete Sätze folgen keiner festen Regel. Teilbereiche lassen sich aber formal beschreiben, und moderne Sprachmodelle verarbeiten Deutsch mit statistischen Verfahren statt mit einer vollständigen Grammatik, also auch nicht „genauso sicher“ wie ein Compiler Java.