Codierungstheorie

Die vorliegenden Materialien wurden von Daniel Hoherz und André Tempel erstellt. Sollten andere Editoren die Materialien erstellt haben, werden diese explizit genannt.
Im letzten Schuljahr haben Sie bereits wichtige Grundlagen zur Codierungstheorie und deren Anwendung kennengelernt. Oft wirken diese Konzepte in der Theorie sehr abstrakt. Stellen Sie sich daher vor, Sie stehen im Supermarkt, kaufen sich einen Snack an der Selbstbedienungskasse und schicken ein Foto davon an eine befreundete Person. In diesem alltäglichen, kurzen Moment spielen alle sieben großen Themen des letzten Jahres eine Rolle:
- Der EAN-8 Code (Barcode)
Sie beginnen damit, Ihren Snack über den Scanner der Kasse zu ziehen. Die Kasse liest das Muster aus hellen und dunklen Strichen ein und erkennt das Produkt dank dieses speziellen Codes schnell und fehlerfrei.
- Die RGB-Codierung von Farben
Sie zücken Ihr Smartphone und machen ein Foto von Ihrem Einkauf. Ihr Bildschirm stellt das bunte Bild dar, indem er für jeden einzelnen Bildpunkt (Pixel) die drei Grundfarben Rot, Grün und Blau in verschiedenen Intensitäten mischt.
- Ein verlustbehaftetes Bildkompressionsverfahren
Damit das hochauflösende Foto beim Versenden nicht Ihr gesamtes Datenvolumen aufbraucht, rechnet Ihr Smartphone das Bild im Hintergrund (z. B. als JPEG) klein. Dabei werden geschickt Bildinformationen weggelassen, die Ihr Auge ohnehin kaum wahrnimmt.
- Die ASCII-Codierung
Sie tippen noch eine kurze Textnachricht zu dem Bild. Im Hintergrund wird dabei jeder Buchstabe und jedes Satzzeichen in eine eindeutige Zahlenkombination übersetzt, damit das Gerät den Text überhaupt verarbeiten kann.
- Zahlen im Binärsystem
Egal ob das komprimierte Foto oder Ihr getippter Text – auf der untersten Ebene muss Ihr Smartphone all diese Informationen in Nullen und Einsen umwandeln. Dieses System ist extrem relevant, da es die einzige Sprache ist, die die Hardware (Maschinenkommunikation) wirklich versteht.
- Notwendige Absprachen bei Kommunikationsprotokollen
Sie drücken auf "Senden". Damit Ihr Smartphone und der Mobilfunkmast sich beim Austausch der Daten nicht in die Quere kommen oder Pakete im Chaos verloren gehen, regeln unsichtbare Protokolle exakt, wer wann wie lange senden darf.
- Der n-bit-Repetitionscode
Auf dem Weg durch die Luft können Störsignale einzelne Nullen und Einsen verfälschen. Einfache Fehlerkorrekturverfahren – wie das Prinzip, Bits mehrfach zu senden – helfen der Empfängerseite mathematisch zu überprüfen, ob ein Fehler aufgetreten ist, sodass die Nachricht intakt ankommt.
Aufgaben
Anscheinend gibt es sehr viele verschiedene Codierungen. Es muss also wünschenswerte Eigenschaften geben, die eine „gute" Codierung möglichst haben sollen. Dies untersuchen wir nun.
- Folgende Aufgaben werden in arbeitsteiliger Partnerarbeit durchgeführt. Eine Person der Partnergruppe übernimmt die Bearbeitung der Aufgabe zum ASCII-Code und die andere zum Morse-Code.
- Anschließend stellen sich die beiden gegenseitig ihre Ergebnisse vor.
- Danach wird die Aufgabe zum 3-Bit-Gencode zu zweit bearbeitet.
- Füllen Sie zum Abschluss diese Tabelle aus.
Diese Aufgabe ist in Teilen nach einer Idee von Carsten Rohe (Lohne, 2024) erstellt worden
Werden Daten in einem Computersystem gespeichert oder werden diese an einen anderen Rechner übertragen, ist es sinnvoll, dies auf eine einheitliche Art und Weise zu tun. Man benötigt hierzu eine Codetabelle, die festlegt, welcher Code für welches Zeichen stehen soll. Verwenden alle die gleiche Tabelle, so kann man problemlos Daten austauschen.
In den Anfängen des Computerzeitalters erkannte man diese Notwendigkeit schnell und entwickelte dazu den ASCII-Code. Informieren Sie sich zunächst hier über den ASCII-Code, schauen Sie auch das Video.
Wofür steht die Abkürzung ASCII und was bedeutet dies auf Deutsch?
Im Standard-ASCII-Code wird jedes Zeichen durch 7 Bit ausgedrückt, d. h. eine Folge von 7 Nullen und Einsen. So steht zum Beispiel die Folge 1100110 für den Buchstaben „f". Wie viele verschiedene Zeichen kann man theoretisch durch 7 Bit darstellen?
Der erweiterte ASCII-Code hat eine Länge von 8 Bit. Warum hat man diese Erweiterung vorgenommen?
Zusatz: Eine Weiterentwicklung des ASCII-Codes ist der Unicode. Wie viele Zeichen sind in diesem Code gespeichert? Wie lang ist dann der Code für ein einzelnes Zeichen?
Übersetzen Sie die ersten beiden Zeilen des folgenden in Dualzahlen dargestellten ASCII-Textes.
Codieren Sie ein selbst überlegtes Wort (maximal 8 Zeichen) mit dem ASCII-Code in Dualzahldarstellung.
Bei der Übertragung eines ASCII-Textes werden keine Leerzeichen mitgesendet.
Entscheiden Sie, inwiefern man den Text trotzdem wieder übersetzen/decodieren kann. Kann man von links und/oder von rechts mit einer Übersetzung beginnen?
Ein Wort im Sinne der Codierung ist hier beim ASCII-Code ein einzeln codiertes Zeichen. Entscheiden Sie, weshalb es von Vorteil ist, dass alle ASCII-Codewörter die gleiche Länge haben.
Der Sender codiert mit ASCII eine Nachricht:
Aufgrund von Übertragungsfehlern erhält der Empfänger allerdings:
Entscheiden Sie, ob und inwieweit der Empfänger einer ASCII-codierten Nachricht Übertragungsfehler erkennen und/oder korrigieren kann.
| Zeichen | ASCII-Wert (dezimal) | ASCII-Code (8-Bit) |
|---|
Diese Aufgabe ist in Teilen nach einer Idee von Carsten Rohe (Lohne, 2024) erstellt worden
„Samuel Morse, ein US-amerikanischer Erfinder und Professor für Malerei, Plastik und Zeichenkunst, baute 1833 aus Drahtresten, Blechabfällen und seiner Wanduhr den ersten elektromagnetischen Schreibtelegrafen, später „Morseapparat" genannt. Dieser wurde 1837 testweise, mit einem nur die zehn Ziffern umfassenden Code, in Betrieb genommen. Diese Zahlen wurden dann mithilfe einer Tabelle in Buchstaben und Worte übersetzt. Die Erweiterung des Codes um Buchstaben 1838 ist Morses Mitarbeiter Alfred Vail zuzuschreiben, wobei sich der Code nun aus Zeichen von drei Längen und unterschiedlich langen Pausen zusammensetzte. Eine erste Versuchslinie entstand in den USA zwischen Baltimore und Washington im Jahre 1843. Ab 1844 wurde dieser Code auch betrieblich bei US-amerikanischen Eisenbahnen und Telegrafenunternehmen eingesetzt („American Morse Code"). Die erste Überseeleitung zwischen Amerika und Europa wurde 1866 fertiggestellt. Friedrich Clemens Gerke, der Inspektor der Hamburger Telegrafenlinie, schrieb den Morsecode 1848 um, da die verschieden langen Pausen den Code negativ beeinträchtigten. Diese Endfassung des Codes wurde 1865 nach leichter Veränderung in Paris auf dem Internationalen Telegraphenkongress standardisiert. Genormt wurde der Morsecode von der ITU als „International Morse Code". Im zweiten Weltkrieg wurde der Morsecode zur Verschlüsselung von Geheimbotschaften von Spionen eingesetzt. Ein amüsantes Beispiel ist die Tarnung von Codes als Stickereien in Modedarstellungen von Damenkleidung. Die Verdrängung des Morsecodes aus den Telegrafennetzen ging einher mit der Einführung von Fernschreibern. Obwohl seine Bedeutung im Funkverkehr noch lange anhielt, wurde er auch dort von anderen Verfahren sukzessive ersetzt."
Quelle: Text gekürzt von hier.
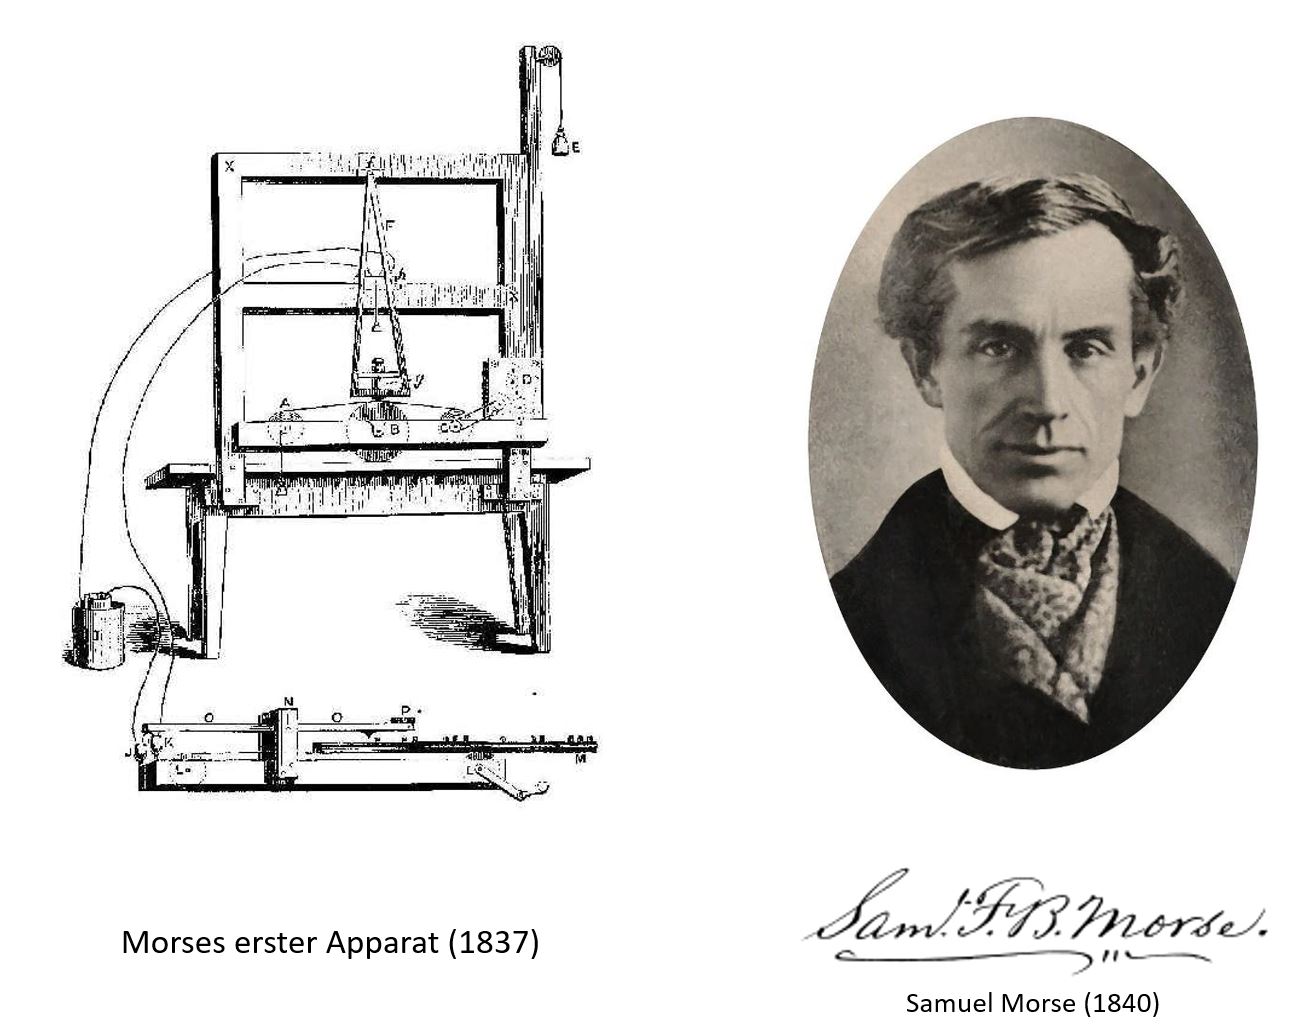

Übersetzen Sie den folgenden (International) Morse-Code.
.. -.-. .... -.. . -. -.- . --..-- .- .-.. ... --- -... .. -. .. -.-. .... . .-. . -. . -.. . -.. . ... -.-. .- .-. - . -....-Codieren Sie Ihren Namen mit dem International Morse-Code.
Beim „International Morse Code" gibt es zwei unterschiedliche Signallängen und stets gleich lange Pausen. Beim älteren „American Morse Code" ist dies teilweise anders. Finden Sie heraus, bei welchen Buchstaben dies der Fall ist. Haben Sie eine Idee, warum der „International Morse Code" daher besser ist?
Zwischen den einzelnen Buchstaben müssen beim Morsen kurze Pausen gemacht werden. Warum ist das notwendig?
Einige Buchstaben besitzen einen kurzen Code, bei einigen ist dieser sehr lang. Begründen Sie, warum dies so festgelegt wurde.
Ein Wort im Sinne der Codierung ist hier beim Morse-Code ein einzeln codiertes Zeichen. Geben Sie an, aus wie vielen Zeichen im Mittel jedes Morse-Codewort besteht.
Der Sender codiert eine Nachricht mit dem Morse-Code:
.. -.-. .... -.. . -. -.- . --..-- .- .-.. ... ---Aufgrund von Übertragungsfehlern erhält der Empfänger allerdings:
.- -.-. ..-. -.. . -. -.- . --..-- .- .-.. ... ---Entscheiden Sie, ob und inwieweit der Empfänger einer Morse-codierten Nachricht Übertragungsfehler erkennen und/oder korrigieren kann.
| Zeichen | Morsecode |
|---|---|
| A | .- |
| B | -... |
| C | -.-. |
| D | -.. |
| E | . |
| F | ..-. |
| G | --. |
| H | .... |
| I | .. |
| J | .--- |
| K | -.- |
| L | .-.. |
| M | -- |
| N | -. |
| O | --- |
| P | .--. |
| Q | --.- |
| R | .-. |
| S | ... |
| T | - |
| U | ..- |
| V | ...- |
| W | .-- |
| X | -..- |
| Y | -.-- |
| Z | --.. |
| 1 | .---- |
| 2 | ..--- |
| 3 | ...-- |
| 4 | ....- |
| 5 | ..... |
| 6 | -.... |
| 7 | --... |
| 8 | ---.. |
| 9 | ----. |
| 0 | ----- |
| . | .-.-.- |
| , | --..-- |
| ? | ..--.. |
| ' | .----. |
| ! | -.-.-- |
| / | -..-. |
| ( | -.--. |
| ) | -.--.- |
| & | .-... |
| : | ---... |
| ; | -.-.-. |
| = | -...- |
| + | .-.-. |
| - | -....- |
| _ | ..--.- |
| " | .-..-. |
| $ | ...-..- |
| @ | .--.-. |
Ein Genforscher entwickelte einen Binärcode für Gen-Sequenzen. Die vier Basen der DNA (Adenin, Guanin, Thymin und Cytosin) werden mit den Buchstaben A, G, T und C bezeichnet. Die Basen werden wie folgt codiert: A: 00 / G: 01 / T: 10 / C: 11.
Übersetzen Sie mithilfe dieses Binärcodes die dargestellte Gen-Sequenz.
Überlegen Sie sich eine eigene kurze Sequenz von maximal 10 Zeichen und codieren Sie diese entsprechend.
Der Sender codiert die Gen-Sequenz:
Der Empfänger erhält:
Übersetzen Sie die erhaltene Sequenz selbst. Entscheiden Sie, ob und inwieweit der Empfänger einer mit dem Gen-Code codierten Nachricht Übertragungsfehler erkennen und/oder korrigieren kann.
Der Binärcode wird erweitert. Ein zusätzliches Bit, welches die Summe der ersten beiden Bit ist, wird zusätzlich angehängt. (Hinweis: Wenn die beiden Informationsbit gleich sind, ist das zusätzliche Bit 0, ansonsten 1.)
Nun erhält der Empfänger in Aufgabenteil c) die Nachricht
Übersetzen/Decodieren Sie nun erneut die Nachricht. Entscheiden Sie, ob jeder Fehler erkannt werden kann.
Als Informationsrate eines Codes bezeichnet man den Anteil der Codezeichen eines Codewortes, welche die eigentlichen Informationen beinhalten. Berechnen Sie die Informationsrate des hier vorgestellten 3-Bit-Codes.
Recherchieren Sie im Internet, bei welchen Codes „im Alltag" die Prinzipien der Fehlererkennung und der Fehlerkorrektur verwendet werden.
Betrachten wir ein Bild auf einem Bildschirm und zoomen weit genug herein:
Vergrößert man das rechte Bild noch weiter, kann man erkennen, dass es aus kleinen farbigen Quadraten zusammengesetzt ist. Solch ein Quadrat wird Pixel (der) genannt.
Wenn man einen Bildschirm unter ein Mikroskop legt, wird der technische Aufbau erkennbar:
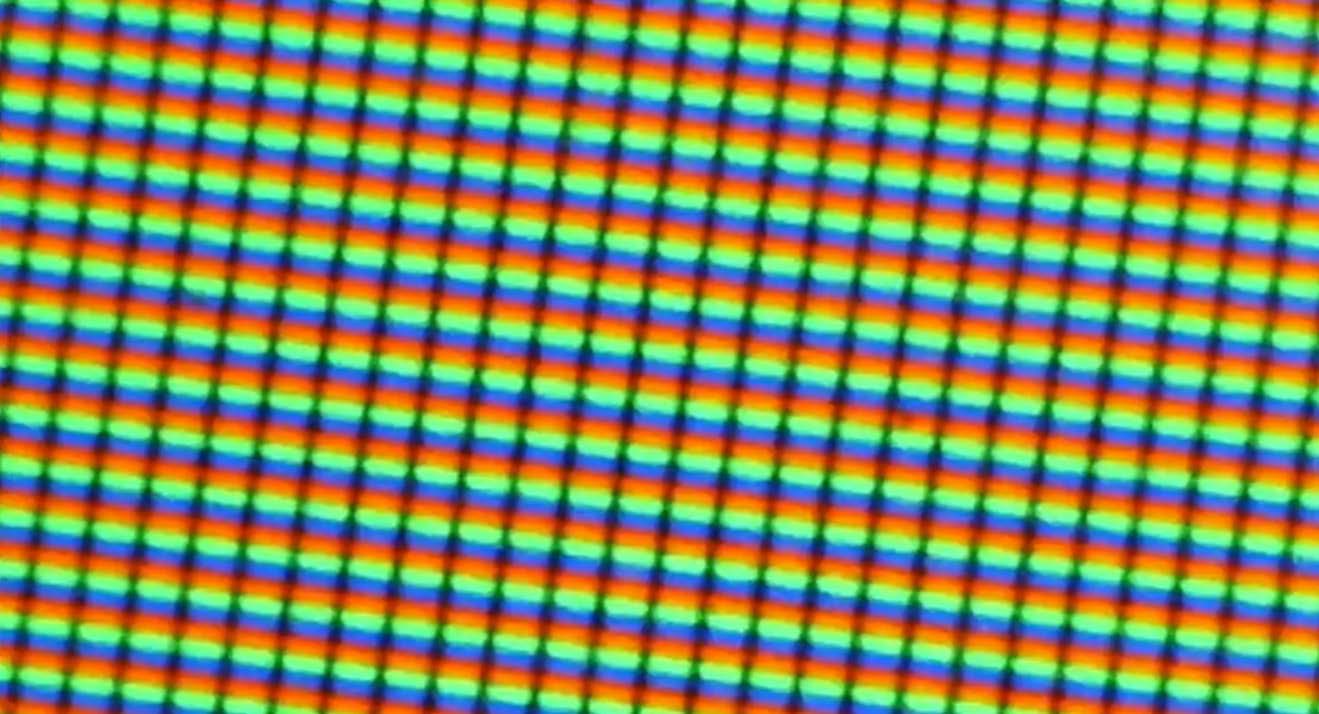
Ein Pixel eines Displays besteht aus je drei LED. Diese können in den Farben Rot, Grün und Blau in unterschiedlicher Intensität leuchten.
Grundlage: Das RGB-Farbmodell
Das RGB-Farbmodell ist ein additives Farbmodell, bei welchem eine Farbe durch die Angabe des Rot-, Grün- und Blauanteils definiert wird.
Man kann sich diese Farbmischung so vorstellen, als würden je eine Lichtquelle mit rotem, grünem und blauem Licht auf einen Punkt scheinen. Das Licht auf dem Punkt ist dann eine Mischung aus den drei Farben. Die Intensität der jeweiligen Farbe ist umso stärker, je stärker die jeweilige Lichtquelle strahlt.
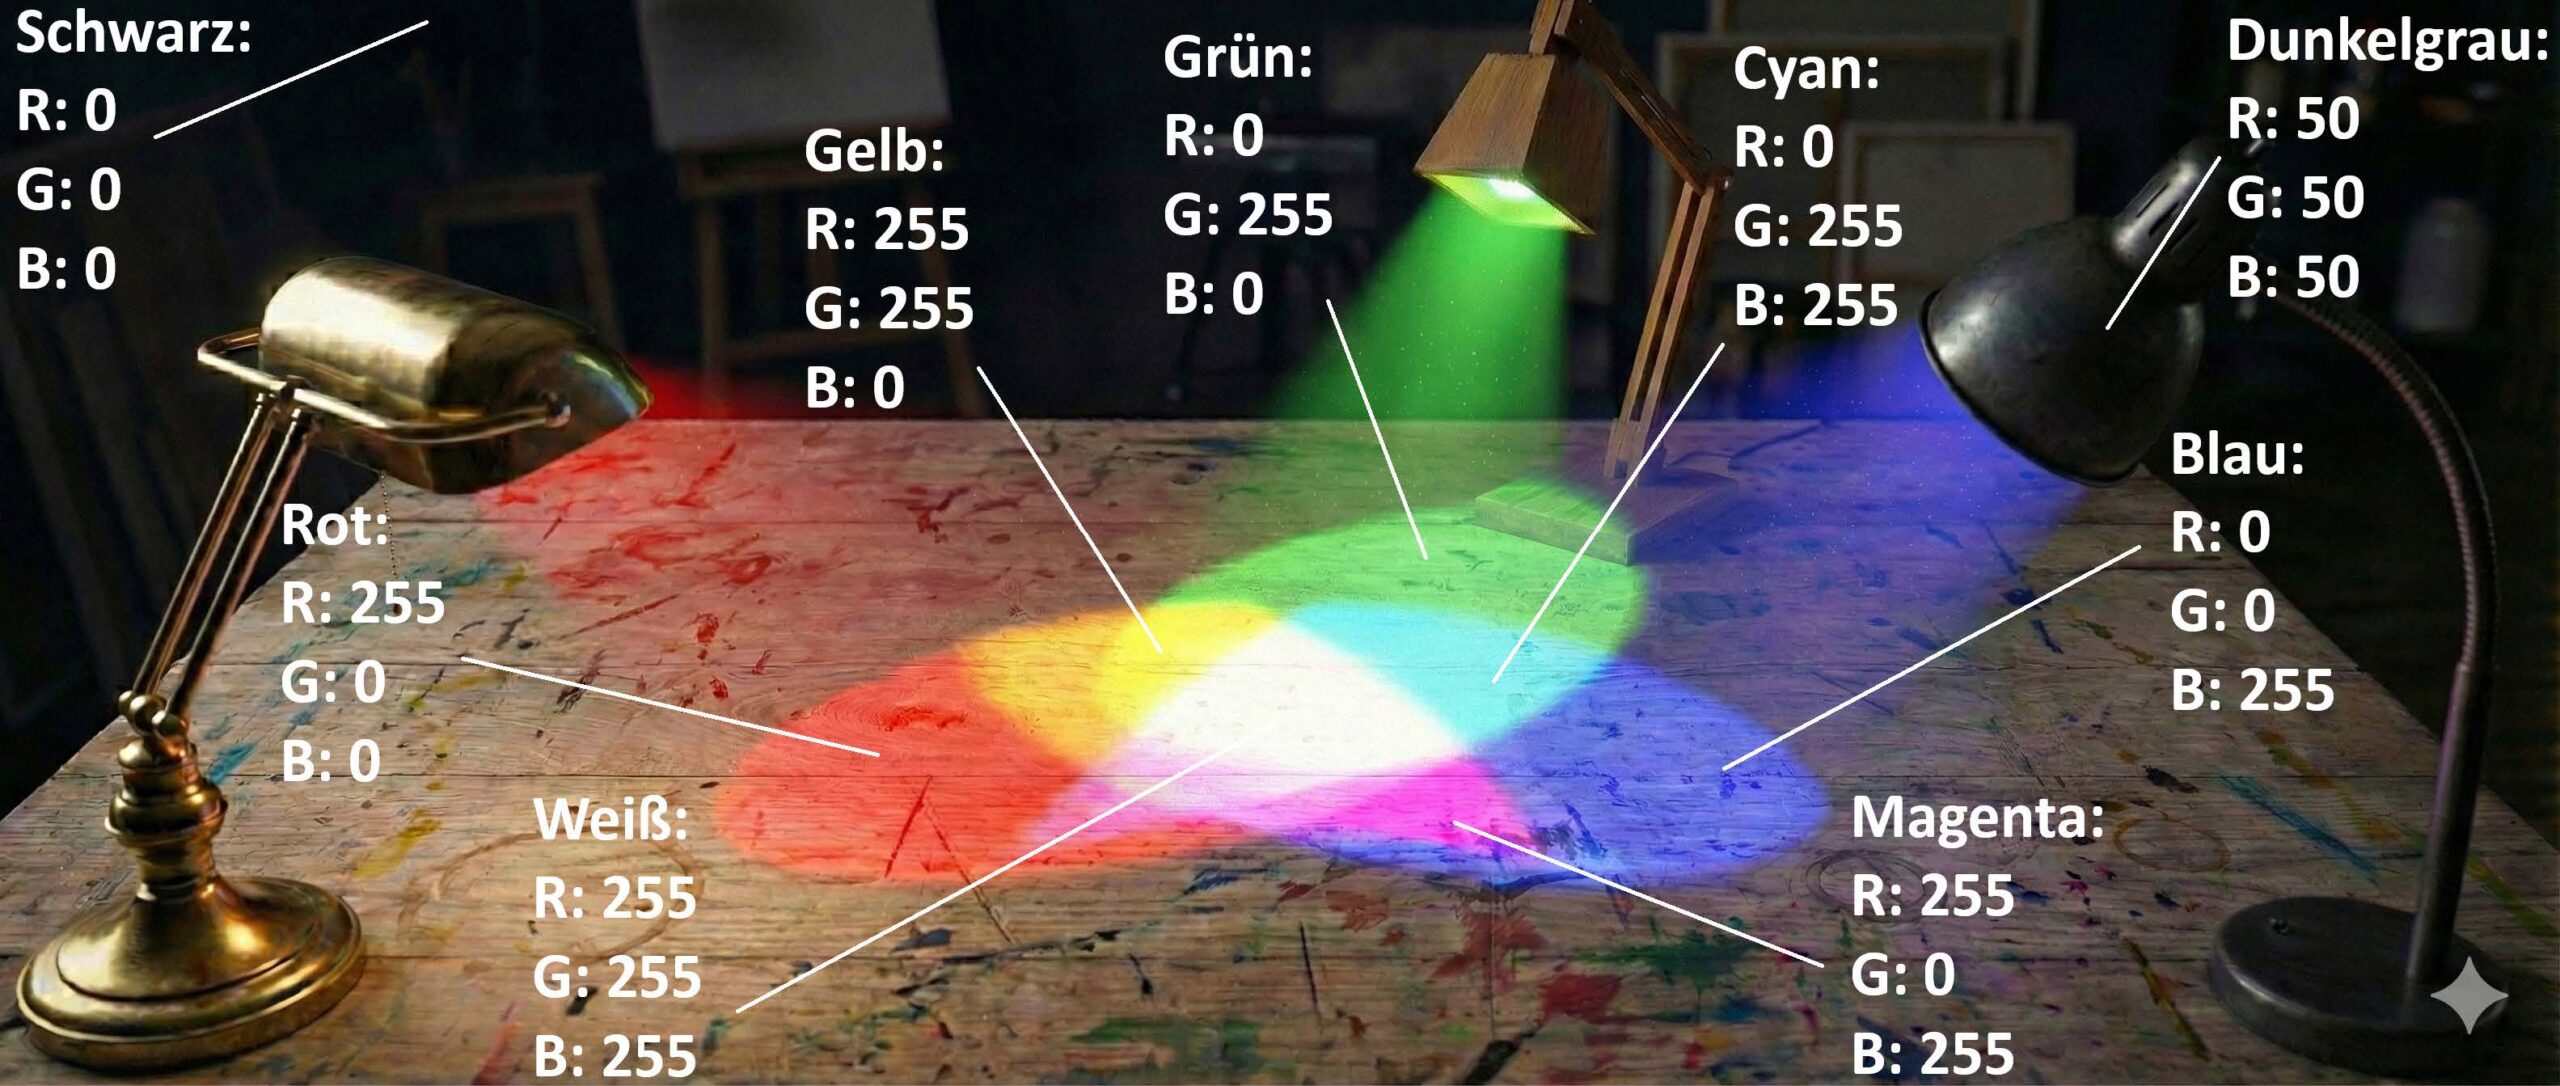
Überschneiden sich zwei Lichtkreise, so entstehen die Sekundärfarben Gelb, Magenta und Cyan. In der Mitte überschneiden sich alle drei Lichtkreise, wobei die Mischung Weiß erscheint. Die Farbe Schwarz wird durch die Dunkelheit (kein Licht) im umgebenden Raum dargestellt.
Die Farbanteile (r, g, b) werden dabei in Zahlen von 0 bis 255 codiert. Je höher ein Zahlenwert, desto intensiver ist die dazugehörige Farbe. So ergeben sich
verschiedene Farben.
Für jeden Farbanteil werden aufgrund der 256 = 2⁸ Möglichkeiten 8 Bit, also ein Byte, Speicher benötigt. Da es drei Farbanteile sind, benötigt ein gespeichertes Pixel eines Bildes somit 3 · 8 = 24 Bit, oder 3 Byte.
Beispiele für die binäre Darstellung einiger Farben:
| Farbe | Dezimalwerte | Binärwerte |
|---|---|---|
| Rot | (255, 0, 0) | (11111111, 00000000, 00000000) |
| Grün | (0, 255, 0) | (00000000, 11111111, 00000000) |
| Magenta | (255, 0, 255) | (11111111, 00000000, 11111111) |
| Dunkelgrau | (50, 50, 50) | (00110010, 00110010, 00110010) |
| Hellgrau | (200, 200, 200) | (11001000, 11001000, 11001000) |
Speicherung eines Bildes – ein Beispiel
Betrachten wir nun ein kleines Bild. Dieses liegt in Form einzelner Pixel vor und hat die Maße 4×4 Pixel.
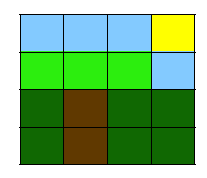
Im Standard-RGB-Format würde das Bild zeilenweise in der folgenden Form gespeichert werden (die Leerzeichen sind nur zur besseren Lesbarkeit vorhanden):
| 10000011 11001010 11111111 | 10000011 11001010 11111111 | 10000011 11001010 11111111 | 11111111 11111111 00000000 |
| 00101100 11101110 00001110 | 00101100 11101110 00001110 | 00101100 11101110 00001110 | 10000011 11001010 11111111 |
| 00010000 01101000 00000010 | 01100001 00111001 00000000 | 10000011 11001010 11111111 | 10000011 11001010 11111111 |
| 10000011 11001010 11111111 | 01100001 00111001 00000000 | 10000011 11001010 11111111 | 10000011 11001010 11111111 |
Die Stationen 4–8 sind weitgehend nach einer Idee von Carsten Rohe (Lohne, 2024) erstellt und editiert worden.
Bearbeiten Sie mindestens vier Lernstationen, wobei die Lernstation 1 verpflichtend ist.
Betrachten wir nun ein einfaches 17×11-Pixelbild:
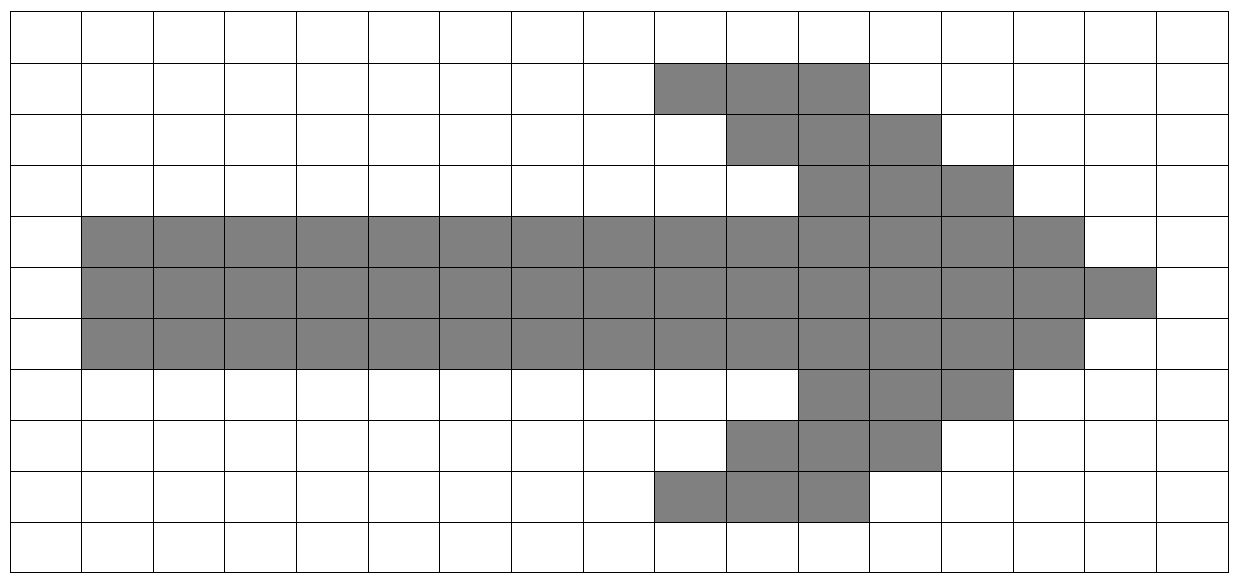
Das Bild „Pfeil", siehe oben, wird im Bitmap-Format Punkt für Punkt gespeichert. Das bedeutet, jeder Pixel kann mit 1 für weiß und 0 für schwarz einzeln gespeichert werden. Im Bitmap-Format (.bmp) wird nun jede Farbe mit einem Bit gespeichert; durch die Vorabinformation an den Computer, dass 0 weiß und 1 schwarz bedeutet, sparen wir hier bereits Speicherplatz ein.
Untersucht, wie viel Ersparnis beim Speicherbedarf man mit dieser Methode im Vergleich zur Standard-RGB-Speicherung erzielen kann. Berücksichtigt auch zusätzlich notwendige Informationen, die ein Computer für die Rekonstruktion des Bildes benötigt.
Berechnet zunächst den Speicherbedarf mit Standard-RGB (24 Bit pro Pixel), dann mit 1 Bit pro Pixel. Die Anzahl der Pixel ist 17 · 11 = 187.
Bei der 1-Bit-Methode braucht der Computer zusätzlich eine kleine Codewortabelle (welche RGB-Farbe zu 0 bzw. 1 gehört) – das sind zwei zusätzliche 24-Bit-RGB-Werte.
Als zusätzliche Informationen benötigt der Computer:
- Zwei Farben: 1 für 11111111 11111111 11111111, 0 für 00000000 00000000 00000000
- Maße: 17×11
Der Dateikörper ist:
Also ist das Bild 11×17 Bit = 187 Bit groß, zuzüglich des Speicherplatzes für einen Namen und andere Zusatzinformationen zur Datei, wie eine Codewortabelle der folgenden Form:
| Codewort | RGB-Wert |
|---|---|
| 0 | 11111111 11111111 11111111 |
| 1 | 00000000 00000000 00000000 |
Bei einem Schwarz-Weiß-Bild mit der Auflösung 1024 × 768 Pixel ist der Dateikörper bei der Bitmap-Codierung bereits 786.432 Bit groß. Ist es möglich, die Größe des Dateikörpers zu verkleinern, ohne Bildinformationen zu verlieren? Statt
kann man auch 26-mal weiß, 3-mal schwarz, 15-mal weiß, 3-mal schwarz, ... schreiben.
Vervollständigt die so entstehende Reihe (die Abkürzungen mit 26w, 3s, ... genügen).
Geht die Bitfolge von links nach rechts durch und zählt, wie viele gleiche Ziffern jeweils direkt hintereinander stehen, bevor sich die Ziffer ändert.
Das erscheint momentan nicht unbedingt kürzer, aber nun wird die folgende Codierung vereinbart: Ein Codewort besteht aus vier Zeichen. Das erste Bit legt die Farbe fest (0 für Weiß und 1 für Schwarz). Die folgenden drei Bit geben an, wie oft die Farbe wiederholt wird (000 für einmal, 001 für zweimal und so weiter).
Vervollständigt die folgende Codewortabelle und codiert das Bild „Pfeil" der vorherigen Seite mit dieser Codierung.
| Code | Farbe | Pixel | Code | Farbe | Pixel |
|---|---|---|---|---|---|
| 0000 | Weiß | 1 | Schwarz | 1 | |
| Weiß | 2 | Schwarz | 2 | ||
| Weiß | 3 | Schwarz | 3 | ||
| Weiß | 4 | Schwarz | 4 | ||
| Weiß | 5 | Schwarz | 5 | ||
| Weiß | 6 | Schwarz | 6 | ||
| Weiß | 7 | Schwarz | 7 | ||
| 0111 | Weiß | 8 | 1111 | Schwarz | 8 |
Die letzten drei Bit zählen einfach von 000 bis 111 hoch (das entspricht den Pixelanzahlen 1 bis 8). Das erste Bit bleibt für die gesamte linke Tabellenhälfte 0, für die rechte Hälfte 1.
Dekodiert die folgenden Daten für ein Bild mit 8 Pixel Breite und 11 Pixel Höhe, das mit der Codierung aus Aufgabenteil c) codiert wurde.
Übersetzt jedes der 19 vierstelligen Codewörter einzeln mit eurer Tabelle aus c) in „Farbe × Anzahl" und reiht die Pixel dann in dieser Reihenfolge aneinander (8 Pixel pro Zeile, dann in die nächste Zeile).
Zählt am Ende alle decodierten Pixel zusammen – es müssen genau 8 · 11 = 88 sein.
Begründet, dass die Lauflängencodierung prä- und suffixfrei ist.
Alle Codewörter sind hier exakt 4 Bit lang. Überlegt: Kann ein 4-Bit-Codewort jemals der Anfang (Präfix) oder das Ende (Suffix) eines ANDEREN 4-Bit-Codeworts sein, wenn beide dieselbe Länge haben?
Die bisher verwendete Form der Lauflängencodierung bestand aus Codeblöcken von je vier Bit. Entwickelt eine Codetabelle für eine Gesamtblocklänge von drei Bit, wobei in der neuen Situation nur zwei Bit für die Lauflängen genutzt werden.
Mit 2 Bit für die Lauflänge lassen sich 2² = 4 verschiedene Werte darstellen (000 bis 011 in den letzten zwei Stellen) – also Wiederholungen von 1 bis 4.
Vergleicht den 4-Bit-Code mit dem 3-Bit-Code. Untersucht, bei welcher Art von Bild die 4-Bit-Codierung von Vorteil ist und bei welcher Art von Bild die 3-Bit-Codierung.
Überlegt für ein Bild mit vielen kurzen Lauflängen (viele Farbwechsel) und für ein Bild mit sehr langen Lauflängen (wenige, große zusammenhängende Flächen) jeweils separat, welcher Code weniger Bit insgesamt benötigt.
🎉 Alle Teilaufgaben bearbeitet!
a) Speicherersparnis
| Methode | Rechnung | Ergebnis |
|---|---|---|
| Standard-RGB | 187 Pixel · 24 Bit | 4.488 Bit |
| 1-Bit-Speicherung | 187 Pixel · 1 Bit + 2 · 24 Bit (Codewortabelle) | 235 Bit |
Ersparnis: (4.488 − 235) / 4.488 ≈ 94,8 %.
b) Lauflängen-Reihe
(Summe der Lauflängen: 184 – die geringfügige Abweichung von den in der Aufgabenstellung genannten 187 Bit liegt vermutlich an einer minimalen Ungenauigkeit beim Abtippen der langen Bitfolge in der Vorlage; das Vorgehen bleibt identisch.)
c) Codewortabelle
| Code | Farbe | Pixel | Code | Farbe | Pixel |
|---|---|---|---|---|---|
| 0000 | Weiß | 1 | 1000 | Schwarz | 1 |
| 0001 | Weiß | 2 | 1001 | Schwarz | 2 |
| 0010 | Weiß | 3 | 1010 | Schwarz | 3 |
| 0011 | Weiß | 4 | 1011 | Schwarz | 4 |
| 0100 | Weiß | 5 | 1100 | Schwarz | 5 |
| 0101 | Weiß | 6 | 1101 | Schwarz | 6 |
| 0110 | Weiß | 7 | 1110 | Schwarz | 7 |
| 0111 | Weiß | 8 | 1111 | Schwarz | 8 |
d) Decodiertes Bild (⬜ = Weiß, ⬛ = Schwarz, 8 Pixel breit, 11 Pixel hoch):
⬜⬜⬜⬜⬜⬜⬜⬜
⬜⬜⬛⬛⬛⬛⬜⬜
⬜⬜⬜⬜⬜⬛⬜⬜
⬜⬜⬜⬜⬜⬛⬜⬜
⬜⬜⬜⬜⬛⬛⬜⬜
⬜⬜⬜⬛⬜⬜⬜⬜
⬜⬜⬛⬜⬜⬜⬜⬜
⬜⬜⬛⬛⬛⬛⬜⬜
⬜⬜⬜⬜⬜⬜⬜⬜
⬜⬜⬜⬜⬜⬜⬜⬜
(Decodierte Reihenfolge: 8w,8w,2w,4s,7w,1s,7w,1s,6w,2s,5w,1s,6w,1s,7w,4s,8w,8w,2w — insgesamt 88 Pixel, passt exakt zu 8×11.)
e) Prä- und Suffixfreiheit
Da alle Codewörter exakt 4 Bit lang sind, kann kein Codewort Anfang (Präfix) oder Ende (Suffix) eines anderen, gleich langen Codeworts sein – zwei unterschiedliche Zeichenketten gleicher Länge können nur identisch oder komplett verschieden sein, niemals eine „Teilmenge" der anderen. Damit ist jeder Code mit fester Codewortlänge automatisch prä- und suffixfrei.
f) 3-Bit-Codetabelle (1 Bit Farbe + 2 Bit Lauflänge)
| Code | Farbe | Anzahl |
|---|---|---|
| 000 | Weiß | 1 |
| 001 | Weiß | 2 |
| 010 | Weiß | 3 |
| 011 | Weiß | 4 |
| 100 | Schwarz | 1 |
| 101 | Schwarz | 2 |
| 110 | Schwarz | 3 |
| 111 | Schwarz | 4 |
g) Vergleich
Der 3-Bit-Code ist günstiger bei Bildern mit vielen kurzen, häufig wechselnden Lauflängen (z. B. detailreiche, „unruhige" Bilder), da jedes Codewort ein Viertel weniger Speicher benötigt. Der 4-Bit-Code ist dagegen bei Bildern mit wenigen, langen zusammenhängenden Farbflächen im Vorteil, da lange Lauflängen (bis 8) mit einem einzigen Codewort abgedeckt werden können – beim 3-Bit-Code müssten Lauflängen über 4 künstlich aus mehreren Codewörtern zusammengesetzt werden, was den Vorteil wieder zunichtemachen kann.
Betrachten wir eine Codierung, welche in einem Supermarkt für Artikel genutzt wird. Jeder Artikel erhält eine Ziffernkombination aus acht Ziffern. Die ersten drei Ziffern sind eine Ländernummer, die folgenden vier stehen für die interne Artikelnummer und die letzte Ziffer ist eine sogenannte Prüfziffer.
Ein Beispiel: 20954789
| Ländernummer | Artikelnummer | Prüfziffer |
|---|---|---|
| 209 | 5478 | 9 |
Die Prüfziffer berechnet sich folgendermaßen. Zunächst berechnet man eine gewichtete Summe der ersten sieben Ziffern nach der Methode:
| Ziffer | 2 | 0 | 9 | 5 | 4 | 7 | 8 |
| Gewichtung | 3 | 1 | 3 | 1 | 3 | 1 | 3 |
| Ergebnisse | 2·3=6 | 0·1=0 | 9·3=27 | 5·1=5 | 4·3=12 | 7·1=7 | 8·3=24 |
| Summe | 6+0+27+5+12+7+24=81 | ||||||
Die Prüfziffer ist die Ziffer, welche die Summe zum nächsten Vielfachen von 10 ergänzt. Hier: 81 + 9 = 90.
Implementiert ein Programm in Scratch, welches aus einer eingegebenen Länder- und Artikelnummer eine entsprechende Prüfziffer erstellt und das gesamte Codewort ausgibt.
1) Länder- und Artikelnummer zu einer 7-stelligen Zeichenkette zusammenfügen. 2) Mit einer Schleife jede der 7 Ziffern einzeln auslesen (Zeichen an Position i). 3) Je nach Position (ungerade/gerade) mit 3 bzw. 1 gewichten und aufsummieren.
Nutzt den Rest-Operator (mod 10) auf die Summe, um zu bestimmen, wie weit die Summe vom nächsten Vielfachen von 10 entfernt ist: Prüfziffer = (10 − (Summe mod 10)) mod 10.
Implementiert ein Programm in Scratch, welches ein eingegebenes Codewort dieser Art auf seine Korrektheit überprüft. Ist die Prüfziffer falsch, soll eine entsprechende Fehlermeldung ausgegeben werden.
klartext, unter welcher die Eingabe gespeichert wird, und geheimtext, unter welcher der Geheimtext aufgebaut wird. Außerdem eine Variable index zum Durchlaufen des Klartextes.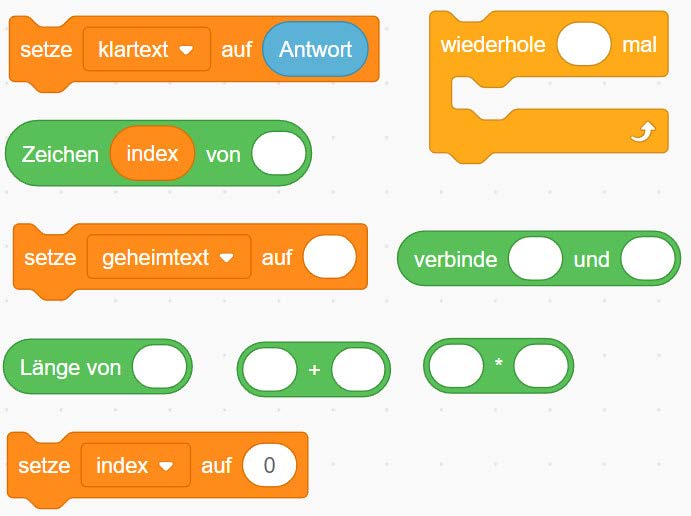
Berechnet aus den ersten 7 Ziffern des eingegebenen Codeworts (genau wie in a) die "richtige" Prüfziffer und vergleicht sie anschließend mit der 8. Ziffer des eingegebenen Codeworts.
Stimmen berechnete und eingegebene Prüfziffer überein, meldet „Codewort korrekt", ansonsten „Fehler: Prüfziffer stimmt nicht".
Analysiert, wie viele Fehler diese Codierung sicher erkennen kann.
Überlegt: Wenn sich genau eine Ziffer ändert, ändert sich die gewichtete gewichtete Summe um (Gewicht · Differenz) mod 10. Kann dieser Ausdruck bei einer echten Änderung (Differenz ≠ 0) jemals wieder 0 mod 10 ergeben, wenn das Gewicht nur 1 oder 3 ist?
🎉 Alle Teilaufgaben bearbeitet!
a) & b) Scratch-Pseudocode (da Scratch grafisch ist, hier als Pseudocode-Gerüst):
// a) Prüfziffer erstellen
setze code = laendernummer + artikelnummer   // 7 Zeichen
setze summe = 0
für index von 1 bis 7:
    ziffer = Zeichen an Position index von code
    wenn index ungerade: gewicht = 3
    sonst: gewicht = 1
    summe = summe + ziffer * gewicht
pruefziffer = (10 - (summe mod 10)) mod 10
sage code + pruefziffer

// b) Codewort prüfen
setze eingabe = (eingegebenes 8-stelliges Codewort)
setze code = erste 7 Zeichen von eingabe
setze eingegebenePruefziffer = 8. Zeichen von eingabe
// dieselbe Rechnung wie oben, um berechnetePruefziffer zu erhalten
wenn berechnetePruefziffer = eingegebenePruefziffer:
    sage "Codewort korrekt"
sonst:
    sage "Fehler: Prüfziffer stimmt nicht"
c) Fehlererkennung
Diese Codierung erkennt jeden Einzelfehler (also die Änderung genau einer Ziffer) sicher: Ändert sich eine Ziffer um Δ (Δ ≠ 0, da eine andere Ziffer eingegeben wurde), ändert sich die gewichtete Summe um Gewicht · Δ. Da die Gewichte nur 1 oder 3 sind und beide teilerfremd zu 10 sind, ist Gewicht · Δ mod 10 nur dann 0, wenn Δ = 0 ist (was einer echten Änderung widerspricht). Die Prüfsumme ändert sich also bei jedem Einzelfehler zwangsläufig, und der Fehler wird erkannt.
Nicht sicher erkannt werden dagegen z. B. bestimmte Vertauschungen (Transpositionen) benachbarter Ziffern: Da benachbarte Positionen abwechselnd mit 3 und 1 gewichtet werden, kann eine Vertauschung zweier Ziffern mit Differenz Δ die Summe um (3−1)·Δ = 2Δ verändern – ist 2Δ ein Vielfaches von 10 (z. B. bei Δ = 5), bleibt die Prüfsumme unverändert und der Fehler bleibt unentdeckt.
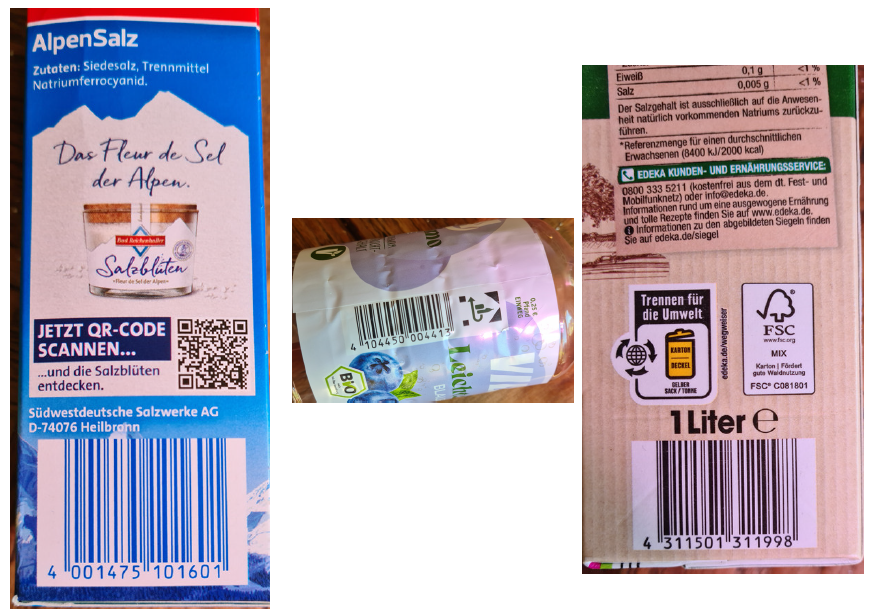
Der EAN-13-Code ist ein weit verbreiteter Barcode-Standard, der auf Produkten in Supermärkten und Einzelhandelsgeschäften weltweit zu finden ist. Er besteht aus 13 Ziffern, die wichtige Informationen über das Produkt enthalten, wie die Länderkennung, die Herstellerkennung und die Artikelnummer.
Der Barcode ermöglicht es, Produkte schnell und effizient zu scannen, was den Bezahlvorgang an der Kasse beschleunigt und die Lagerverwaltung vereinfacht. Die letzte Ziffer des Codes ist eine Prüfziffer, die zur Überprüfung der Korrektheit des Barcodes dient. In dieser Aufgabe lernt ihr, wie der EAN-13-Code aufgebaut ist, wie er decodiert wird und wie ihr selbst einen solchen Code erstellen könnt.
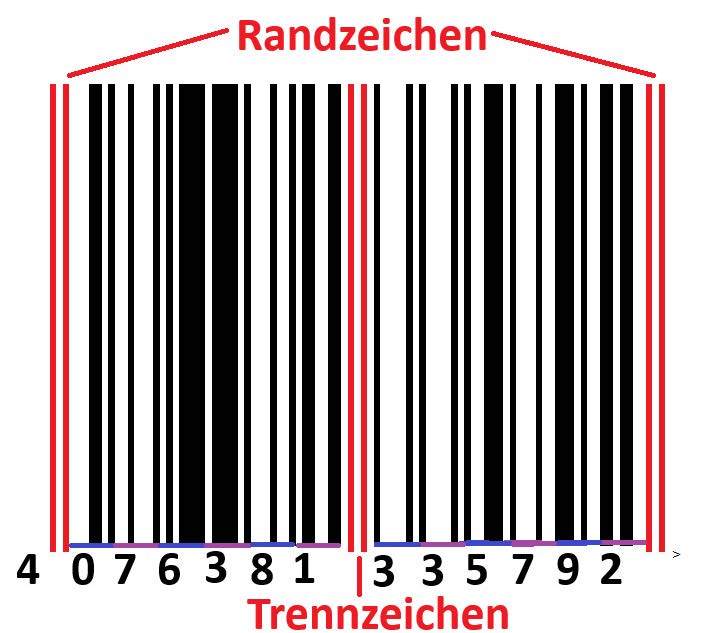
Die roten Striche sind nur Trennzeichen, die nicht für die Codierung der Ziffern verwendet werden.
(arbeitsteilige Partnerarbeit) In dieser Aufgabe sollt ihr entdecken, wie jede Ziffer des EAN-13-Codes durch Striche codiert wird. Ihr könnt euch aussuchen, wer welche Hälfte untersucht:
| Schwieriger (Person 1) | Standard (Person 2) |
|---|---|
| ... die linke Hälfte untersuchen. Bei Code 1 sind das die Ziffern 0, 4, 6, 3, 8 und 1. Die 7 ignoriert ihr zunächst. Die Codewörter für die Ziffern haben irgendetwas mit den Strichen zu tun. Achtung: Die Ziffern werden nicht immer gleich codiert. Es kommt auf die Position an. | ... die rechte Hälfte untersuchen. Bei Code 1 sind das die Ziffern 3, 3, 5, 7, 9 und 2. Die Codewörter für die Ziffern haben irgendetwas mit den Strichen zu tun. |
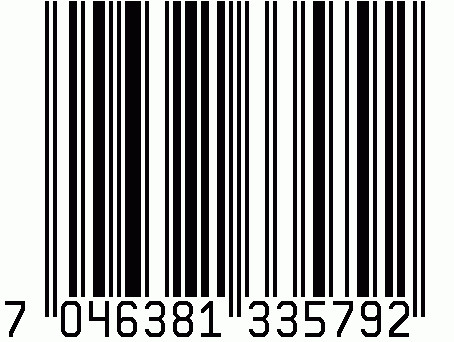
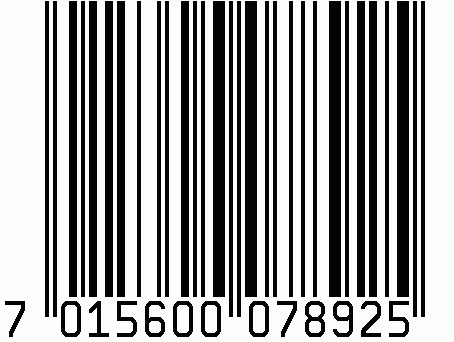
Für jede Seite sind zwei Ziffern in der Codewortabelle vorgegeben. Eure Aufgabe ist es, die restlichen Codierungen zu entdecken und die Tabelle zu vervollständigen. Nachdem ihr die Tabellen vervollständigt habt, tauscht eure Ergebnisse aus und erstellt gemeinsam eine vollständige Codewortabelle. Hier sind sechs Beispielbarcodes:

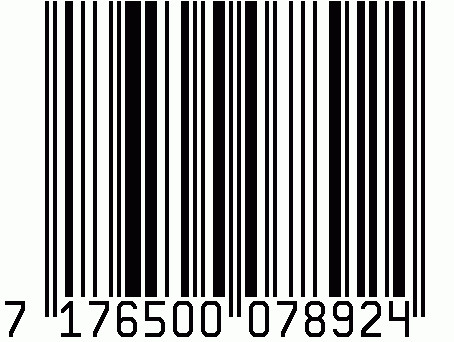
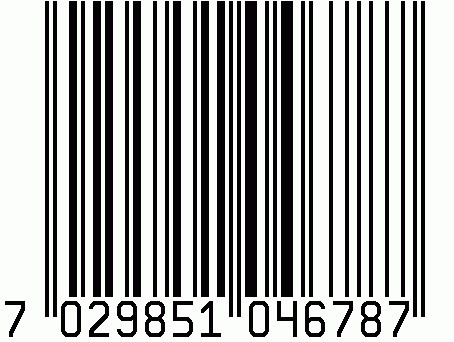
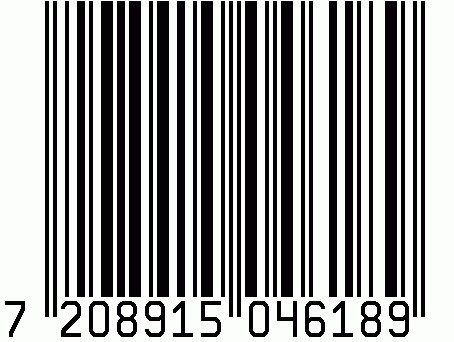
| Ziffer | Codierung |
|---|---|
| 0 | 0001101 |
| 1 | |
| 2 | |
| 3 | |
| 4 | 0100011 |
| 5 | |
| 6 | |
| 7 | |
| 8 | |
| 9 |
| Ziffer | Codierung |
|---|---|
| 0 | |
| 1 | 0110011 |
| 2 | |
| 3 | |
| 4 | |
| 5 | |
| 6 | 0000101 |
| 7 | |
| 8 | |
| 9 |
| Ziffer | Codierung |
|---|---|
| 0 | |
| 1 | 1100110 |
| 2 | |
| 3 | |
| 4 | |
| 5 | |
| 6 | |
| 7 | 1000100 |
| 8 | |
| 9 |
Zählt in den gegebenen Beispielcodes (0=0001101, 4=0100011 für A) jeweils, wie viele Striche (Einsen) enthalten sind und wo sie stehen. Vergleicht das mit der Ziffer.
Vergleicht die A- und B-Codes derselben Ziffer (z. B. Ziffer 1: B=0110011). Fällt euch ein Zusammenhang auf (z. B. Bit-Umkehrung oder Spiegelung)?
Erstellt eine Beschreibung zum Aufbau des EAN-13-Barcodes. Es soll deutlich werden,
- wie der Code insgesamt aufgebaut ist,
- wie die einzelnen Ziffern in der linken und in der rechten Hälfte codiert werden.
Beschreibt den Barcode von links nach rechts: Startzeichen, 6 Ziffern linke Hälfte (je 7 Bit, A oder B codiert), mittleres Trennzeichen, 6 Ziffern rechte Hälfte (je 7 Bit, R codiert), Endzeichen – plus die "unsichtbar" mitcodierte 1. Ziffer.
Nun kommen wir zur ersten Ziffer. In den sechs Beispielen war die erste Ziffer immer die 7. Die 7 steht zwar links neben dem Barcode, ist aber nicht durch entsprechende Striche codiert. Dies wird erreicht, indem man die erste Ziffer durch die Codierung (A oder B) der folgenden sechs Ziffern in der linken Hälfte einfach mitcodiert.
Die folgende Tabelle stellt die Codierung der ersten Ziffer dar (Zeile für die Ziffer 7 hervorgehoben):
| 1. Ziffer | 2. Ziffer | 3. Ziffer | 4. Ziffer | 5. Ziffer | 6. Ziffer | 7. Ziffer |
|---|---|---|---|---|---|---|
| 0 | A | A | A | A | A | A |
| 1 | A | A | B | A | B | B |
| 2 | A | A | B | B | A | B |
| 3 | A | A | B | B | B | A |
| 4 | A | B | A | A | B | B |
| 5 | A | B | B | A | A | B |
| 6 | A | B | B | B | A | A |
| 7 | A | B | A | B | A | B |
| 8 | A | B | A | B | B | A |
| 9 | A | B | B | A | B | A |
Erstellt eine Codierung für eine EAN-13-Nummer 4076381335792.
Erläutert mit Hilfe der obigen Tabelle, wie die erste Ziffer im EAN-13-Code codiert wird.
Sucht in der Tabelle die Zeile eurer 1. Ziffer und lest daraus ab, ob die 2. bis 7. Ziffer eurer Nummer jeweils mit A oder B codiert werden muss.
Die Ziffern 8 bis 13 (rechte Hälfte) werden immer einheitlich mit dem R-Code codiert – hier gibt es keine A/B-Unterscheidung.
Ihr erhaltet zwei EAN-13-Barcodes, die ihr mithilfe der Codewortabellen aus Aufgabenteil a) und der Tabelle aus Aufgabenteil c) decodieren sollt. Anschließend erstellt ihr einen eigenen EAN-13-Code und tauscht ihn mit der anderen Person aus. Decodiert den Code, den ihr von der anderen Person erhalten habt.
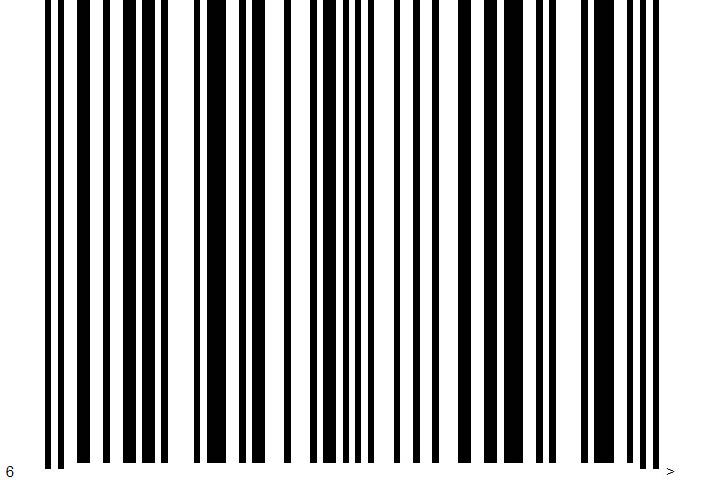
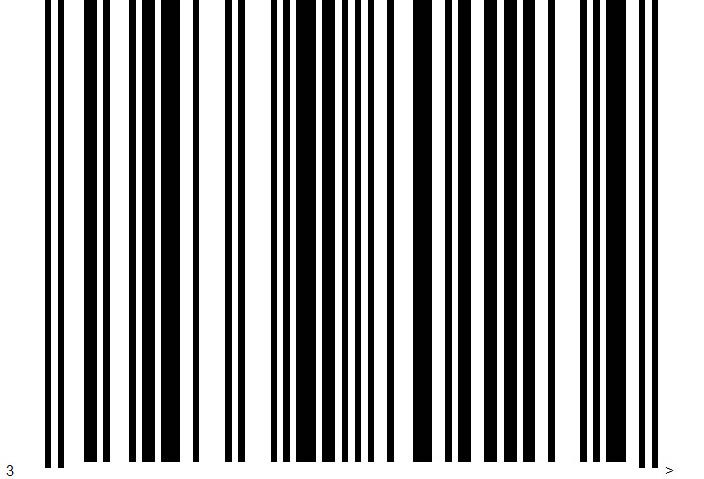
Lest zunächst die 7-Bit-Blöcke der linken Hälfte aus dem Barcode ab und schaut in euren A/B-Tabellen nach, welche Ziffer (und ob A oder B) jeweils passt. Aus der A/B-Abfolge lässt sich dann über die Tabelle aus c) die erste (versteckte) Ziffer bestimmen.
Zur Einordnung – Aufbau des EAN-13-Codes: Ein EAN-13-Code besteht aus 13 Ziffern, die in verschiedene Bereiche unterteilt sind:
- Ländercode (1. bis 3. Ziffer): repräsentiert den Ländercode bzw. die Ländergruppe, in der der Barcode registriert ist (z. B. „400–440" für Deutschland, „300–379" für Frankreich).
- Hersteller-Code (4. bis 10. Ziffer, je nach Vergabe unterschiedlich lang): wird von GS1 (Global Standards 1) vergeben und identifiziert den Hersteller.
- Artikel-Code (11. bis 12. Ziffer, je nach Vergabe unterschiedlich lang): identifiziert das konkrete Produkt innerhalb des Sortiments des Herstellers.
- Prüfziffer (13. Ziffer): validiert den gesamten Code über einen speziellen Algorithmus (Modulo-10-Verfahren).
Beispiel: 400123456789 → 400 (Ländercode Deutschland) · 123 (Hersteller-Code) · 4567 (Artikel-Code) · 9 (Prüfziffer)
(Zusatz) Die eigentlichen Produktinformationen stecken also in den ersten zwölf Ziffern. Jetzt fehlt nur noch eine genauere Betrachtung der 13. Ziffer, der Prüfziffer. In dieser Aufgabe lernt ihr, wie die Prüfziffer eines EAN-13-Barcodes berechnet wird.
- Multipliziere jede zweite Ziffer (beginnend mit der zweiten Ziffer) mit 3: 0, 6, 8, 3, 3, 3 → 0, 18, 24, 9, 9, 9
- Summe der ungeraden Positionen: 4+0+3+1+3+9 = 20
- Summe der geraden Positionen (nach Multiplikation): 0+18+24+9+9+9 = 69
- Gesamtsumme: 20+69 = 89
- Nächstes Vielfaches von 10: 90 → Prüfziffer: 90−89 = 1
Erstellt einen eigenen EAN-13-Code aus zwölf Ziffern und berechnet die Prüfziffer. Tauscht ihn mit eurem Sitznachbarn aus. Überprüft, ob die Prüfziffer bei dem Code, den ihr von eurem Sitznachbarn erhalten habt, korrekt ist.
Geht mit euren eigenen 12 Ziffern exakt wie im Beispielcode vor: gerade Positionen mit 3 multiplizieren, alle 12 Werte addieren, zum nächsten Vielfachen von 10 auffüllen.
🎉 Alle Teilaufgaben bearbeitet!
a) Vollständige Codewortabelle (Standard-EAN-13-Codierung – die von euch entdeckten Muster sollten hiermit übereinstimmen):
| Ziffer | Code |
|---|---|
| 0 | 0001101 |
| 1 | 0011001 |
| 2 | 0010011 |
| 3 | 0111101 |
| 4 | 0100011 |
| 5 | 0110001 |
| 6 | 0101111 |
| 7 | 0111011 |
| 8 | 0110111 |
| 9 | 0001011 |
| Ziffer | Code |
|---|---|
| 0 | 0100111 |
| 1 | 0110011 |
| 2 | 0011011 |
| 3 | 0100001 |
| 4 | 0011101 |
| 5 | 0111001 |
| 6 | 0000101 |
| 7 | 0010001 |
| 8 | 0001001 |
| 9 | 0010111 |
| Ziffer | Code |
|---|---|
| 0 | 1110010 |
| 1 | 1100110 |
| 2 | 1101100 |
| 3 | 1000010 |
| 4 | 1011100 |
| 5 | 1001110 |
| 6 | 1010000 |
| 7 | 1000100 |
| 8 | 1001000 |
| 9 | 1110100 |
Erkennbares Muster: Der B-Code einer Ziffer ist die exakte Bit-Umkehrung (0↔1) und Spiegelung des A-Codes derselben Ziffer; der R-Code ist die reine Bit-Invertierung (0↔1) des A-Codes.
b) Aufbau (Zusammenfassung)
Der Barcode besteht aus: Startzeichen – 6× 7-Bit-Block linke Hälfte (Ziffer 2–7, je nach 1. Ziffer mit A oder B codiert) – mittleres Trennzeichen – 6× 7-Bit-Block rechte Hälfte (Ziffer 8–13, immer R-codiert) – Endzeichen. Die 1. Ziffer wird nicht direkt durch Striche dargestellt, sondern ergibt sich implizit aus dem Muster, welche der sechs linken Ziffern mit A und welche mit B codiert wurden (siehe Tabelle in c).
c) Beispiel: Codierung der Nummer 4006381339312 (13-stellige Beispielnummer, da die Vorlagen-Nummer fehlerhaft war):
1. Ziffer = 4 → laut Tabelle Muster ABAABB für die Ziffern 2–7. Das heißt: Ziffer 2 mit A, Ziffer 3 mit B, Ziffer 4 mit A, Ziffer 5 mit A, Ziffer 6 mit B, Ziffer 7 mit B codieren. Ziffern 8–13 werden alle mit dem R-Code codiert.
d) Prüfziffer-Beispiel (eigener Code)
Beispielrechnung für die 12-stellige Nummer 400638133393 ist bereits oben vorgerechnet (Ergebnis: Prüfziffer 1, vollständiger Code 4006381333931). Verfahrt mit eurer eigenen Nummer nach demselben Schema.
In einem Bild sind sechs verschiedene Farbtöne enthalten. Die beiden Farben Rot und Schwarz treten sehr häufig auf, Blau und Gelb mit einer mittleren Häufigkeit, Grün und Violett selten. Um Speicherplatz bei der Codierung zu sparen, sollen Farben, die häufig vorkommen, mit einem kurzen Code dargestellt werden, seltene Farben mit einem längeren Code. Hierzu sollen neben einem Standardcode (Code A) zwei weitere Codierungsvarianten (Code B und Code C) betrachtet werden.
| Farbe | Code A | Code B | Code C |
|---|---|---|---|
| Rot | 000 | 00 | 10 |
| Schwarz | 010 | 11 | 11 |
| Blau | 101 | 01 | 00 |
| Gelb | 110 | 0111 | 011 |
| Grün | 100 | 1010 | 0100 |
| Violett | 001 | 11101 | 0101 |
In der folgenden Abbildung ist Code A in einem Codebaum grafisch dargestellt:
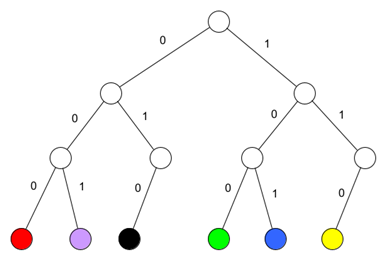
Erstellt jeweils einen Codebaum für den Code B und den Code C.
Jedes Bit eines Codeworts entspricht einer Abzweigung im Baum (z. B. 0 = links, 1 = rechts). Das Codewort selbst ist der Pfad von der Wurzel bis zur Farbe.
Zeichnet den Pfad für Schwarz (11) und den Pfad für Violett (11101) – was fällt euch auf, wenn ihr beide Pfade im selben Baum einzeichnet?
Analysiert, ob sich die Codefolge 110111101000 unter Verwendung der Codes A, B und C jeweils eindeutig decodieren lässt. Warum ist es wichtig, dass das Decodieren eindeutig sein muss?
Code A hat feste Länge 3 – zerlegt die 12-Bit-Folge einfach in vier 3er-Blöcke und schaut, ob jeder Block ein gültiges Codewort ist.
Beginnt am Anfang der Folge und prüft, ob die ersten 2, 3, 4 oder 5 Bit ein gültiges Codewort ergeben. Setzt danach an der Stelle fort, an der das gefundene Codewort endet.
Vergleicht die Codebäume der drei Codes A, B und C miteinander: Lässt sich an der Struktur des Baums eine grundsätzliche Problematik für das Decodieren erkennen? Was bedeutet dies für die Notwendigkeit, Trennzeichen (Pausen) zwischen den Codes der einzelnen Farbwerte verwenden zu müssen?
Prüft für jeden Baum: Stehen wirklich ALLE Farben an den Enden von Ästen (Blättern), oder liegt eine Farbe an einem Knoten, von dem noch weitere Äste abzweigen?
🎉 Alle Teilaufgaben bearbeitet!
a) Codebäume als Pfadbeschreibung (0 = links, 1 = rechts):
Code B: Rot = links-links · Blau = links-rechts · Schwarz = rechts-rechts · Gelb = links-rechts-rechts-rechts · Grün = rechts-links-rechts-links · Violett = rechts-rechts-rechts-links-rechts.
Auffällig: Der Pfad für Schwarz (rechts-rechts) ist der exakte Anfang des Pfades für Violett (rechts-rechts-rechts-links-rechts) – Schwarz liegt also nicht an einem Blatt, sondern an einem inneren Knoten, von dem der Ast zu Violett weiter abzweigt. Das ist strukturell unsauber (siehe c).
Code C: Blau = links-links · Rot = rechts-links · Schwarz = rechts-rechts · Gelb = links-rechts-rechts · Grün = links-rechts-links-links · Violett = links-rechts-links-rechts.
Hier liegen alle sechs Farben sauber an Blättern (keine Farbe ist Präfix einer anderen).
b) Decodierung von 110111101000
| Code | Ergebnis |
|---|---|
| A | Blöcke 110 | 111 | 101 | 000 → Gelb, 111 ist kein gültiges Codewort → nicht decodierbar |
| B | 11 | 01 | 11 | 1010 | 00 → Schwarz, Blau, Schwarz, Grün, Rot → decodierbar (einzige vollständige Zerlegung) |
| C | 11 | 011 | 11 | 0100 | 0 → Schwarz, Gelb, Schwarz, Grün, 1 Bit „0" bleibt übrig → nicht decodierbar |
Eindeutiges Decodieren ist essenziell, da sonst dieselbe Bitfolge unterschiedlich interpretiert werden könnte und die übertragene Information nicht mehr zuverlässig rekonstruierbar wäre – der Empfänger könnte nie sicher sein, welche Nachricht tatsächlich gemeint war.
c) Strukturvergleich
Bei Code A (feste Länge) und Code C liegen alle Farben an Blättern des Baums – das garantiert eindeutige Decodierbarkeit (Präfixfreiheit) ohne Trennzeichen. Bei Code B dagegen liegt Schwarz an einem inneren Knoten (Präfix von Violett) – das bedeutet, dass ohne zusätzliche Pausen/Trennzeichen bei bestimmten Bitfolgen nicht eindeutig zu erkennen ist, ob gerade „Schwarz" gemeint ist oder ob noch weitere Bits zu „Violett" gehören. Nur präfixfreie Codes (alle Farben an Blättern) benötigen keine Trennzeichen zwischen den Codewörtern.
Möchte man nun ein Bild auf einem Computer speichern, so wird für jedes einzelne Pixel „notiert", welche Farbe dieses besitzt. Das geschieht in der Regel durch eine Binärcodierung, also durch eine eindeutige Folge von Nullen und Einsen. Für das nebenstehende Bild wurde die folgende Codefolge als Standardcodierung festgelegt:
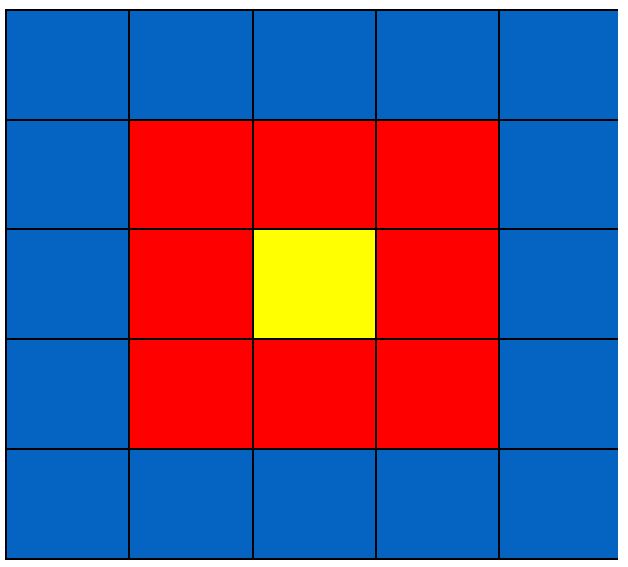
Wenn in einem Bild eine Farbe häufig direkt nacheinander vorkommt, kann man viel Speicher sparen: Man gibt einfach an, wie oft eine bestimmte Farbe hintereinander vorkommt. Diese Anzahl nennt man Lauflänge. Dann muss man nicht für jedes Pixel einzeln die Farbe notieren. Hierzu benötigt man neben der Codetabelle für die Farben noch eine Codetabelle für die Anzahl.
| Farbe | Code |
|---|---|
| Blau | 00 |
| Rot | 01 |
| Gelb | 10 |
| Lauflänge | Code |
|---|---|
| 1 | 00 |
| 2 | 01 |
| 3 | 10 |
| 6 | 11 |
Notiert man nun zuerst die Anzahl und dann den zugehörigen Farbwert, ergibt sich in Zeichenschreibweise zunächst die Codefolge 6b3r2b1r1g1r2b3r6b. Da die Lauflängen 4 und 5 nicht in der Tabelle vorkommen, muss man diese nicht codieren. Ersetzt man die Zeichen dann noch durch die zugehörigen Binärcodes, erhält man die finale Codefolge:
Zeichnet zwei 5×5-Bilder mit vier Farben (rot, grün, blau, orange). In einem Bild soll es viele Farbwechsel geben, beim anderen sollen die Farben jeweils häufig aufeinander folgen.
Macht die beiden Bilder bewusst zu Extremen: ein „Schachbrett-artiges" Bild mit Farbwechsel bei fast jedem Pixel, und ein Bild mit großen zusammenhängenden Farbflächen (z. B. Streifen oder Blöcke).
Gebt eine passende Codetabelle für die Farben an und notiert eine Standardcodierung für die beiden Bilder, analog zu oben, rechts neben dem Farbbild.
Bei 4 Farben braucht ihr mindestens 2 Bit pro Farbcode (2² = 4 Möglichkeiten), z. B. Rot=00, Grün=01, Blau=10, Orange=11.
Gebt eine Lauflängencodierung für die beiden Bilder an. Erstellt hierzu zunächst eine passende Tabelle für die Lauflängen.
Bei einem 5×5-Bild kann eine Lauflänge höchstens 25 betragen (falls das gesamte Bild eine Farbe hätte). Legt eure Lauflängen-Codetabelle so an, dass ihr alle in euren Bildern tatsächlich vorkommenden Lauflängen abdecken könnt (ggf. durch Zusammensetzen, siehe Hinweis oben).
Bestimmt für die Bilder jeweils die Codelänge bei der Standardcodierung aus Aufgabenteil b) und bei der Lauflängencodierung. Berechnet, um wie viel Prozent der Code kürzer (oder sogar länger) geworden ist.
Ersparnis in % = (Standardlänge − Lauflängen-Länge) / Standardlänge · 100. Ein negativer Wert bedeutet, dass die Lauflängencodierung hier sogar länger als die Standardcodierung geworden ist (kann beim „Schachbrett-Bild" passieren!).
(Zusatz) Bei der Datenübertragung eines binären Lauflängencodes wird ein einzelnes Bit falsch übertragen. Untersucht, welche Auswirkungen dies auf die Darstellung des Bildes hat. Welche Auswirkungen hat ein solcher Fehler bei einer Standardcodierung?
Überlegt: Wenn sich ein Bit in einem Lauflängen-Codewort ändert, ändert sich meist entweder die Farbe ODER die Anzahl eines ganzen Blocks. Wie wirkt sich das auf ALLE danach folgenden Pixel aus, wenn die "Anzahl" verändert wird?
Bei der Lauflängencodierung wird ein Bildcode bei geschickter Codierung kürzer. Da man keine Informationen über das Bild verliert, spricht man hier von einer verlustfreien Kompression. Bei „richtigen" Fotos auf dem Handy (jpg-Dateien) werden noch weitere Kompressionsverfahren verwendet, die zwar viel Speicher sparen, aber auch zu Informationsverlust führen. Solche Verfahren nennt man verlustbehaftet.
🎉 Alle Teilaufgaben bearbeitet!
a)-d) Beispiellösung (da die Bilder frei wählbar sind, hier ein durchgerechnetes Beispiel je Bildtyp mit Farbcode Rot=00, Grün=01, Blau=10, Orange=11 und Lauflängen-Code 1=00, 2=01, 3=10, 5=11):
| Bildtyp | Pixelfolge (Beispiel, zeilenweise) | Standardcodierung | Lauflängencodierung |
|---|---|---|---|
| Viele Farbwechsel (z. B. Schachbrettmuster Rot/Grün, 25 Pixel) | r,g,r,g,r, g,r,g,r,g, ... (durchgehend alternierend) | 25 Pixel · 2 Bit = 50 Bit | 25 Blöcke der Lauflänge 1 · (2+2) Bit = 100 Bit (doppelt so lang – hier lohnt sich Lauflängencodierung nicht!) |
| Wenige, lange Flächen (z. B. 3 Streifen: 10× Blau, 10× Orange, 5× Rot) | 10× b, 10× o, 5× r | 25 Pixel · 2 Bit = 50 Bit | 3 Blöcke: (5+5)+(5+5)+(3+2) Bit ≈ 25 Bit (Lauflänge 10 = 5+5 zusammengesetzt) → 50 % kürzer |
Ersparnis: Streifenbild: (50−25)/50 = 50 % kürzer. Schachbrett-Bild: (50−100)/50 = −100 %, also doppelt so lang wie die Standardcodierung.
e) Übertragungsfehler
Bei der Lauflängencodierung kann ein einzelnes gekipptes Bit gravierende Folgen haben: Betrifft der Fehler das Anzahl-Feld eines Codeworts, verschiebt sich die gesamte nachfolgende Zuordnung von Pixeln zu Farben – der Fehler "läuft" durch den gesamten Rest des Bildes und kann es komplett unbrauchbar machen (Fehlerfortpflanzung). Bei der Standardcodierung betrifft ein einzelnes falsches Bit dagegen nur genau einen Pixel – die Farbe dieses einen Pixels ändert sich möglicherweise, der Rest des Bildes bleibt aber korrekt. Die Standardcodierung ist also robuster gegenüber Übertragungsfehlern, während die Lauflängencodierung platzsparender, aber fehleranfälliger ist.
Betrachtet man die Tabelle für den Morsecode, sieht man, dass Buchstaben wie E und N sehr kurze Codes besitzen und das Q hingegen einen langen Code. Da bestimmte Buchstaben in unserer Sprache häufiger vorkommen als andere, kann man so beim Codieren viel Speicher (und Zeit) sparen. Eine solche Art der Codierung nennt man Entropiecodierung. Das gleiche Prinzip kann man auch bei anderen Anwendungen benutzen, z. B. beim Codieren von Bildern. Man zählt, wie häufig einzelne Farbwerte vorkommen, und weist ihnen dann einen passenden Code zu.
| Farbe | Anzahl | Code |
|---|---|---|
| Blau | 18 | 1 |
| Grün | 8 | 011 |
| Rot | 7 | 010 |
| Gelb | 4 | 001 |
| Rosa | 3 | 0001 |
| Schwarz | 2 | 0000 |
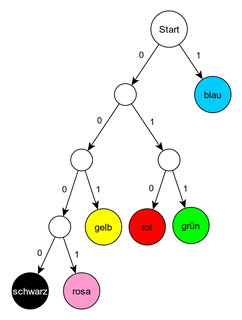
Beim Morsen muss man zwischen den einzelnen Buchstaben eine Pause machen, da man die Buchstaben sonst nicht unterscheiden kann. Ohne Pausen könnte die Codefolge „·· −·" ein F sein oder auch EAE bedeuten.
Stellt man eine Codetabelle „geschickt" auf, dann kann man auf diese Pausen verzichten. In der obenstehenden Codetabelle findet ihr einen Code, bei dem keine Pause bzw. kein Leerzeichen gemacht werden muss, da keine Verwechslungsgefahr besteht. Einen solchen Code nennt man präfixfrei. Neben der Tabelle ist der zugehörige Codebaum angegeben. Alle Codes stehen am Ende eines Pfades. Wenn das der Fall ist, dann ist der Code auf jeden Fall präfixfrei.
Zeichnet ein Bild der Größe 10 × 10 Pixel mit neun verschiedenen Farben.
Damit die späteren Aufgaben (c, d) einen sichtbaren Effekt zeigen, verteilt die Häufigkeiten der neun Farben bewusst ungleich – manche Farben sollen sehr oft, andere nur ein- oder zweimal vorkommen.
Erstellt eine Codetabelle, bei der jeder Farbcode die gleiche Länge besitzt. Gebt dann an, wie viele Bits für das gesamte Bild benötigt werden.
Für 9 Farben werden mindestens ⌈log₂(9)⌉ = 4 Bit pro Farbcode benötigt (mit 3 Bit wären nur 2³=8 Farben darstellbar).
Erstellt eine Codetabelle, bei der die Farben, die häufig vorkommen, einen kurzen Code bekommen. Farben, die selten vorkommen, erhalten dann einen längeren Code. Achtet darauf, dass euer Code präfixfrei ist. Zeichnet zur Überprüfung auch den zugehörigen Codebaum.
Platziert die häufigste Farbe möglichst nah an der Wurzel (kurzer Code), seltene Farben weiter unten im Baum. Achtet darauf, dass jede Farbe an einem Blatt landet (kein Codewort darf Präfix eines anderen sein).
Berechnet mit eurer Codetabelle zu c), wie viele Bits für das Codieren des gesamten Bildes notwendig sind. Vergleicht mit eurem Ergebnis aus b).
Da die Codewörter jetzt unterschiedlich lang sind, könnt ihr nicht mehr einfach "Bitlänge · 100" rechnen. Multipliziert stattdessen für jede Farbe einzeln (Häufigkeit · Codelänge dieser Farbe) und addiert alle neun Ergebnisse.
(Zusatz) Eine optimale Codierung bzgl. der Häufigkeiten der einzelnen Farben lässt sich systematisch durch das Erstellen eines Huffman-Baums erstellen. Betrachtet für eine Beschreibung des Verfahrens die beiden Videos:
Erstellt dann systematisch eine Codierung für die Farbwerte in der obigen Tabelle mithilfe eines Huffman-Baums. Vergleicht mit eurer Lösung zu c).
Verschmelzt schrittweise immer die beiden Farben/Knoten mit der aktuell geringsten Häufigkeit zu einem neuen Knoten (Summe der Häufigkeiten), bis nur noch ein Knoten (die Wurzel) übrig ist. Die Codewörter ergeben sich aus den Pfaden von der Wurzel zu den Blättern.
🎉 Alle Teilaufgaben bearbeitet!
b) Feste Codelänge
Für 9 Farben werden 4 Bit pro Farbe benötigt (2⁴=16 ≥ 9). Gesamtbedarf: 100 Pixel · 4 Bit = 400 Bit.
c)+d) Beispiellösung mit Huffman-Verfahren (da Farben/Häufigkeiten frei wählbar sind, hier ein durchgerechnetes Beispiel mit einer plausiblen Häufigkeitsverteilung für 100 Pixel):
| Farbe | Häufigkeit | Huffman-Code | Länge | Häufigkeit · Länge |
|---|---|---|---|---|
| Farbe 1 | 30 | 10 | 2 | 60 |
| Farbe 2 | 20 | 01 | 2 | 40 |
| Farbe 3 | 15 | 111 | 3 | 45 |
| Farbe 4 | 10 | 001 | 3 | 30 |
| Farbe 5 | 8 | 0000 | 4 | 32 |
| Farbe 6 | 6 | 0001 | 4 | 24 |
| Farbe 7 | 5 | 11001 | 5 | 25 |
| Farbe 8 | 4 | 110000 | 6 | 24 |
| Farbe 9 | 2 | 110001 | 6 | 12 |
| Summe | 292 Bit | |||
Vergleich: 400 Bit (feste Länge, b) vs. 292 Bit (präfixfreie/Huffman-Codierung, c/d) → Ersparnis von (400−292)/400 ≈ 27 %. Je ungleichmäßiger die tatsächliche Häufigkeitsverteilung in eurem eigenen Bild ist, desto größer fällt die Ersparnis gegenüber der festen Codelänge aus.
Farben werden technisch häufig durch zwei unterschiedliche Farbcodierungen beschrieben:
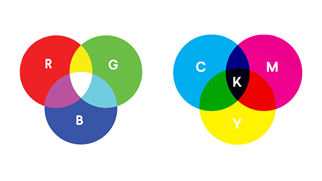
Subtraktive Farbmischung: Im Bereich der Drucktechnik benutzt man das Prinzip der subtraktiven Farbmischung. (Weißes Papier → Durch das mehrfache Auftragen von Farben wird es immer dunkler → Das entspricht einer Subtraktion von Licht.) Grundfarben sind hier Cyan (C), Magenta (M) und Gelb (Y). Häufig nimmt man reines Schwarz (K) mit hinzu. Dann spricht man von CMYK. Die Farben sind z. B. von Druckerpatronen oder Tonerkartuschen bekannt.
Additive Farbmischung: Bei selbst leuchtenden Medien, wie z. B. Monitoren, Fernsehern oder Displays, verwendet man das Prinzip der additiven Farbmischung. (Dunkler Bildschirm → Durch das Mischen von Lichtpunkten (Pixeln), die sich optisch überlagern, wird das Bild immer heller → Das entspricht einer Addition von Licht.) Als Grundfarben verwendet man hier Rot (R), Grün (G) und Blau (B). Man spricht daher auch von einer RGB-Farbdarstellung.
Stellt man die additive (links) und die subtraktive (rechts) Farbmischung in einem Farbkreis dar, so muss man beachten, dass sich die Farben völlig unterschiedlich „mischen". Es wird durch das Mischen die Helligkeit erhöht, oder es reduziert sich die Helligkeit:
Das Farbschema RGB entspricht unserem natürlichen Sehen. Das menschliche Auge besitzt für das Farbsehen drei verschiedene Zapfensorten, die auf unterschiedliche Farbbereiche reagieren und zusammen einen Farbeindruck erzeugen. Da diese Werte erst noch durch das Gehirn interpretiert werden, ist das Farbensehen sehr subjektiv.
Informiert euch hierzu im folgenden Video (bis zum Ende anschauen!):
In der Computertechnik werden Farbwerte der Grundfarben (RGB) häufig in einer 8-Bit-Codierung gespeichert. Das heißt, dass die einzelnen Grundfarben 28 = 256 mögliche Werte besitzen, von 0 bis 255. Bei 0 ist die Grundfarbe nicht vertreten. Bei 255 ist die Grundfarbe maximal hinzugefügt. Das kann man beispielhaft wie folgt interpretieren:
| Grundfarbe | Rot | Grün | Blau | |
|---|---|---|---|---|
| Sättigung | Prozent | 54,5 | 4,3 | 98,0 |
| Binär | 10001011 | 00001011 | 11111010 | |
| Dezimal | 139 | 11 | 250 | |
Die Farbe in der Tabelle wird als 10001011 00001011 11111010 im Computer gespeichert. Als Dezimalfarbwerte erhält man Rot: 139, Grün: 11, Blau: 250. Das ist etwas Rot, nahezu kein Grün, viel Blau. Mischt man die Farben, ergibt sich Violett.
Achtet besonders darauf, wie die drei Zapfentypen des Auges (kurzwellig/mittelwellig/langwellig) mit den Grundfarben Blau, Grün und Rot zusammenhängen.
Vervollständigt die folgende Tabelle mithilfe des RGB-Farbmischers (Hilfe: informatik.schule.de/rgb/RGB_farbmischer.html – oder nutzt den Mischer unten direkt):
| Rot | Grün | Blau | Farbton |
|---|---|---|---|
Stellt die Regler auf die jeweils gegebenen Werte ein und lest den entstehenden Farbnamen aus der Vorschau ab. Für Zeile 3 und 4 probiert Werte aus, bis die Vorschau „orange" bzw. „gelb" ergibt.
Wie viele verschiedene Farben/Farbtöne kann das menschliche Auge unterscheiden?
Sucht nach „Anzahl unterscheidbarer Farben menschliches Auge" – die üblicherweise genannten Schätzwerte liegen zwischen etwa 1 und 10 Millionen, abhängig von Studie und Messmethode.
Wie viele Farben gibt es bei einer RGB-Farbcodierung, bei der jede Grundfarbe mit 8 Bit gespeichert wird?
Rechnet 2⁸ · 2⁸ · 2⁸ = 2²⁴.
🎉 Alle Teilaufgaben bearbeitet!
b) Rot=255,Grün=0,Blau=255 → Magenta/Pink. Rot=123,Grün=78,Blau=120 → ein gedämpftes Violett/Mauve. Für „orange" passen z. B. Rot=255,Grün=140,Blau=0. Für „gelb" passen z. B. Rot=255,Grün=255,Blau=0.
c) Häufig genannte Schätzwerte liegen zwischen etwa 1 und 10 Millionen unterscheidbaren Farbtönen (die genaue Zahl variiert je nach Studie/Messmethode und individueller Wahrnehmung).
d) 28 · 28 · 28 = 224 = 16.777.216 Farben.
Interessanter Vergleich: Die theoretisch mit 24-Bit-RGB darstellbare Farbanzahl (16,7 Mio.) übersteigt die vom menschlichen Auge tatsächlich unterscheidbare Anzahl (c) bereits deutlich – 24-Bit-Farbtiefe wird daher oft als „True Color" bezeichnet, da für das menschliche Auge kein sichtbarer Gewinn durch noch mehr Farbabstufungen entsteht.
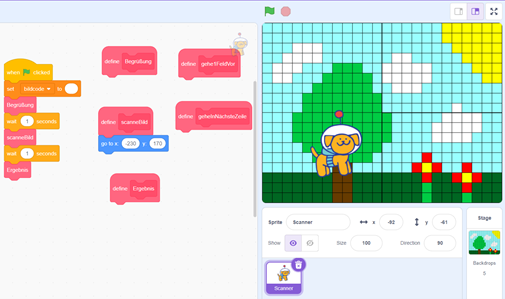
Wählt eine der beiden Varianten:
Öffne die folgende Scratch-Datei über diesen Link.
Analysiert die Funktionsweise des Programms.
Klickt die einzelnen Skript-Blöcke des Programms nacheinander an (oder führt sie in Einzelschritten aus) und notiert euch stichpunktartig, was jeder Block bewirkt.
Gebt an, was das Programm tut.
Versucht, die Funktion des Programms in einem einzigen, knappen Satz zusammenzufassen, bevor ihr ins Detail geht (z. B. „Das Programm scannt ein Bild Pixel für Pixel und wandelt es in einen Farbcode um").
Erläutert die einzelnen Komponenten des Programms.
Achtet auf typische Bausteine: Variablen (z. B. für den codierten Text), Schleifen (zum Durchlaufen der Pixel/Zeilen), Bewegungsblöcke (zum "Scannen") und Farbabfrage-Blöcke (zum Auslesen der Pixelfarbe).
🎉 Alle Teilaufgaben bearbeitet!
Da der genaue Aufbau von BildscannerV1Standard.sb3 vom Inhalt der Scratch-Datei abhängt, hier eine allgemeine Musterlösung, wie ein solches Programm typischerweise funktioniert:
a)+b) Funktionsweise/Zweck: Der „Scanner" (eine Scratch-Figur) startet oben links auf dem Bild und bewegt sich pixelweise (in Schritten von 20, dem Pixelabstand) von links nach rechts. Bei jedem Pixel liest er per Farbabfrage die aktuelle Farbe unter der Figur aus und hängt den passenden Buchstaben-Code an die Variable bildcode an. Am Ende einer Zeile springt der Scanner in die nächste Zeile zurück zum linken Rand. Nach dem vollständigen Durchlauf enthält bildcode die codierte Darstellung des gesamten Bildes und wird ausgegeben.
c) Typische Komponenten:
- Variable
bildcode: speichert den wachsenden codierten Text. - Bewegungsblöcke: „gehe 20er-Schritte" und „springe zur nächsten Zeile" positionieren den Scanner über jedem Pixel.
- Farbabfrage („berührt Farbe...?" bzw. Pixelfarbe auslesen): bestimmt, welche Farbe gerade gescannt wird.
- Verzweigungen (falls/sonst): ordnen der erkannten Farbe den richtigen Buchstaben-Code zu.
- Wiederholungsschleife: läuft so lange, bis alle Pixel des Bildes gescannt wurden.
Öffne die folgende Scratch-Datei über diesen Link.
Analysiert die Funktionsweise des Programms.
Klickt die einzelnen Skript-Blöcke des Programms nacheinander an (oder führt sie in Einzelschritten aus) und notiert euch stichpunktartig, was jeder Block bewirkt.
Erweitert das Programm derart, dass eine Lauflängencodierung so durchgeführt wird, dass nicht z. B. rrrrrrrrrr, sondern 10r gespeichert wird.
Führt zwei neue Variablen ein:
aktuelleFarbe (merkt sich die zuletzt gescannte Farbe) und zaehler (zählt, wie oft diese Farbe bereits in Folge aufgetreten ist).Bei jedem neuen Pixel: Ist die Farbe gleich wie
aktuelleFarbe? Dann erhöht zaehler um 1. Ändert sich die Farbe (oder das Bild ist zu Ende), hängt zunächst den aktuellen zaehler-Wert und den Farbcode an bildcode an, setzt zaehler auf 1 zurück und aktualisiert aktuelleFarbe.🎉 Alle Teilaufgaben bearbeitet!
a) Funktionsweise: siehe Musterlösung der Standardvariante – die Grundstruktur (Scanner bewegt sich pixelweise, liest Farben aus) ist identisch.
b) Pseudocode für die Lauflängen-Erweiterung:
setze bildcode = ""
setze aktuelleFarbe = (Farbe des ersten Pixels)
setze zaehler = 1

für jedes weitere Pixel (in Scan-Reihenfolge):
    wenn Farbe des Pixels = aktuelleFarbe:
        zaehler = zaehler + 1
    sonst:
        bildcode = bildcode + zaehler + farbCode(aktuelleFarbe)
        aktuelleFarbe = Farbe des Pixels
        zaehler = 1

// nach der Schleife: letzten Block nicht vergessen!
bildcode = bildcode + zaehler + farbCode(aktuelleFarbe)

sage bildcode
Wichtiger Stolperstein: Der letzte Lauflängen-Block muss nach Ende der Schleife noch einmal separat an bildcode angehängt werden, da er beim letzten Pixel nicht mehr durch einen Farbwechsel „ausgelöst" wird.