Codierungstheorie

Die vorliegenden Materialien wurden von Daniel Hoherz und André Tempel erstellt. Sollten andere Editoren die Materialien erstellt haben, werden diese explizit genannt.
Wiederholung: Codierungstheorie
Im vorangegangenen Schuljahr haben Sie bereits eine Einführung in die Codierungstheorie erhalten. Am Beispiel von drei verschiedenen Codierungen wurden Vor- und Nachteile der untersuchten Codierungen erarbeitet.
Morse-Code
- + Mittlere Codewortlänge = 3,71
- - Nicht eindeutig dekodierbar, da es Codewörter gibt, die Anfangs- oder Endstücke anderer Codewörter sind.
- - Übertragungsfehler werden nicht sicher erkannt
- + Informationsrate 100%
ASCII-Code
- - Mittlere Codewortlänge = 8
- + Eindeutig von links und rechts dekodierbar (präfixfrei und suffixfrei)
- - Übertragungsfehler werden nicht sicher erkannt
- + Informationsrate 100%
3Bit-Code
- + Mittlere Codewortlänge = 3
- + Durch das Prüfbit wird zumindest ein Übertragungsfehler sicher erkannt. Eine Fehlerkorrektur ist nicht möglich und zwei oder mehr Übertragungsfehler werden nicht erkannt.
- - Nur zwei Drittel des gesendeten Codes enthalten Informationen. Ein Drittel ist Redundanz (zusätzliche Daten, die keine Informationen beinhalten) → Informationsrate ca. 66,67%.
Ziele / Wünsche an eine „gute“ Codierung:
- Schnelle Übertragbarkeit, also möglichst kleine mittlere Codewortlänge
- Eindeutige Dekodierbarkeit, also möglichst präfix- oder suffixfrei
- Hohe Informationsrate
- Erkennen von Übertragungsfehlern
- Korrigieren von Übertragungsfehlern
Fehlererkennung und Fehlerkorrektur stehen also im Widerspruch zur schnellen Übertragung.
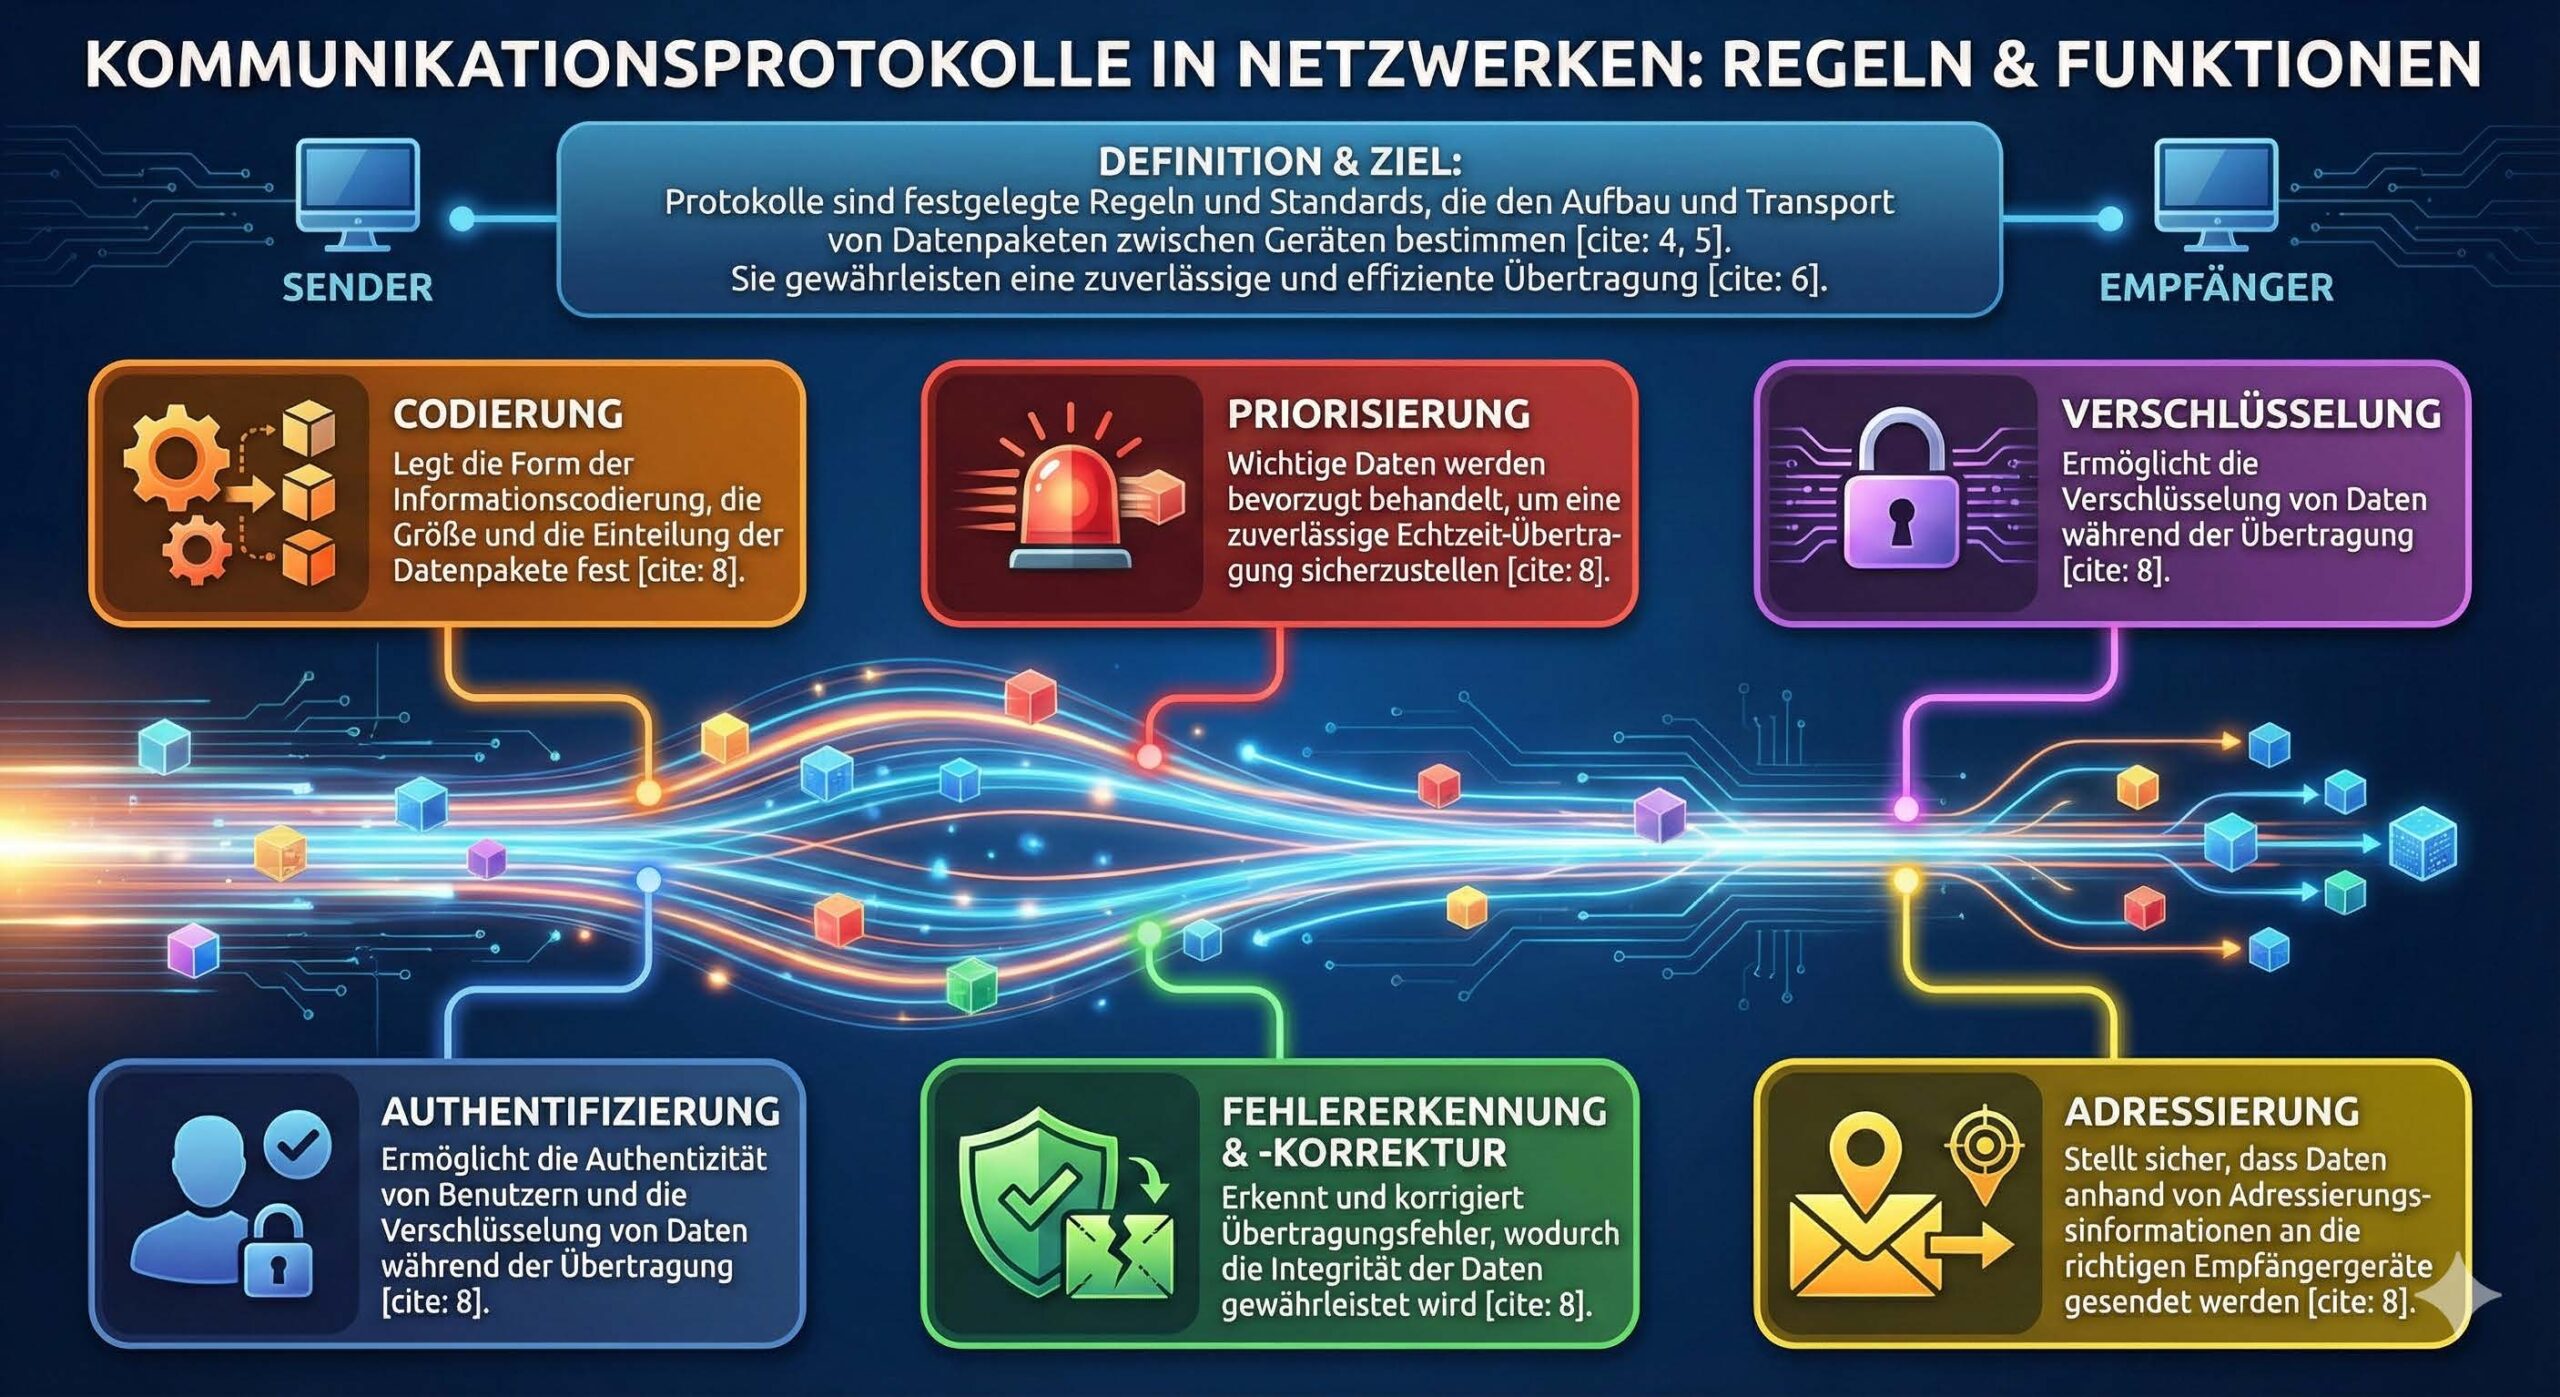
Der Betreiber eines privaten Onlinemarktplatzes bietet eine Schnittstelle zur automatisierten Abfrage von anonymisierten Kaufbewertungen an. Die genaue Art der Kommunikation zwischen einem Client und dem Server des Onlinemarktplatzes hat er dabei in einem Kommunikationsprotokoll EvaluationAnalytics konkret festgelegt. So gibt dieses als einen Aspekt beispielsweise vor, welche Adressierung eine Anfrage an den Server haben sein muss.
Erstellt eine kurze Präsentation, in welcher ihr
- anhand der drei in Jahrgang 11 untersuchten Codierungen gewünschte Eigenschaften einer guten Codierung deutlich macht.
- zwei weitere Aspekte, die ein solches Protokoll vorgeben könnte, beschreibt.
- die Auswirkungen des Ausfalls eines Clients mit denen bei einem Ausfall des Servers vergleicht.
Was ist eine Codierung?
Eine Codierung ist mathematisch wie folgt definiert. Sei \(A\) ein endliches Alphabet aus bestimmten Zeichen und \(B\) ein weiteres endliches Alphabet aus bestimmten Zeichen. Die Zeichen von \(A\) und \(B\) können aber müssen nicht verschieden sein. Dann ist eine Codierung eine Abbildung, die jedem Zeichen aus \(A\) ein Zeichen aus \(B\) zuordnet… Puh, das liest sich aber kompliziert. Schauen wir uns vielleicht ein bekanntes Beispiel an.
Beispiele:
\(a \rightarrow \cdot-\) und \(8 \rightarrow ---\cdot\cdot\)
Alle Wörter, die sich aus der Abbildung ergeben, heißen Codewörter.
Seien \(A\) und \(B\) endliche Alphabete. Eine Abbildung \(\varphi : A \rightarrow B\), die jedem Zeichen aus \(A\) ein eindeutiges Zeichen aus \(B\) zuordnet, heißt eine Codierung.
Die Elemente der Menge \(\varphi(A)\), der durch die Abbildung \(\varphi\) erzeugten Wörter, nennt man Codewörter.
Wir haben bereits festgestellt, dass man einerseits eine möglichst kurze Codierung möchte. Auf der anderen Seite möchte man jedoch, dass möglichst viele Übertragungsfehler erkannt und korrigiert werden. Diese beiden Ziele widersprechen sich, da man für eine Fehlererkennung und Fehlerkorrektur eine Codierung mit Redundanzen versehen muss, was jedoch sicher die mittlere Codewortlänge erhöht.
Von Situation zu Situation möchte man jedoch den einen Aspekt stärke in einer Codierung haben als den anderen. Deshalb betrachten wir zunächst beide Ziele getrennt voneinander.
Wiederholung: Kommunikationsprotokolle
Informationen jeglicher Art werden ständig von einem Sender über einen Kommunikationskanal verschickt und von einem Empfänger erhalten. An ein Kommunikationsprotokoll werden verschiedene Anforderungen gestellt. Anhand des Beispiels mit der Flaggenkommunikation haben wir in den vorherigen Schuljahren die folgenden Aspekte eines Kommunikationsprotokolls identifiziert.
Kompressionsverfahren
Bei Kompressionsverfahren geht es darum, die vorhandenen Informationen zu 100% zu erhalten und trotzdem den Speicheraufwand zu verringern. Dies nennt man verlustfreie Kompression.
Grundlage: Das RGB-Farbmodell
Das RGB-Farbmodell ist ein additives Farbmodell, bei welchem eine Farbe durch die Angabe des Rot-, Grün- und Blauanteils definiert wird.
Man kann sich diese Farbmischung so vorstellen, als würden je eine Lichtquelle mit rotem, grünem und blauem Licht auf einen Punkt scheinen. Das Licht auf dem Punkt ist dann eine Mischung aus den drei Farben. Die Intensität der jeweiligen Farbe ist umso stärke, je stärke die jeweilige Lichtquelle strahlt.
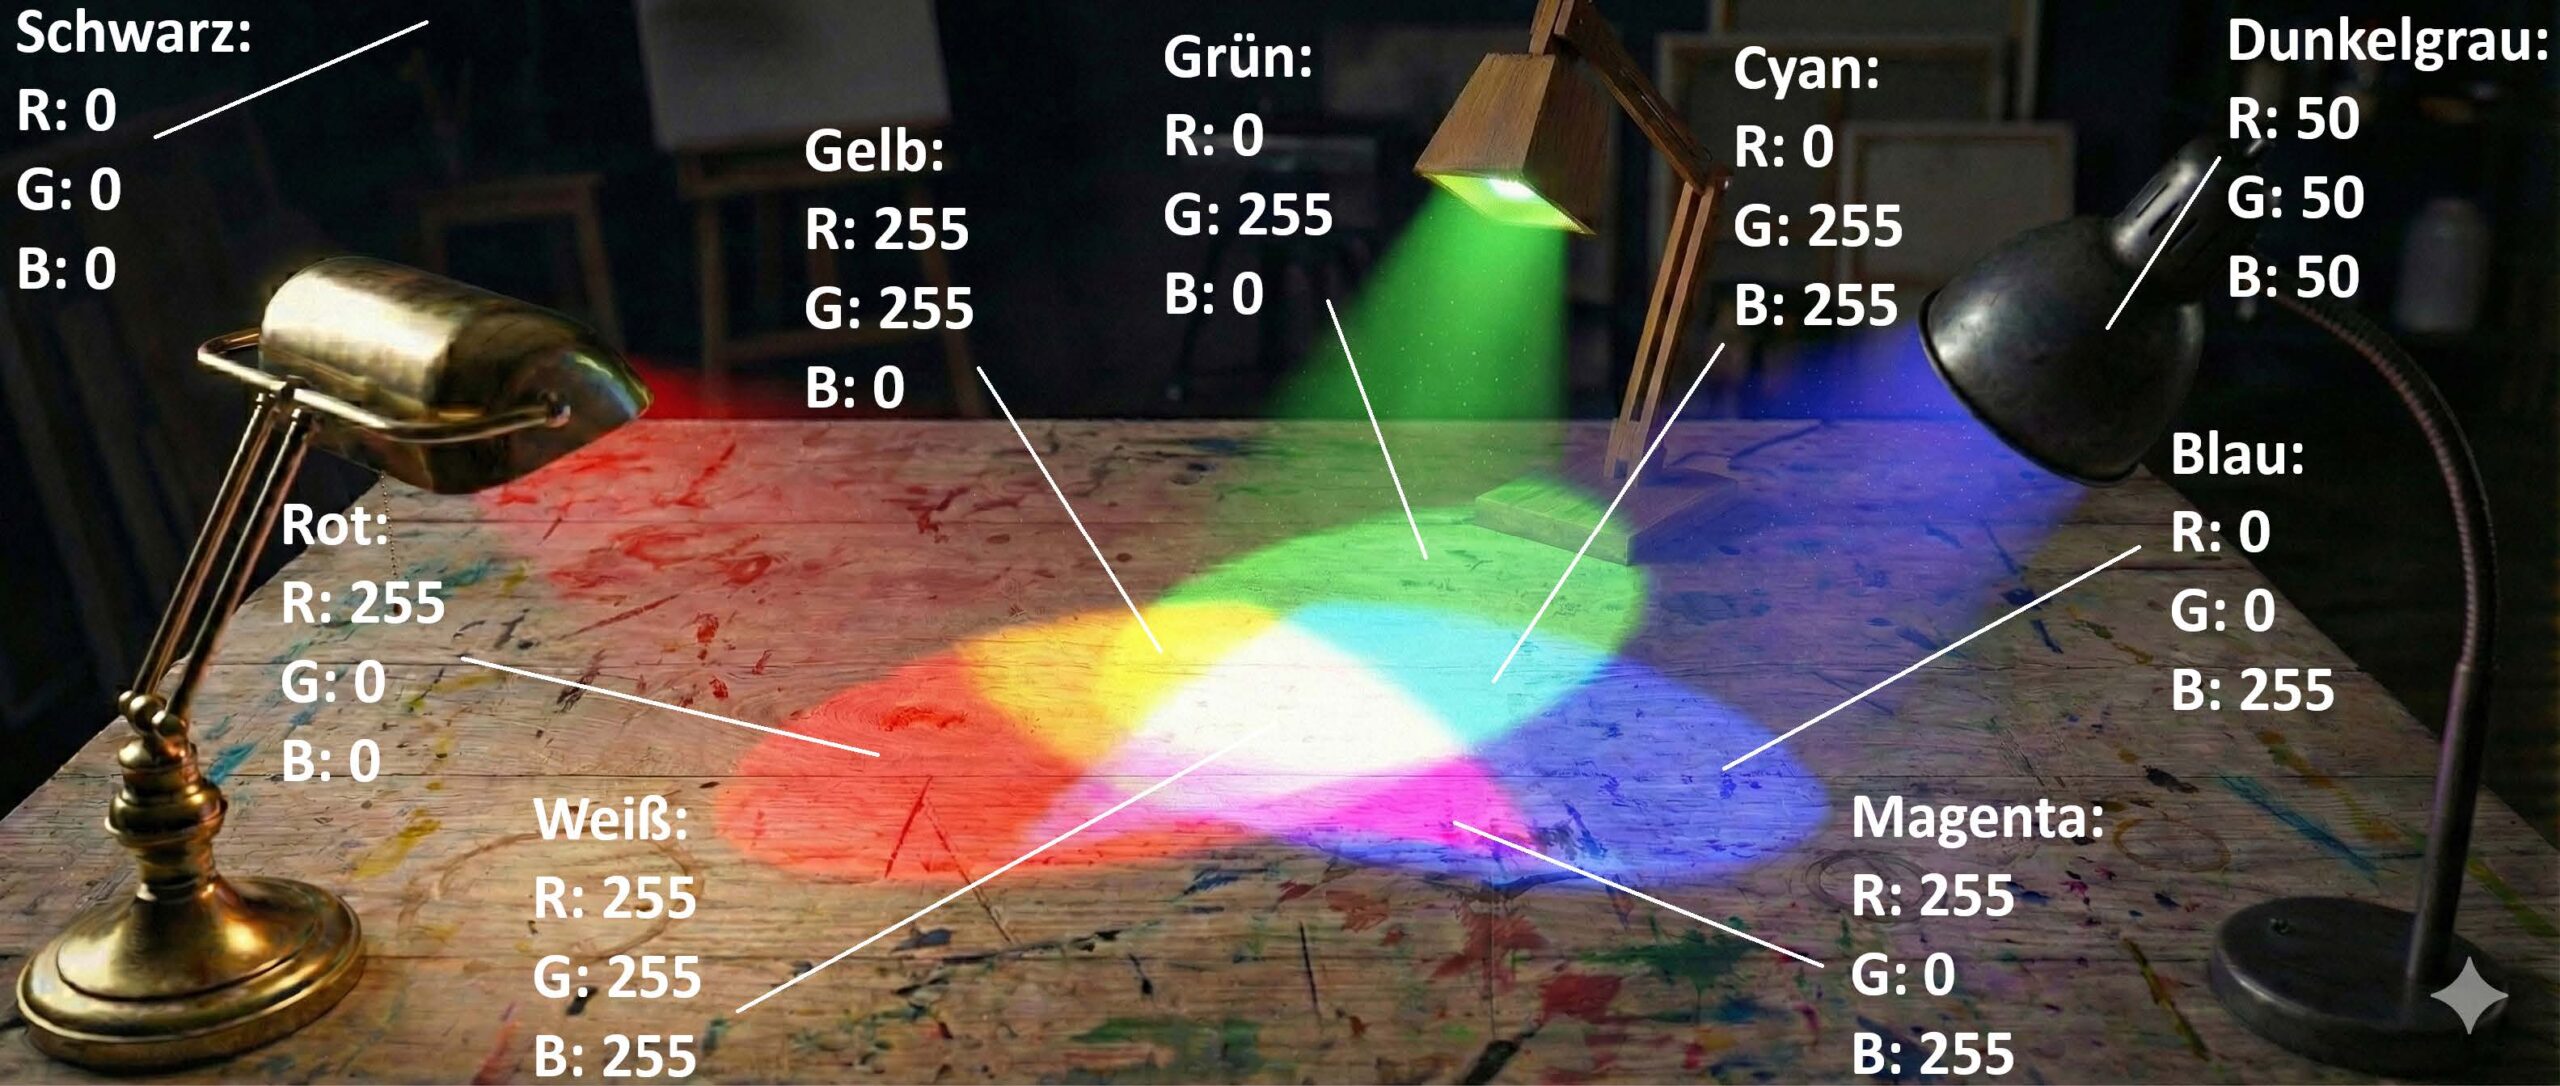
Überschneiden sich zwei Lichtkreise, so entstehen die Sekundärfarben Gelb, Magenta und Cyan. In der Mitte überschneiden sich alle drei Lichtkreise, wobei die Mischung Weiß erscheint. Die Farbe Schwarz wird durch die Dunkelheit (kein Licht) im umgebenden Raum dargestellt.
Die Farbanteile \((r, g, b)\) werden dabei in Zahlen von 0 bis 255 codiert. So ergeben sich \(256 \cdot 256 \cdot 256 = 2^8 \cdot 2^8 \cdot 2^8 = 2^{24} = 16.777.216\) verschiedene Farben.
Für jeden Farbanteil werden aufgrund der \(256 = 2^8\) Möglichkeiten 8 Bit, also ein Byte, Speicher benötigt. Da es drei Farbanteile sind, benötigt ein gespeichertes Pixel eines Bildes somit \(3 \cdot 8 = 24\text{ Bit}\), oder 3 Byte.
Beispiele für die binäre Darstellung einiger Farben:
Nach einem besonderen Urlaub in der Karibik habt ihr sehr schöne Urlaubsfotos, die sich in euren Social-Media-Accounts sehr gut machen würden.
Die Kamera eines modernen Smartphones hat typischerweise 12 Megapixel, also 12 Millionen Pixel. Angenommen, das obere Foto wurde mit einer solchen Kamera aufgenommen.
Wenn es im RGB-Format gespeichert oder versendet werden soll, würde jeder Pixel 3 Byte Speicherplatz beanspruchen. Das gesamte Bild wäre dann 36 Millionen Byte groß. Das sind 36 Megabyte.
Wenn man ein Foto im Speicher des Smartphones oder einer Cloud betrachtet, hat es 2–3 Megabyte. Das Bild kann demnach nicht im RGB-Format abgespeichert worden sein.
Es wurde ein Kompressionsverfahren genutzt. Ein solches Verfahren reduziert die Größe einer Datei. Bei verlustfreien Kompressionsverfahren wird die Datenmenge reduziert und man verliert keine Informationen. Bei verlustbehafteten Kompressionsverfahren wird die Datenmenge reduziert, aber man verliert einen Teil der ursprünglichen Informationen.
Für beides kennen Sie bereits Beispiele:
Verlustfreies Kompressionsverfahren
Lauflängencodierung bei Schwarz-Weiß- und Graubildern: Alle Informationen der einzelnen Pixel werden beibehalten. Kein Informationsverlust.
Verlustbehaftetes Kompressionsverfahren
Jeweils vier Pixel zu einem mit „gemittelter“ Farbe zusammenfassen. Die komprimierte Datei ist nur noch 25% so groß wie die ursprüngliche. Allerdings verliert man die Informationen der vier ursprünglichen Pixel.
Bevor wir uns mit einem weiteren Bildkompressionsverfahren befassen, betrachten wir zunächst ein verlustfreies Kompressionsverfahren für Texte. Wenn wir das Verfahren verstanden haben, kommen wir wieder zu den Bildern zurück.
Die Huffmancodierung
Die Huffmancodierung ist ein Kompressionsverfahren, welches einen verlustfreien präfixfreien Code mit minimaler mittlerer Codewortlänge liefert. Solch eine Codierung bezeichnet man als optimal. Außerdem ist eine mit der Huffmancodierung codierte Nachricht präfixfrei, also von links eindeutig decodierbar.
Genutzt wird der Huffman-Code bei z. B. MPEG, JPG, MP3 und ZIP.
Die Idee dahinter ist ähnlich dem Morse-Code: Häufig genutzte Zeichen erhalten eine kürzere Codierung als weniger genutzte Zeichen.
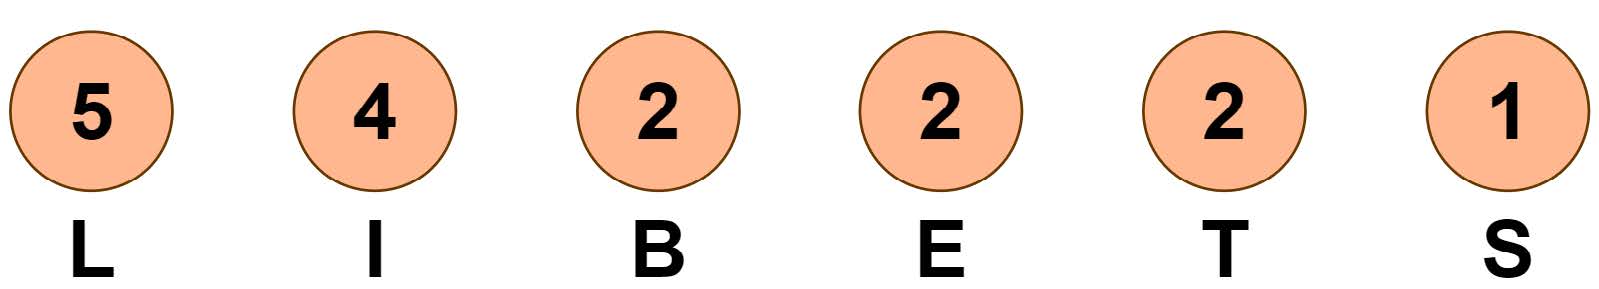
Beispiel: Es soll der Text "TILL LIEBT SIBILLE" codiert werden.
Es wird die Häufigkeit eines jeden Zeichens im zu codierenden Text gezählt. Für jedes Zeichen wird ein Knoten erzeugt und mit der entsprechenden Häufigkeit gewichtet. Die Knoten werden absteigend sortiert:
Die beiden Knoten am weitesten rechts werden mit einem weiteren Knoten verbunden.
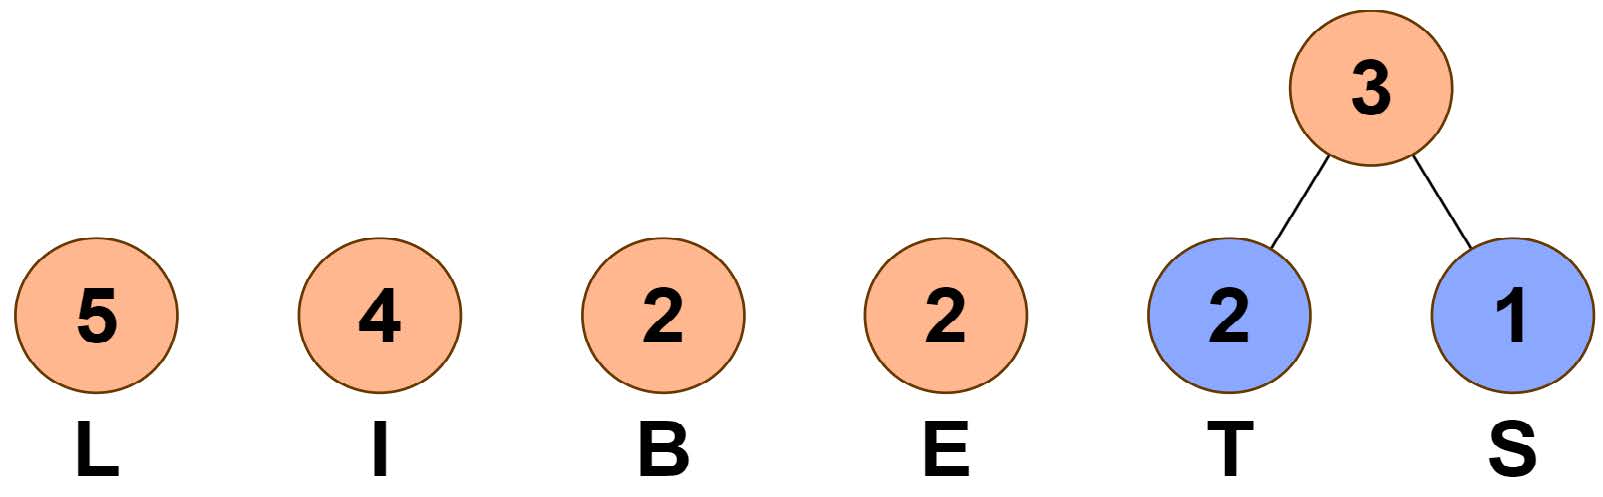
Der neu entstandene Knoten bildet nun die sogenannte Wurzel einer Baumstruktur. Diese wird nun wieder in absteigender Reihenfolge einsortiert. Die Wurzeln, nach deren Inhalten sortiert wird, werden nun immer orange dargestellt.
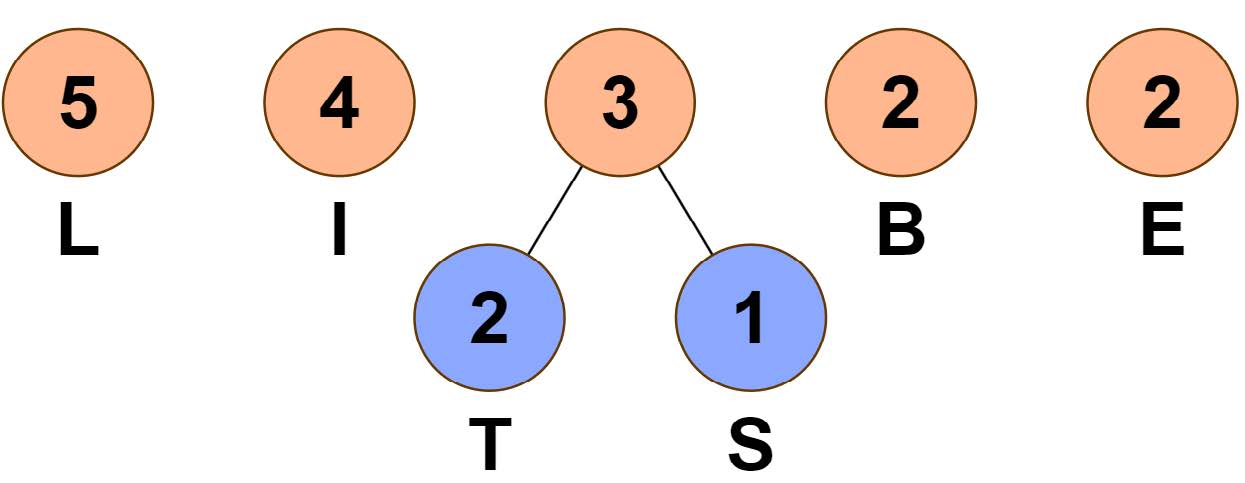
Die Schritte 2 und 3 werden so lange wiederholt, bis es nur noch eine Wurzel gibt.
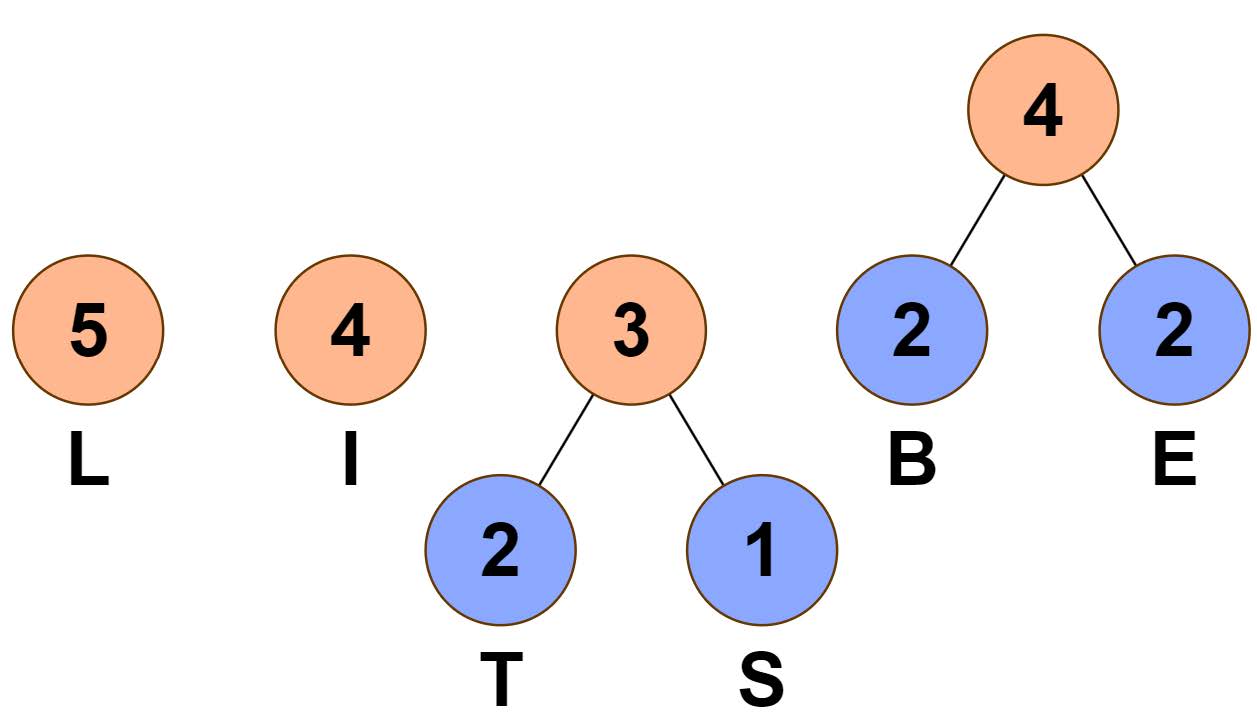
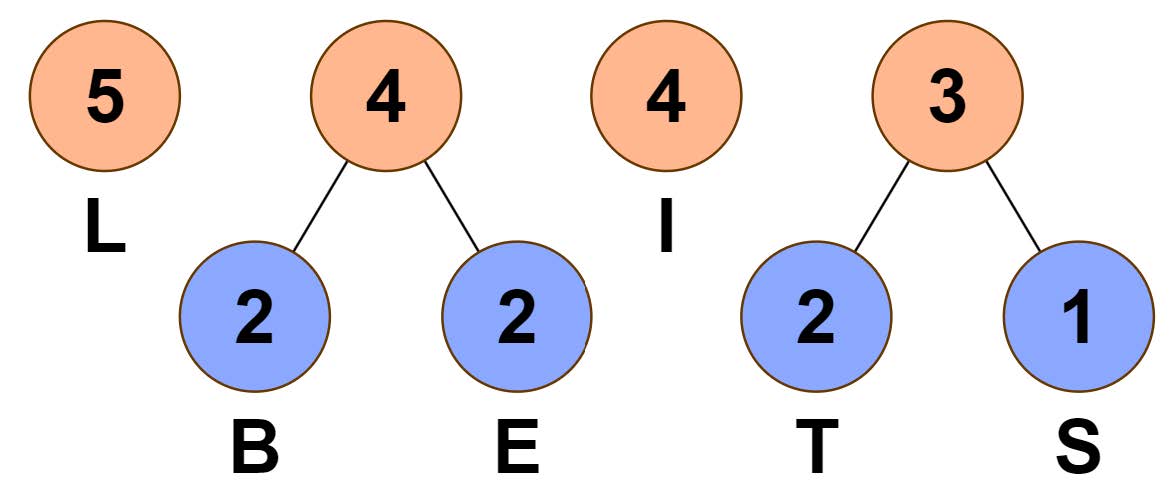
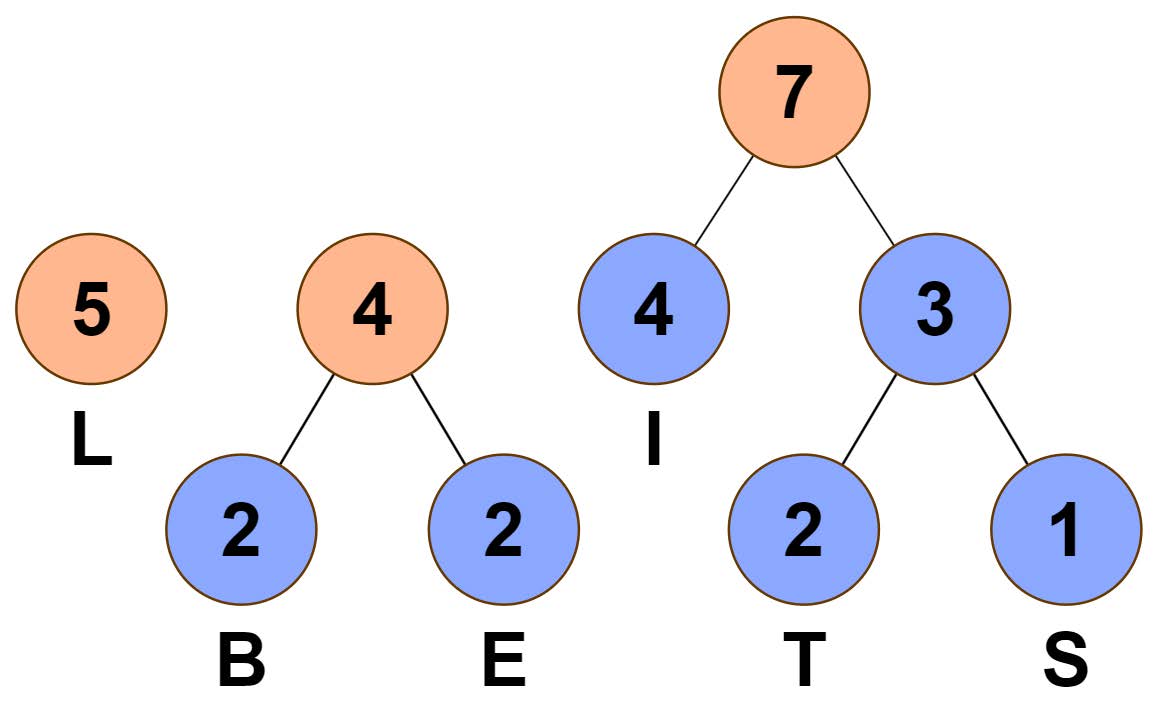
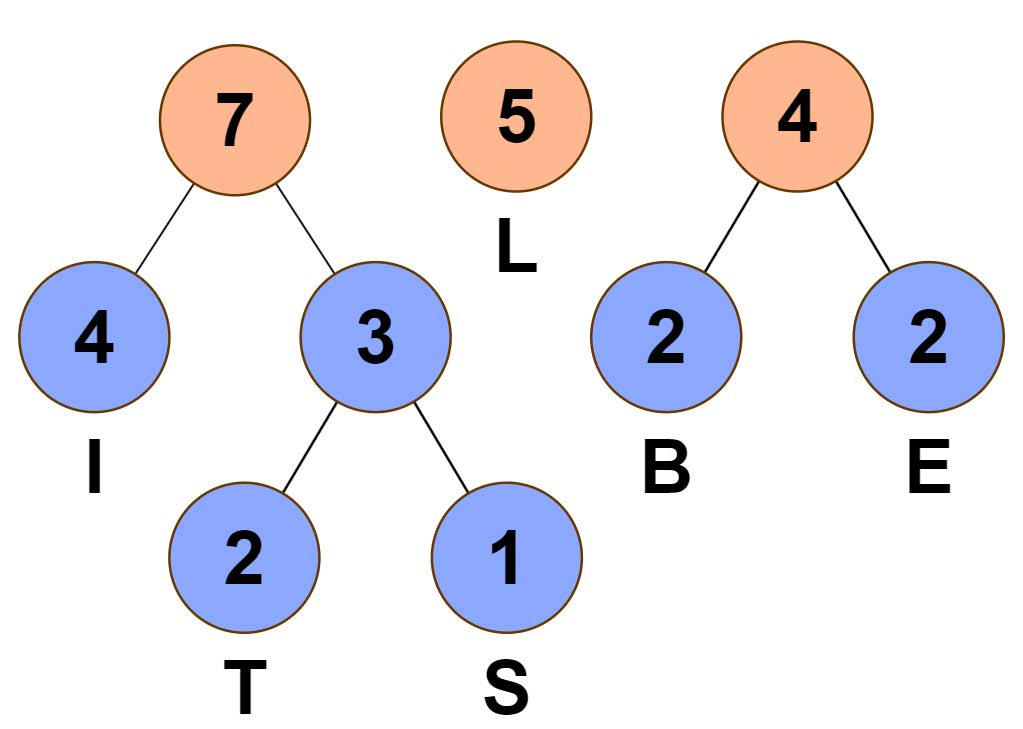
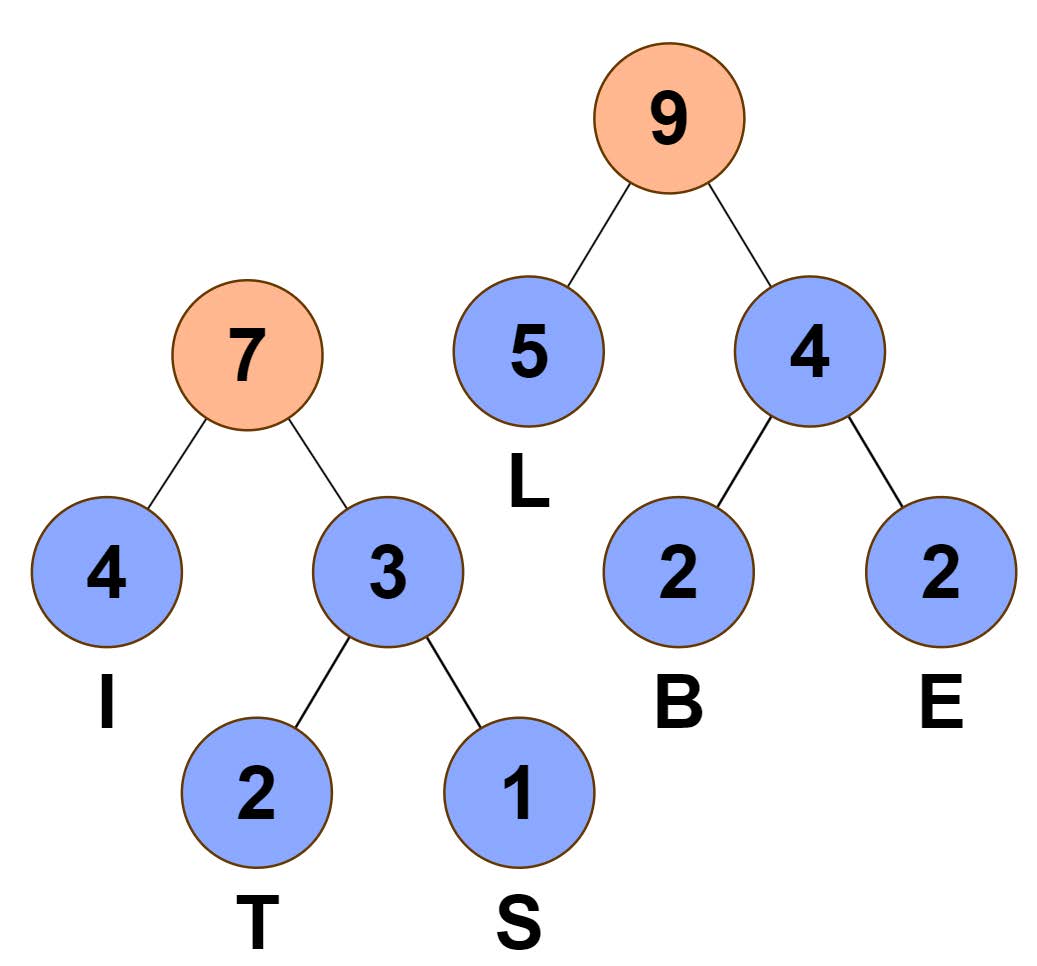
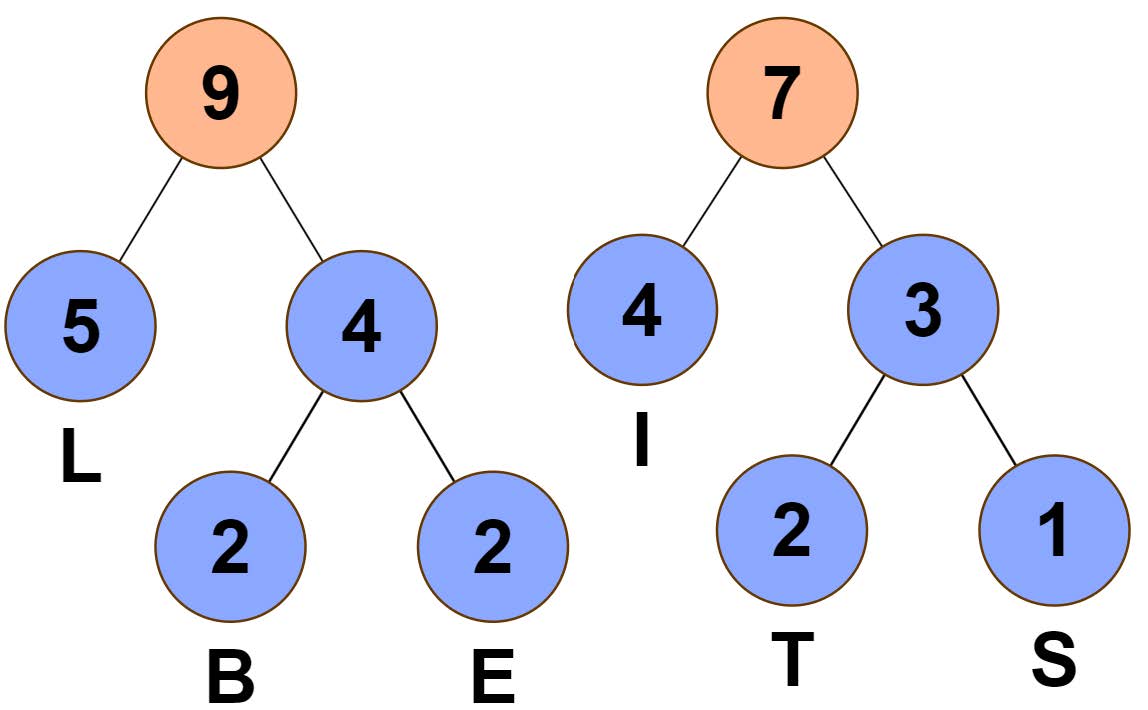
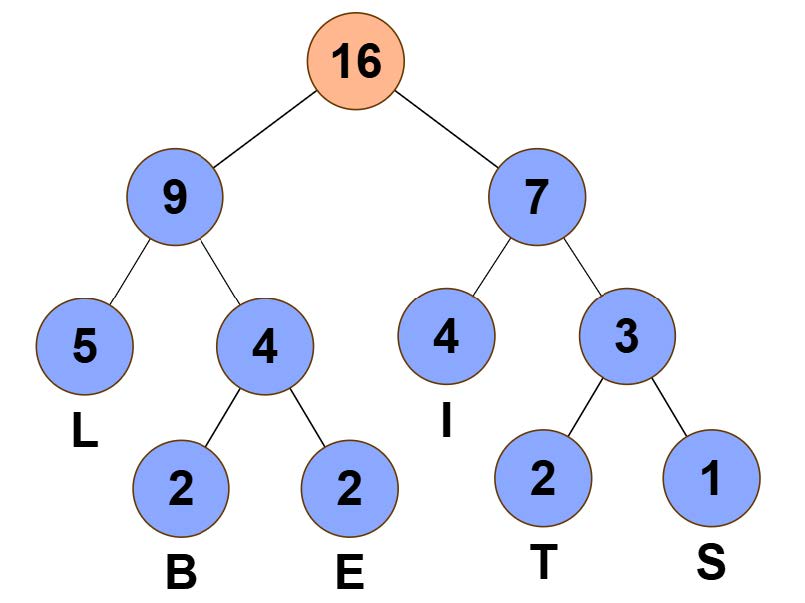
Gibt es mehrere Bäume mit gleichem Wurzelinhalt und gleicher Höhe, kann man diese gleichwertig betrachten. Bei diesen ist es egal, welcher links und welcher rechts steht.
Jetzt gibt es zwei Möglichkeiten. Entweder schreibt man an alle Kanten des Baumes, die nach links abgehen, eine 0 und an alle, die nach rechts abgehen, eine 1 oder andersherum. Wichtig ist nur, dass man dies konsistent macht.
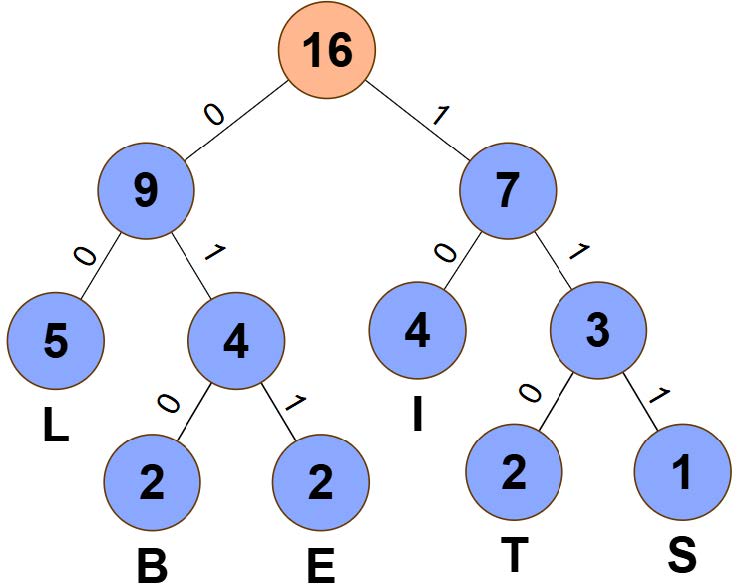
Die Codierung der Zeichen wird nun von oben am Baum abgelesen. Liest man nicht von oben ab, ist der Code nicht präfixfrei.
Hamming-Abstand
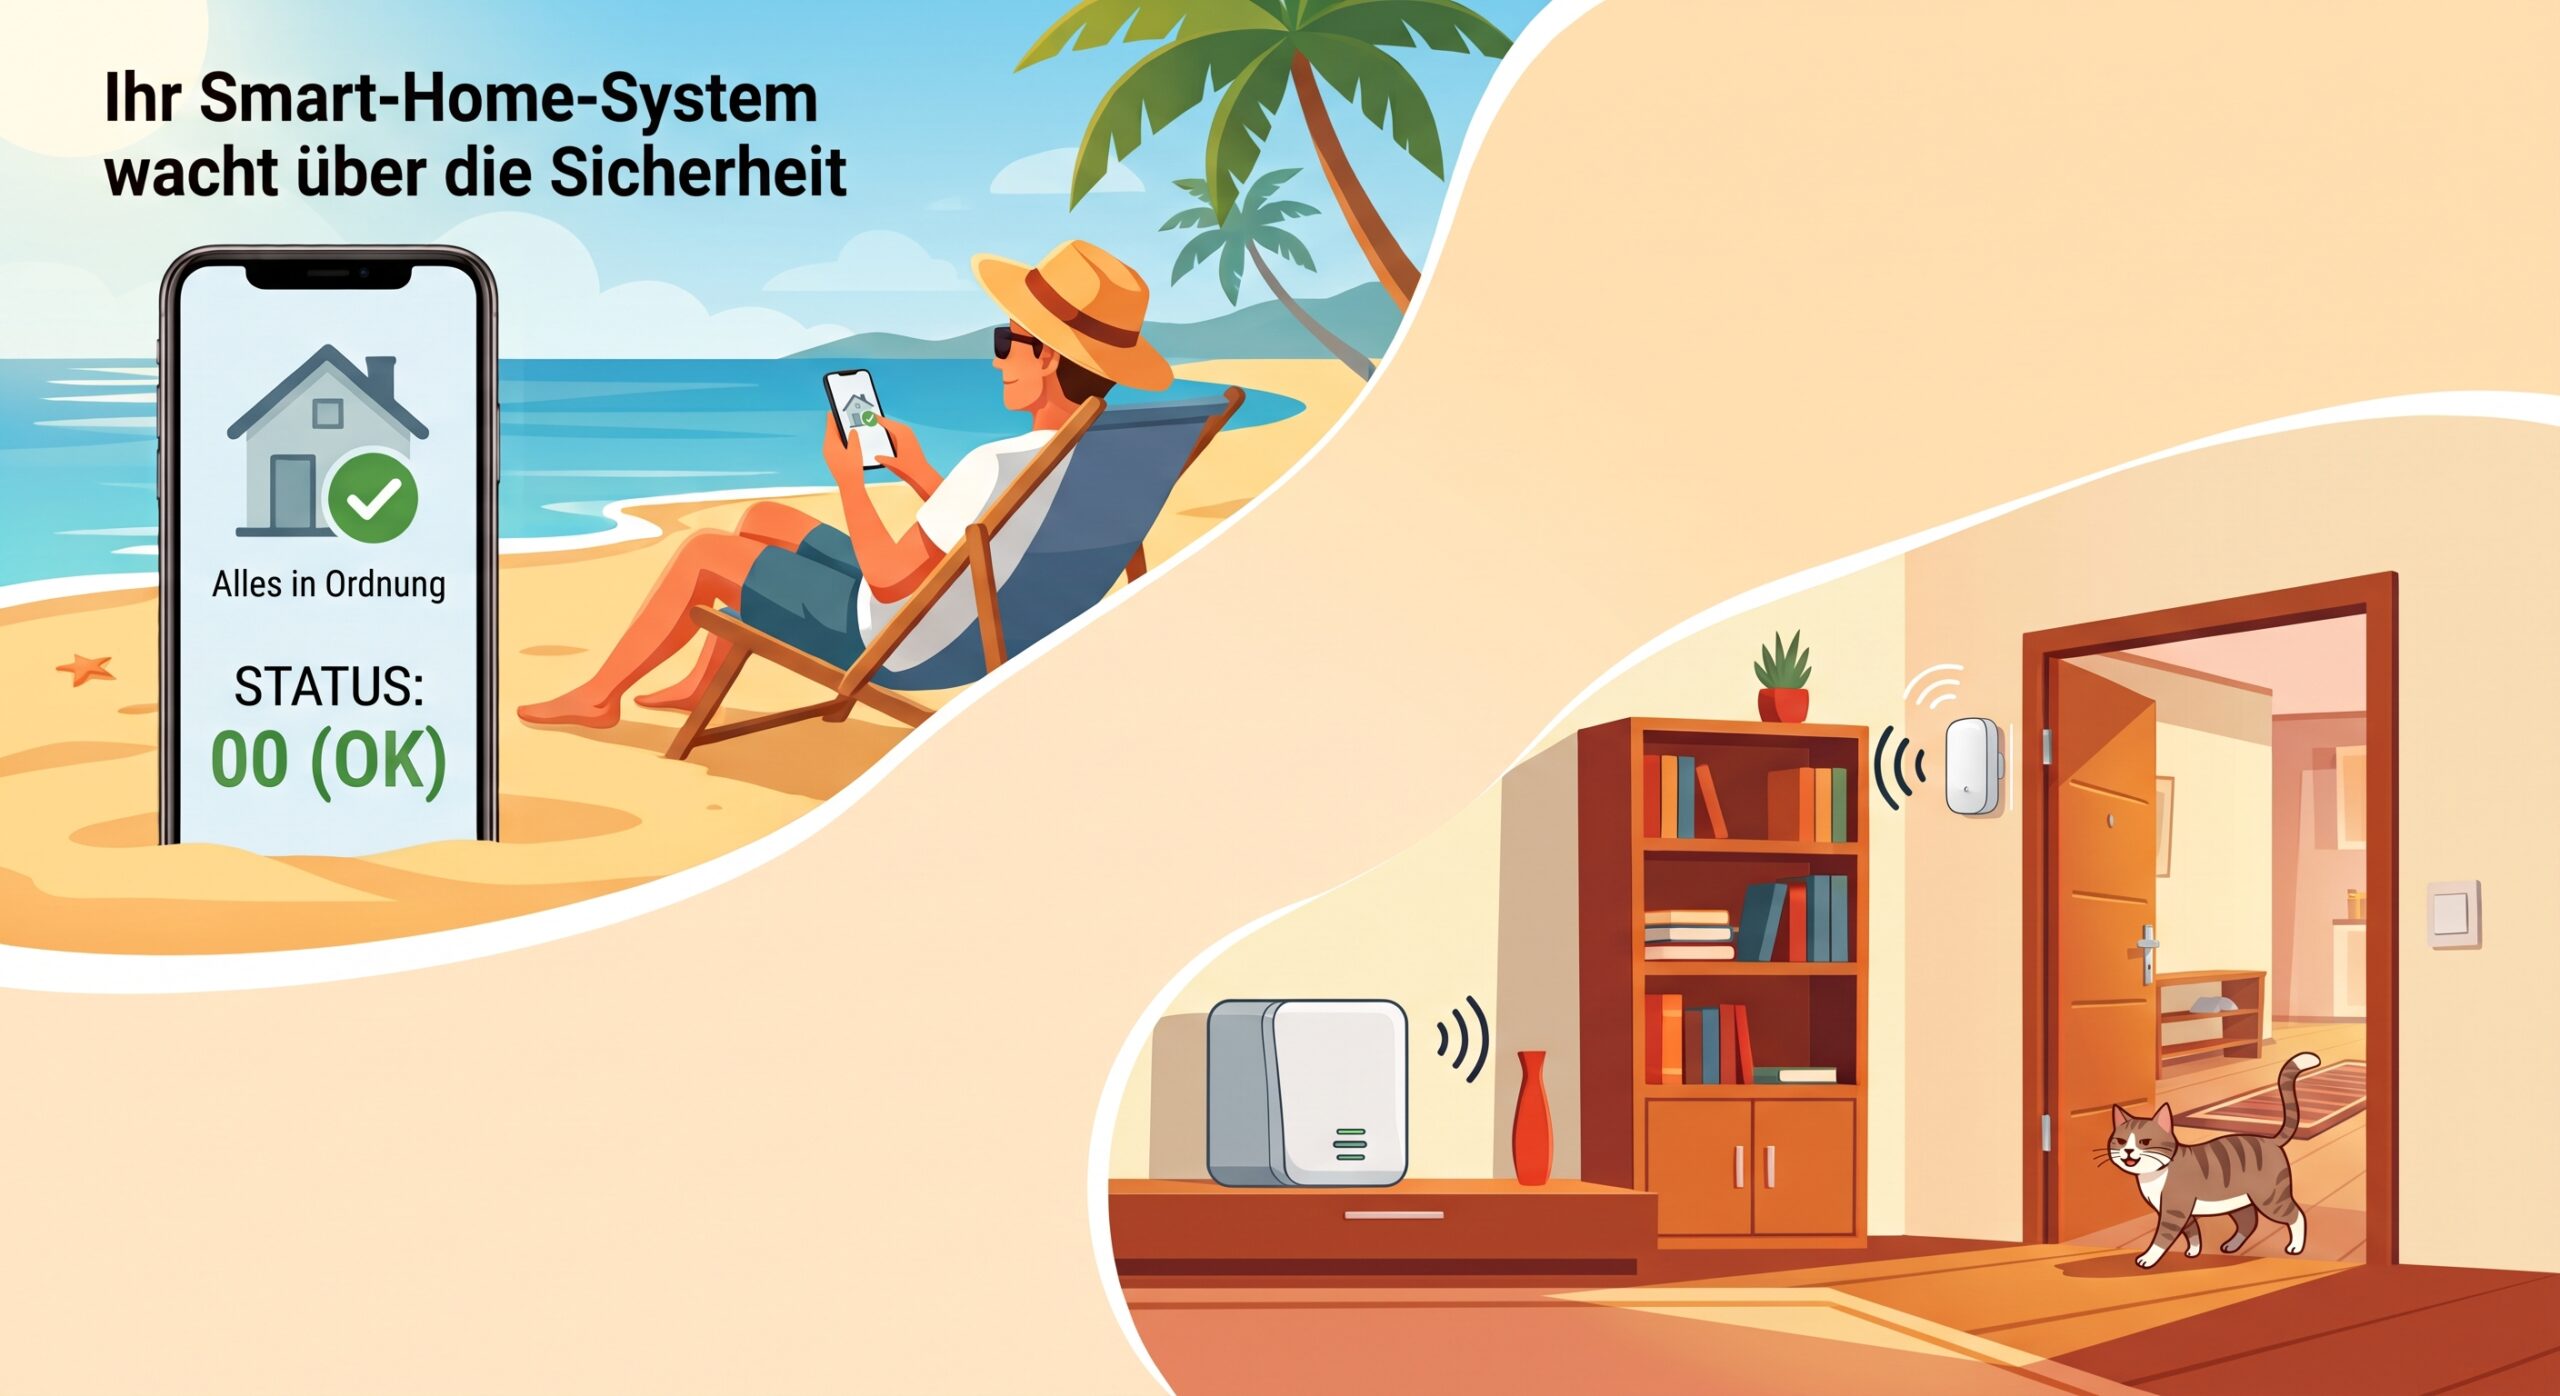
Stellen Sie sich vor, Sie befinden sich im Sommerurlaub am Strand, während Ihr neues Smart-Home-System zu Hause über die Sicherheit wacht. Der drahtlose Sicherheitssensor im Wohnzimmer sendet routinemäßig seinen Status an die Basisstation. Um Energie und Bandbreite zu sparen, verwendet das System einen 2-Bit-Code:
Der Störfall: Während Sie die Sonne genießen, löst ein vorbeifahrender Funkwagen in Ihrer Straße eine kurze elektromagnetische Störung aus. Genau in diesem Moment sendet der Sensor zu Hause den Status 10 („Tür geöffnet“, was auch in Ordnung ist, da die Katze durch das Haus gehen darf). Das Signal wird auf dem Funkweg gestört: Das rechte Bit kippt von 0 auf 1. Die Zentrale empfängt somit die Bitfolge 11.
Der (7,4)-Hammingcode
Der Repetitionscode hat eine sehr geringe Informationsrate und wird deshalb in der Praxis nicht verwendet. Es gibt fehlererkennende Codierungen mit einer deutlich höheren Informationsrate. Ein Beispiel ist der Hammingcode. Auf Grund der Visualisierungsmöglichkeit in einem Kreis-Modell werden Sie nun den (7,4)-Hammingcode kennenlernen. Der Code übermittelt jeweils Blöcke mit 7 Bit, wobei 4 Bit die Daten codieren und 3 Bit als Prüfbit hinzugefügt werden. In der Praxis werden z. B. der (63,57)-Hammingcode verwendet (s. z. B. Wikipedia).
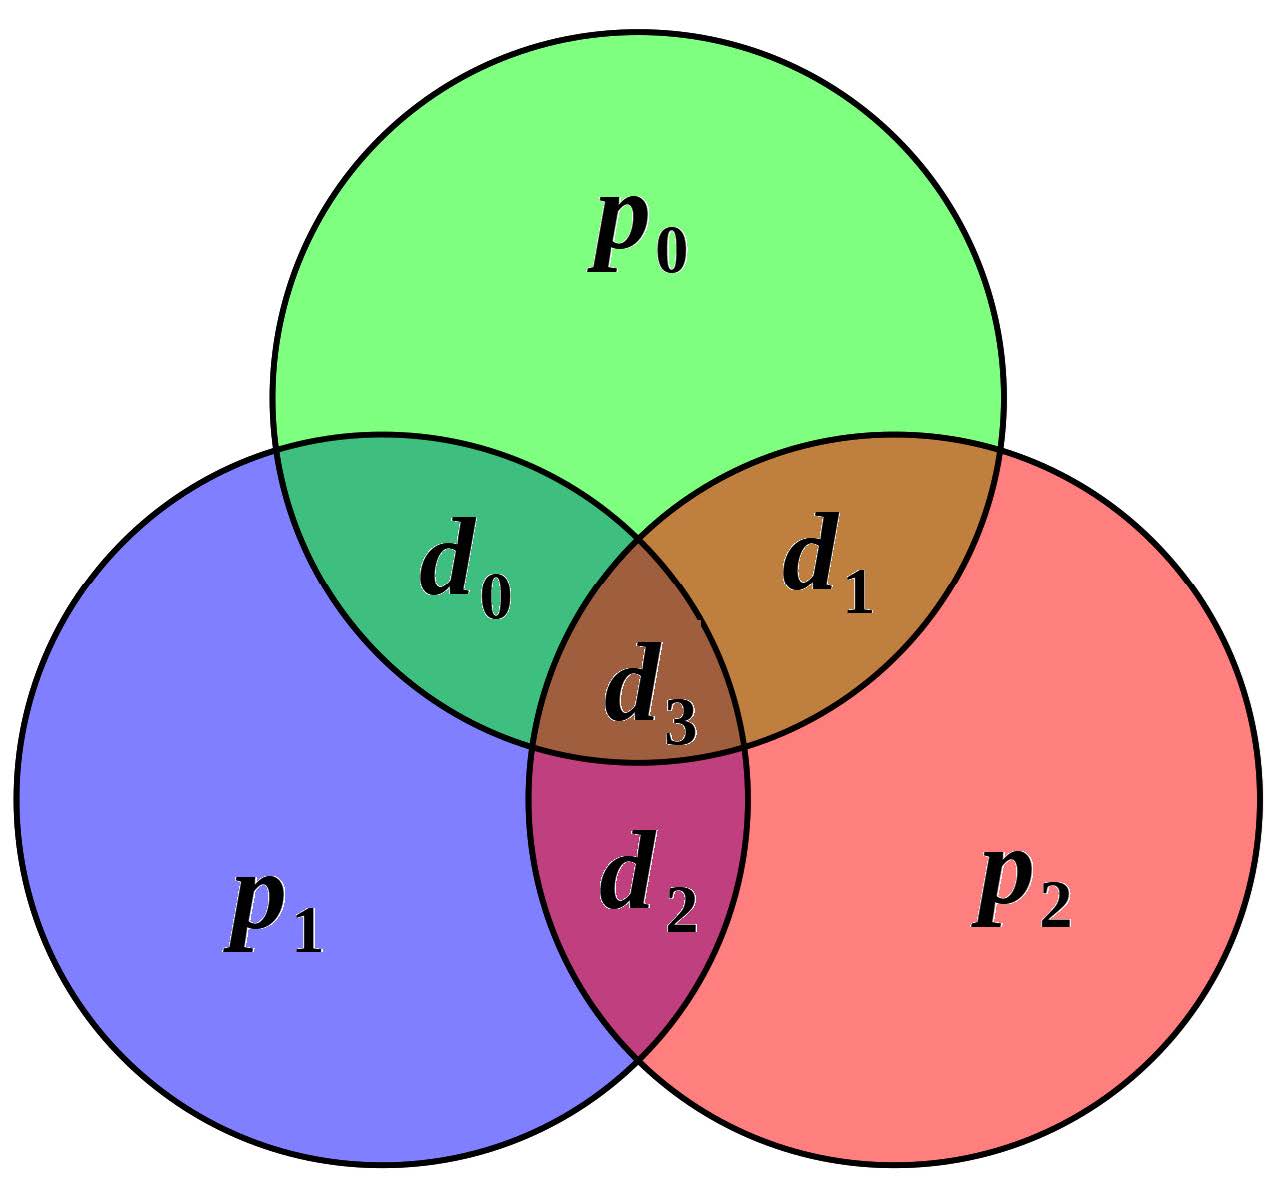
Die oben abgebildete Darstellung zeigt, wie sich die drei Prüfbit/Paritätsbit \(p_0\), \(p_1\) und \(p_2\) aus den vier Datenbit \(d_0\), \(d_1\), \(d_2\) und \(d_3\) zusammensetzen:
\(p_1 = d_0 + d_2 + d_3\)
\(p_2 = d_1 + d_2 + d_3\)
Die Addition ist eine binäre Addition, wobei der Übertrag nicht relevant ist. Bei einer ungeraden Anzahl Einsen ist demnach das entsprechende Prüfbit 1, ansonsten 0.
Es gilt also: \(0+0 = 0\), \(0+1 = 1+0 = 1\) und \(1+1 = 0\).
Die Codierung mit dem (7,4)-Hammingcode sieht dann wie folgt aus:
Man beachte, dass die Reihenfolge der Bit exakt festgelegt ist. So wird z. B. das Wort 1011, mit \(d_0 = 1\), \(d_1 = 0\), \(d_2 = 1\) und \(d_3 = 1\) wegen \(p_0 = 1+0+1 = \mathbf{\!\color{#000}{\bbox[#fca5a5, 2px]{0}}\!}\), \(p_1 = 1+1+1 = \mathbf{\!\color{#000}{\bbox[#fca5a5, 2px]{1}}\!}\) und \(p_2 = 0+1+1 = \mathbf{\!\color{#000}{\bbox[#fca5a5, 2px]{0}}\!}\) auf das Codewort 0110011 abgebildet.
Die drei Prüfbit sind Paritätsbit, die jeweils drei Datenbit zu einer geraden Parität ergänzen.
Für die Codierung von Zeichen können z. B. jeweils 8 Bit eines ASCII-Wertes in zwei Blöcke zu je 4 Bit aufgeteilt werden. Diese 4 Bit-Blöcke werden dann nach dem oben beschriebenen Verfahren codiert.